
197 lines
10 KiB
Markdown
197 lines
10 KiB
Markdown
---
|
||
frameworks:
|
||
- Pytorch
|
||
license: Apache License 2.0
|
||
tasks:
|
||
- text-generation
|
||
---
|
||
# 本模型论文解读,请看公众号文章 👇🏻
|
||
|
||
### <img src="https://www.modelscope.cn/datasets/okwinds/Human-Like-DPO-Dataset/resolve/master/wechat.png" width="30" height="30" align="absmiddle"> 觉察流 - [Satori 带来 COAT:解锁大语言模型自省及推理潜能,告别教师模型](https://mp.weixin.qq.com/s/hnqv6YE4Cca2_lrJm5vcxg)
|
||
|
||
> <span style="color:red;font-size:16px"> 声明:本模型完全转载自 Huggingface 上的 [Satori-reasoning/Satori-7B-Round2](https://huggingface.co/Satori-reasoning/Satori-7B-Round2) <br/>更多模型信息,请关注下文👇🏻, 为原数据集仓库的中文版说明。</span>
|
||
|
||
<br/>
|
||
|
||
#### _仓库作者在此 👇🏻 扫一扫_
|
||
|
||
<img src="https://www.modelscope.cn/models/okwinds/GPT-2/resolve/master/qrcode_for_jcl_258.jpg" />
|
||
|
||
# 下载方式
|
||
|
||
### 当前模型的贡献者未提供更加详细的模型介绍。模型文件和权重,可浏览“模型文件”页面获取。
|
||
#### 您可以通过如下git clone命令,或者ModelScope SDK来下载模型
|
||
|
||
SDK下载
|
||
```bash
|
||
#安装ModelScope
|
||
pip install modelscope
|
||
```
|
||
```python
|
||
#SDK模型下载
|
||
from modelscope import snapshot_download
|
||
model_dir = snapshot_download('okwinds/Satori-7B-Round2')
|
||
```
|
||
Git下载
|
||
```
|
||
#Git模型下载
|
||
git clone https://www.modelscope.cn/okwinds/Satori-7B-Round2.git
|
||
```
|
||
|
||
# 模型介绍
|
||
|
||
**Satori-7B-Round2** 是一个基于开源模型(Qwen-2.5-Math-7B)和开源数据(OpenMathInstruct-2 和 NuminaMath)训练的 7B 大型语言模型(LLM)。**Satori-7B-Round2** 能够进行自回归搜索,即在没有外部指导的情况下进行自我反思和自我探索。这是通过我们提出的 Chain-of-Action-Thought(COAT)推理方法和两阶段后训练范式实现的。
|
||
|
||
## 我们的方法
|
||
|
||
我们将 LLM 推理表述为一个序贯决策问题,推理是一个逐步构建和优化答案的过程。具体来说,LLM(代理的策略)从输入上下文(初始状态)开始,生成一个推理步骤(动作),并更新上下文(下一个状态)。LLM 重复这一过程,直到得出最终答案,并接收一个评估最终答案是否与真实答案匹配的奖励。通过这种表述,我们可以使用强化学习(RL)训练 LLM 推理,目标是生成一系列推理步骤,以最大化预期奖励。
|
||
|
||
### Chain-of-Action-Thought 推理(COAT)
|
||
|
||
实现自回归搜索的关键挑战是使 LLM 能够在没有外部干预的情况下确定何时进行反思、继续或探索替代解决方案。为此,我们引入了几个特殊的元动作标记,以引导 LLM 的推理过程:
|
||
|
||
- **继续推理**(<\|continue\|>):鼓励 LLM 在当前推理轨迹的基础上生成下一个中间步骤。
|
||
- **反思**(<\|reflect\|>):提示模型暂停并验证之前推理步骤的正确性。
|
||
- **探索替代解决方案**(<\|explore\|>):信号模型识别推理中的关键缺陷并探索新的解决方案。
|
||
|
||
我们将这种表述称为 Chain-of-Action-Thought(COAT)推理。每个 COAT 推理步骤是一个以其中一个元动作标记开头的标记序列。
|
||
|
||
### 训练框架概述
|
||
|
||
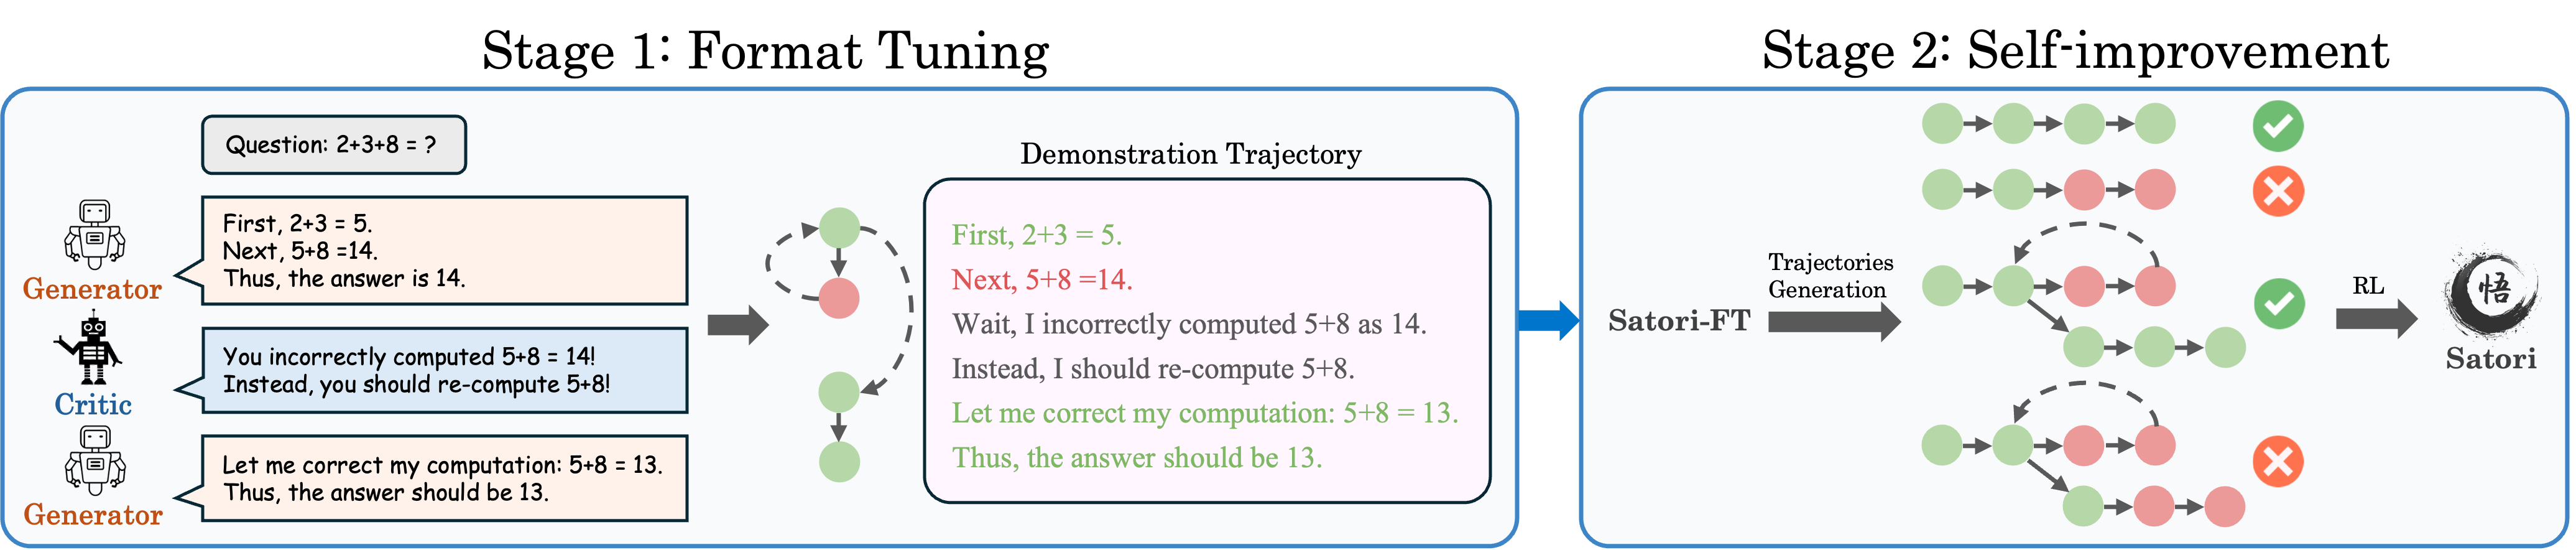
1. 一个小规模的格式调整(FT)阶段,帮助基础 LLM 内化 COAT 推理格式。
|
||
2. 一个大规模的自我提升阶段,利用强化学习和“重启和探索”(RAE)技术。
|
||
|
||
|
||
|
||
### 通过模仿学习进行格式调整
|
||
|
||
这一阶段的目标是微调预训练的基础 LLM,使其模仿一些具有 COAT 推理格式的推理轨迹。为了合成包含尝试和错误的 COAT 轨迹,我们提出了一个多智能体数据合成框架,利用三个 LLM:
|
||
|
||
- **生成器**:给定一个输入问题,生成器使用经典的 CoT 技术为给定输入问题生成多个推理路径。
|
||
- **评论家**:评论家评估生成器生成的推理路径的正确性,提供反馈以优化推理并解决次优步骤。
|
||
- **奖励模型**:奖励模型为优化后的推理路径分配分数,并选择最有效的路径作为最终演示轨迹。
|
||
|
||
这三个模型协作构建高质量的演示轨迹。我们观察到,少量(10K)的演示轨迹足以让基础 LLM 遵循 COAT 推理格式。
|
||
|
||
### 通过强化学习进行自我提升
|
||
|
||
通过格式调整,LLM 已经采用了 COAT 推理风格,但在未见过的问题上泛化能力不足。RL 阶段旨在激励利用自我反思来提高推理的实际能力。我们从格式调整后的 LLM 开始,并进一步使用经典的 PPO 算法进行优化,同时采用两个关键策略:
|
||
|
||
- **重启和探索(RAE)**:受 Go-Explore 的启发,我们训练 LLM 策略不仅从问题陈述开始推理,还从过去轨迹中采样的中间步骤开始推理,无论是正确的还是错误的。我们还添加了探索奖励,以鼓励更深入的反思,进一步增加策略得出正确答案的机会。
|
||
- **迭代自我提升**:策略可能会收敛到局部次优解,无法进一步改进。受 Kickstarting 的启发,每轮 RL 训练后,我们将当前教师策略的知识通过监督微调蒸馏到学生模型(基础 LLM)中。从新微调的 LLM 开始,我们再进行一轮 RL 训练。
|
||
|
||
**Satori-7B-Round2** 是通过第二轮迭代自我提升获得的。
|
||
|
||
## 使用方法
|
||
|
||
```python
|
||
import os
|
||
from tqdm import tqdm
|
||
import torch
|
||
from vllm import LLM, SamplingParams
|
||
|
||
def generate(question_list, model_path):
|
||
llm = LLM(
|
||
model=model_path,
|
||
trust_remote_code=True,
|
||
tensor_parallel_size=1,
|
||
)
|
||
sampling_params = SamplingParams(
|
||
max_tokens=4096,
|
||
temperature=0.0,
|
||
n=1,
|
||
skip_special_tokens=True # 隐藏special tokens,如 "<\|continue\|>"、"<\|reflect\|>" 和 "<\|explore\|>"
|
||
)
|
||
outputs = llm.generate(question_list, sampling_params, use_tqdm=True)
|
||
completions = [[output.text for output in output_item.outputs] for output_item in outputs]
|
||
return completions
|
||
|
||
def prepare_prompt(question):
|
||
prompt = f"<|im_start|>user\n高效且清晰地解决以下数学问题。\n请逐步推理,并将最终答案放在 \\boxed{{}} 中。\n问题: {question}<|im_end|>\n<|im_start|>assistant\n"
|
||
return prompt
|
||
|
||
def run():
|
||
model_path = "Satori-reasoning/Satori-7B-Round2"
|
||
all_problems = [
|
||
"哪个数字更大?9.11 还是 9.9?",
|
||
]
|
||
completions = generate(
|
||
[prepare_prompt(problem_data) for problem_data in all_problems],
|
||
model_path
|
||
)
|
||
|
||
for completion in completions:
|
||
print(completion[0])
|
||
|
||
if __name__ == "__main__":
|
||
run()
|
||
```
|
||
|
||
## 基准测试性能
|
||
|
||
**Satori-7B-Round2** 在领域内推理基准(数学推理)和领域外基准(一般推理任务)上进行了评估。所有结果均报告为零样本 pass@1 准确率,使用贪婪采样。
|
||
|
||
### 评估任务
|
||
|
||
- **数学推理基准**:GSM8K、MATH500、AMC2023、AIME2024 和 OlympiadBench。除了 GSM8K,所有其他数据集都包含竞赛级别的问题。
|
||
- **一般领域推理基准**:
|
||
- 逻辑推理:FOLIO、BoardgameQA(BGQA)。
|
||
- 代码推理:CRUXEval。
|
||
- 常识推理:StrategyQA(STGQA)。
|
||
- 表格推理:TableBench。
|
||
- 特定领域推理:MMLUPro STEM 子集(STEM),包括物理、化学、计算机科学、工程、生物学和经济学。
|
||
|
||
### 数学推理基准
|
||
|
||
**Satori-7B-Round2** 实现了 SOTA 性能,并且优于使用相同基础模型(Qwen-2.5-Math-7B)的 Qwen-2.5-Math-7B-Instruct。
|
||
|
||
| 规模 | 模型 | GSM8K | MATH500 | OlymBench | AMC2023 | AIME2024 | 平均值 |
|
||
| --- | --- | --- | --- | --- | --- | --- | --- |
|
||
| **大型** | Llama-3.1-70B-Instruct | 94.1 | 68.0 | 29.4 | 42.5 | 13.3 | 49.5 |
|
||
| | OpenMath2-Llama3.1-70B | 94.1 | 71.8 | 30.1 | 45.0 | 13.3 | 50.9 |
|
||
| | QwQ-32B-Preview | 95.5 | 90.6 | 61.2 | 77.5 | 50.0 | 75.0 |
|
||
| **小型** | Llama-3.1-8b-Instruct | 84.4 | 51.9 | 15.1 | 22.5 | 3.3 | 35.4 |
|
||
| | OpenMath2-Llama3.1-8B | 90.5 | 67.8 | 28.9 | 37.5 | 6.7 | 46.3 |
|
||
| | NuminaMath-7B-CoT | 78.9 | 54.6 | 15.9 | 20.0 | 10.0 | 35.9 |
|
||
| | Qwen-2.5-7B-Instruct | 91.6 | 75.5 | 35.5 | 52.5 | 6.7 | 52.4 |
|
||
| | Qwen-2.5-Math-7B-Instruct | 95.2 | 83.6 | 41.6 | 62.5 | 16.7 | 59.9 |
|
||
| | **Satori-7B-Round2** | 93.9 | 83.6 | 48.5 | 72.5 | 23.3 | **64.4** |
|
||
|
||
### 一般领域推理基准
|
||
|
||
仅在数学数据集上训练的 **Satori-7B-Round2** 在多种领域外推理基准上表现出强大的迁移能力,并且大幅超越了 Qwen-2.5-Math-7B-Instruct。此外,尽管未在其他领域进行训练,**Satori-7B-Round2** 的性能与或超过了其他小型通用指令模型。
|
||
|
||
| 规模 | 模型 | FOLIO | BGQA | CRUXEval | StrategyQA | TableBench | STEM | 平均值 |
|
||
| --- | --- | --- | --- | --- | --- | --- | --- | --- |
|
||
| **大型** | Llama-3.1-70B-Instruct | 65.0 | 58.3 | 59.6 | 88.8 | 34.2 | 61.7 | 61.3 |
|
||
| | OpenMath2-Llama3.1-70B | 68.5 | 68.7 | 35.1 | 95.6 | 46.8 | 15.1 | 55.0 |
|
||
| | QwQ-32B-Preview | 84.2 | 71.1 | 65.2 | 88.2 | 51.5 | 71.3 | 71.9 |
|
||
| **小型** | Llama-3.1-8b-Instruct | 63.5 | 50.3 | 38.5 | 92.2 | 32.4 | 43.4 | 53.4 |
|
||
| | OpenMath2-Llama3.1-8B | 57.1 | 49.0 | 11.1 | 84.4 | 34.2 | 10.9 | 41.1 |
|
||
| | NuminaMath-7B-CoT | 53.2 | 44.6 | 28.0 | 77.8 | 29.1 | 11.3 | 40.7 |
|
||
| | Qwen-2.5-7B-Instruct | 72.4 | 53.0 | 58.1 | 91.3 | 43.2 | 57.1 | **62.5** |
|
||
| | Qwen-2.5-Math-7B-Instruct | 68.9 | 51.3 | 28.0 | 85.3 | 36.2 | 45.2 | 52.5 |
|
||
| | **Satori-7B-Round2** | 72.9 | 58.5 | 41.1 | 90.4 | 44.6 | 57.4 | **60.8** |
|
||
|
||
## 资源
|
||
|
||
我们提供了我们的训练数据集:
|
||
|
||
- 包含 300K 个唯一问题的完整格式调整数据集。 [okwinds/Satori_FT_data](https://modelscope.cn/datasets/okwinds/Satori_FT_data)
|
||
- 包含 550K 个唯一问题的 RL 数据集。 [okwinds/Satori_RL_data](https://modelscope.cn/datasets/okwinds/Satori_RL_data)
|
||
|
||
## 引用
|
||
|
||
如果您觉得我们的模型和数据有帮助,请引用我们的论文:
|
||
|
||
```
|
||
@misc{shen2025satorireinforcementlearningchainofactionthought,
|
||
title={Satori: Reinforcement Learning with Chain-of-Action-Thought Enhances LLM Reasoning via Autoregressive Search},
|
||
author={Maohao Shen and Guangtao Zeng and Zhenting Qi and Zhang-Wei Hong and Zhenfang Chen and Wei Lu and Gregory Wornell and Subhro Das and David Cox and Chuang Gan},
|
||
year={2025},
|
||
eprint={2502.02508},
|
||
archivePrefix={arXiv},
|
||
primaryClass={cs.CL},
|
||
url={https://arxiv.org/abs/2502.02508},
|
||
}
|
||
``` |