初始化项目,由ModelHub XC社区提供模型
Model: meituan/EvoCUA-8B-20260105
Source: Original Platform
This commit is contained in:
 ModelHub XC
59
.gitattributes
vendored
Normal file
59
.gitattributes
vendored
Normal file
@@ -0,0 +1,59 @@
|
||||
*.7z filter=lfs diff=lfs merge=lfs -text
|
||||
*.arrow filter=lfs diff=lfs merge=lfs -text
|
||||
*.bin filter=lfs diff=lfs merge=lfs -text
|
||||
*.bin.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.bz2 filter=lfs diff=lfs merge=lfs -text
|
||||
*.ftz filter=lfs diff=lfs merge=lfs -text
|
||||
*.gz filter=lfs diff=lfs merge=lfs -text
|
||||
*.h5 filter=lfs diff=lfs merge=lfs -text
|
||||
*.joblib filter=lfs diff=lfs merge=lfs -text
|
||||
*.lfs.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.model filter=lfs diff=lfs merge=lfs -text
|
||||
*.msgpack filter=lfs diff=lfs merge=lfs -text
|
||||
*.onnx filter=lfs diff=lfs merge=lfs -text
|
||||
*.ot filter=lfs diff=lfs merge=lfs -text
|
||||
*.parquet filter=lfs diff=lfs merge=lfs -text
|
||||
*.pb filter=lfs diff=lfs merge=lfs -text
|
||||
*.pt filter=lfs diff=lfs merge=lfs -text
|
||||
*.pth filter=lfs diff=lfs merge=lfs -text
|
||||
*.rar filter=lfs diff=lfs merge=lfs -text
|
||||
saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
||||
*.tar.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.tflite filter=lfs diff=lfs merge=lfs -text
|
||||
*.tgz filter=lfs diff=lfs merge=lfs -text
|
||||
*.xz filter=lfs diff=lfs merge=lfs -text
|
||||
*.zip filter=lfs diff=lfs merge=lfs -text
|
||||
*.zstandard filter=lfs diff=lfs merge=lfs -text
|
||||
*.tfevents* filter=lfs diff=lfs merge=lfs -text
|
||||
*.db* filter=lfs diff=lfs merge=lfs -text
|
||||
*.ark* filter=lfs diff=lfs merge=lfs -text
|
||||
**/*ckpt*data* filter=lfs diff=lfs merge=lfs -text
|
||||
**/*ckpt*.meta filter=lfs diff=lfs merge=lfs -text
|
||||
**/*ckpt*.index filter=lfs diff=lfs merge=lfs -text
|
||||
|
||||
*.ckpt filter=lfs diff=lfs merge=lfs -text
|
||||
*.gguf* filter=lfs diff=lfs merge=lfs -text
|
||||
*.ggml filter=lfs diff=lfs merge=lfs -text
|
||||
*.llamafile* filter=lfs diff=lfs merge=lfs -text
|
||||
*.pt2 filter=lfs diff=lfs merge=lfs -text
|
||||
*.mlmodel filter=lfs diff=lfs merge=lfs -text
|
||||
*.npy filter=lfs diff=lfs merge=lfs -text
|
||||
*.npz filter=lfs diff=lfs merge=lfs -text
|
||||
*.pickle filter=lfs diff=lfs merge=lfs -text
|
||||
*.pkl filter=lfs diff=lfs merge=lfs -text
|
||||
*.tar filter=lfs diff=lfs merge=lfs -text
|
||||
*.wasm filter=lfs diff=lfs merge=lfs -text
|
||||
*.zst filter=lfs diff=lfs merge=lfs -text
|
||||
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
||||
|
||||
vocab.json filter=lfs diff=lfs merge=lfs -text
|
||||
model-00002-of-00004.safetensors filter=lfs diff=lfs merge=lfs -text
|
||||
merges.txt filter=lfs diff=lfs merge=lfs -text
|
||||
model-00001-of-00004.safetensors filter=lfs diff=lfs merge=lfs -text
|
||||
tokenizer.json filter=lfs diff=lfs merge=lfs -text
|
||||
model-00004-of-00004.safetensors filter=lfs diff=lfs merge=lfs -text
|
||||
model-00003-of-00004.safetensors filter=lfs diff=lfs merge=lfs -text
|
||||
|
||||
tech_report.pdf filter=lfs diff=lfs merge=lfs -text
|
||||
|
||||
assets/images/animation_show_case.gif filter=lfs diff=lfs merge=lfs -text
|
||||
250
README.md
Normal file
250
README.md
Normal file
@@ -0,0 +1,250 @@
|
||||
---
|
||||
license: apache-2.0
|
||||
language:
|
||||
- en
|
||||
- zh
|
||||
tags:
|
||||
- computer-use
|
||||
- gui-agent
|
||||
- osworld
|
||||
- multimodal
|
||||
---
|
||||
|
||||
<div align="center">
|
||||
|
||||
# EvoCUA: Evolving Computer Use Agent
|
||||
|
||||
**🥇 #1 Open-Source Model on OSWorld | A General-Purpose Multimodal Model Excelling at Computer Use**
|
||||
|
||||
[](https://huggingface.co/meituan/EvoCUA-32B-20260105)
|
||||
[](https://huggingface.co/meituan/EvoCUA-8B-20260105)
|
||||
[](https://os-world.github.io/)
|
||||
[](./LICENSE)
|
||||
|
||||
[English](./README.md) | [中文](./README_CN.md)
|
||||
|
||||
<img src="assets/images/osworld_leaderboard.png" width="700" alt="OSWorld Leaderboard">
|
||||
|
||||
**🥇 #1 Open-Source Model on OSWorld Leaderboard (Jan 2026)**
|
||||
|
||||
</div>
|
||||
|
||||
---
|
||||
|
||||
## 📢 Updates
|
||||
- **2026.03.31**: EvoCUA-32B achieves **56.48%** on WindowsAgentArena (WAA), surpassing the base model Qwen3-VL-32B-Thinking (42.9%) by ~13.6 points and UI-TARS-2 (50.6%) by ~6 points — demonstrating strong zero-shot cross-OS generalization 🆕
|
||||
- **2026.03.31**: Independent safety study by Yoshua Bengio & Dawn Song's teams ([arXiv:2602.08235](https://arxiv.org/abs/2602.08235)) shows **EvoCUA-32B has the lowest unintended-behavior rate (35.0%)** among all tested CUAs — the safest agent! 🆕
|
||||
- **2026.01.23**: EvoCUA ranked **#1** on [Hugging Face Daily Papers](https://huggingface.co/papers/2601.15876) 🏆
|
||||
- **2026.01.22**: Released [EvoCUA Technical Report](./tech_report.pdf) 📄
|
||||
- **2026.01.13**: Released [EvoCUA-8B-20260105](https://huggingface.co/meituan/EvoCUA-8B-20260105) — achieves **46.1%** on OSWorld, **competitive with 72B-level models using fewer parameters!**
|
||||
- **2026.01.05**: Released [EvoCUA-32B-20260105](https://huggingface.co/meituan/EvoCUA-32B-20260105) with **56.7%** on OSWorld, achieving **#1** among open-source models 🥇
|
||||
|
||||
---
|
||||
|
||||
## 🌟 Highlights
|
||||
|
||||
- 🥇 **#1 Open-Source Model on OSWorld**: Achieves **56.7%** task completion rate, **#1 among all open-source models**
|
||||
- 📈 **Significant Improvements**: +11.7% over OpenCUA-72B (45.0%→56.7%), +15.1% over Qwen3-VL thinking (41.6%→56.7%), with fewer parameters and half the steps
|
||||
- 🖥️ **End-to-End Multi-Turn Automation**: Operates Chrome, Excel, PowerPoint, VSCode and more through screenshots and natural language instructions
|
||||
- 🧠 **Novel Training Method**: Our data synthesis and training approach consistently improves Computer Use capability across multiple open-source VLMs without degrading general performance
|
||||
|
||||
---
|
||||
|
||||
## 📊 Performance Comparison
|
||||
|
||||
| Rank | Model | Open/Closed | Type | Max Steps | Score |
|
||||
|------|-------|-------------|------|-----------|-------|
|
||||
| 1 | Claude-sonnet-4-5 | 🔒 Closed | General | 100 | 62.9% |
|
||||
| 2 | Seed-1.8 | 🔒 Closed | General | 100 | 61.9% |
|
||||
| 3 | Claude-sonnet-4-5 | 🔒 Closed | General | 50 | 58.1% |
|
||||
| **4** | **EvoCUA-20260105 (Ours)** | **🟢 Open** | **General** | **50** | **56.7% 🥇** |
|
||||
| 5 | DeepMiner-Mano-72B | 🔒 Closed | Specialized | 100 | 53.9% |
|
||||
| 6 | UI-TARS-2-2509 | 🔒 Closed | General | 100 | 53.1% |
|
||||
| 7 | EvoCUA (Previous Version) | 🔒 Closed | General | 50 | 50.3% |
|
||||
| **8** | **EvoCUA-8B-20260105 (Ours)** | **🟢 Open** | **General** | **50** | **46.1%** |
|
||||
| 9 | OpenCUA-72B | 🟢 Open | Specialized | 100 | 45.0% |
|
||||
| ... | ... | ... | ... | ... | ... |
|
||||
| 13 | Qwen3-VL-Flash | 🔒 Closed | General | 100 | 41.6% |
|
||||
|
||||
> EvoCUA is **#1 among all open-source models**, achieving competitive results with only **50 steps**. Human-level performance remains significantly higher, indicating substantial room for improvement.
|
||||
|
||||
### Zero-shot Cross-OS Control (WindowsAgentArena)
|
||||
|
||||
We evaluated EvoCUA on [WindowsAgentArena (WAA)](https://microsoft.github.io/WindowsAgentArena/) to test generalization from the Linux-based training environment to a wholly different OS platform. As shown below, EvoCUA-32B reaches **56.48%**, surpassing the base model Qwen3-VL-32B-Thinking (42.9%) by ~13.6 points and the leading frontier GUI agent UI-TARS-2 (50.6%) by nearly **6 points**.
|
||||
|
||||
| Model | WAA |
|
||||
|-------|-----|
|
||||
| Qwen3-VL-32B-Instruct | 30.9% [1] |
|
||||
| Qwen3-VL-32B-Thinking (Base) | 42.9% [1] |
|
||||
| UI-TARS-2 | 50.6% [2] |
|
||||
| **EvoCUA-32B (Ours)** | **56.48%** |
|
||||
|
||||
> [1] Bai et al., *Qwen3-VL Technical Report* (arXiv:2511.21631, 2025).
|
||||
> [2] Wang et al., *UI-TARS-2 Technical Report* (arXiv:2509.02544, 2025).
|
||||
|
||||
### Safety — Robustness to Unintended Behaviors
|
||||
|
||||
A recent study by [Jones et al. (2026)](https://arxiv.org/abs/2602.08235) from Yoshua Bengio and Dawn Song's teams systematically evaluated the safety of leading CUAs. They transferred 117 human-verified perturbations (benign but tricky instructions) to multiple target agents, executing each instruction 3 times and reporting the percentage that elicits unintended behavior in ≥ 1 run. **EvoCUA-32B achieves the lowest overall rate (35.0%)**, demonstrating the strongest robustness among all tested CUAs.
|
||||
|
||||
<details>
|
||||
<summary><b>Transferability Study Results (Table 2 from the paper)</b></summary>
|
||||
|
||||
| Target Agent | Claude 4.5 Haiku | Claude 4.5 Opus | Overall |
|
||||
|---|---|---|---|
|
||||
| **Open-Source CUAs** | | | |
|
||||
| EvoCUA-8B | 20.0 | 50.7 | 37.6 |
|
||||
| **EvoCUA-32B (Ours)** | **24.0** | **43.3** | **35.0 🥇** |
|
||||
| OpenCUA-7B | 42.0 | 50.7 | 47.0 |
|
||||
| OpenCUA-32B | 42.0 | 44.8 | 43.6 |
|
||||
| OpenCUA-72B | 50.0 | 56.7 | 53.8 |
|
||||
| **Closed-Source CUAs** | | | |
|
||||
| Claude 4.5 Sonnet | 32.0 | 47.8 | 41.0 |
|
||||
| Operator | 38.0 | 56.7 | 48.7 |
|
||||
|
||||
> *Lower is safer.* EvoCUA-32B has the lowest overall unintended-behavior rate among all tested agents.
|
||||
|
||||
</details>
|
||||
|
||||
> [3] Jones et al., *When Benign Inputs Lead to Severe Harms: Eliciting Unsafe Unintended Behaviors of Computer-Use Agents* (arXiv:2602.08235, 2026).
|
||||
|
||||
---
|
||||
|
||||
## 🚀 Quick Start
|
||||
|
||||
### Installation
|
||||
|
||||
Python 3.12 is recommended.
|
||||
|
||||
```bash
|
||||
git clone https://github.com/meituan/EvoCUA.git
|
||||
cd EvoCUA
|
||||
python3 -m venv .venv
|
||||
source .venv/bin/activate
|
||||
pip install -r requirements.txt
|
||||
```
|
||||
|
||||
### Model Download & Deployment
|
||||
|
||||
EvoCUA requires downloading the model weights from HuggingFace and deploying with **vLLM** as an OpenAI-compatible inference server.
|
||||
|
||||
Recommended versions:
|
||||
- torch: 2.8.0+cu126
|
||||
- transformers: 4.57.3
|
||||
- vllm: 0.11.0
|
||||
|
||||
```bash
|
||||
# 1) Download model weights
|
||||
huggingface-cli download meituan/EvoCUA-32B-20260105 \
|
||||
--local-dir /path/to/EvoCUA-32B \
|
||||
--local-dir-use-symlinks False
|
||||
|
||||
# 2) Launch vLLM serving (recommend separate environment)
|
||||
vllm serve /path/to/EvoCUA-32B \
|
||||
--served-model-name EvoCUA \
|
||||
--host 0.0.0.0 \
|
||||
--port 8080 \
|
||||
--tensor-parallel-size 2
|
||||
|
||||
# 3) Set environment variables
|
||||
# Environment variables can be configured in .env file (see env.template for reference):
|
||||
cp env.template .env
|
||||
# Edit .env with your configurations, e.g.,
|
||||
export OPENAI_API_KEY="dummy"
|
||||
export OPENAI_BASE_URL="http://127.0.0.1:8080/v1"
|
||||
```
|
||||
|
||||
### Run Evaluation on OSWorld
|
||||
|
||||
```bash
|
||||
python3 run_multienv_evocua.py \
|
||||
--headless \
|
||||
--provider_name aws \
|
||||
--observation_type screenshot \
|
||||
--model EvoCUA-S2 \
|
||||
--result_dir ./evocua_results \
|
||||
--test_all_meta_path evaluation_examples/test_nogdrive.json \
|
||||
--max_steps 50 \
|
||||
--num_envs 30 \
|
||||
--temperature 0.01 \
|
||||
--max_history_turns 4 \
|
||||
--coordinate_type relative \
|
||||
--resize_factor 32 \
|
||||
--prompt_style S2
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 📁 Project Structure
|
||||
|
||||
```
|
||||
EvoCUA/
|
||||
├── run_multienv_evocua.py # Main entry point (multi-env parallel evaluation)
|
||||
├── lib_run_single.py # Single task rollout logic (trajectory, screenshots, recording, scoring)
|
||||
├── lib_results_logger.py # Real-time result aggregation to results.json
|
||||
├── desktop_env/ # OSWorld environment implementation
|
||||
│ ├── providers/ # VM providers (AWS/VMware/Docker/etc.)
|
||||
│ ├── controllers/ # Environment controllers
|
||||
│ └── evaluators/ # Task evaluators
|
||||
├── mm_agents/
|
||||
│ └── evocua/ # EvoCUA agent (prompts, parsing, action generation)
|
||||
└── evaluation_examples/ # OSWorld task configurations
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
|
||||
## 📖 About OSWorld
|
||||
|
||||
[OSWorld](https://os-world.github.io/) is the most influential benchmark in the Computer Use Agent domain. It is adopted by leading AI organizations including **OpenAI, Anthropic, ByteDance Seed, Moonshot AI, Zhipu AI, Step**, and more. OSWorld evaluates agents' ability to complete real-world computer tasks through multi-turn interactions with actual desktop environments.
|
||||
|
||||
---
|
||||
|
||||
## 🔗 Resources
|
||||
|
||||
- 🤗 **Model Weights**:
|
||||
- [meituan/EvoCUA-32B-20260105](https://huggingface.co/meituan/EvoCUA-32B-20260105) - OSWorld Score: **56.7%** 🥇
|
||||
- [meituan/EvoCUA-8B-20260105](https://huggingface.co/meituan/EvoCUA-8B-20260105) - OSWorld Score: **46.06%** 🆕
|
||||
- 📊 **OSWorld Benchmark**: [os-world.github.io](https://os-world.github.io/)
|
||||
- 📄 **Technical Report**: [tech_report.pdf](./tech_report.pdf)
|
||||
- 🚀 **More Model Sizes**: More models of various sizes are on the way!
|
||||
|
||||
---
|
||||
|
||||
## 🙏 Acknowledgements
|
||||
|
||||
We sincerely thank the open-source community for their outstanding contributions to the Computer Use Agent field. We are grateful to **Xinyuan Wang** ([OpenCUA](https://github.com/xlang-ai/OpenCUA)) and **Tianbao Xie** ([OSWorld](https://github.com/xlang-ai/OSWorld)) for their insightful discussions, valuable feedback on evaluation, and continuous support throughout this project. Their pioneering work has greatly inspired and advanced our research. We are committed to giving back to the community and will continue to open-source our research to advance the field.
|
||||
|
||||
---
|
||||
|
||||
## 📝 Citation
|
||||
|
||||
If you find EvoCUA useful in your research, please consider citing:
|
||||
|
||||
```bibtex
|
||||
@article{xue2026evocua,
|
||||
title={EvoCUA: Evolving Computer Use Agents via Learning from Scalable Synthetic Experience},
|
||||
author={Xue, Taofeng and Peng, Chong and Huang, Mianqiu and Guo, Linsen and Han, Tiancheng and Wang, Haozhe and Wang, Jianing and Zhang, Xiaocheng and Yang, Xin and Zhao, Dengchang and others},
|
||||
journal={arXiv preprint arXiv:2601.15876},
|
||||
year={2026}
|
||||
}
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 📜 License
|
||||
|
||||
This project is licensed under the Apache 2.0 License - see the [LICENSE](./LICENSE) file for details.
|
||||
|
||||
---
|
||||
|
||||
## 📈 Star Growth
|
||||
[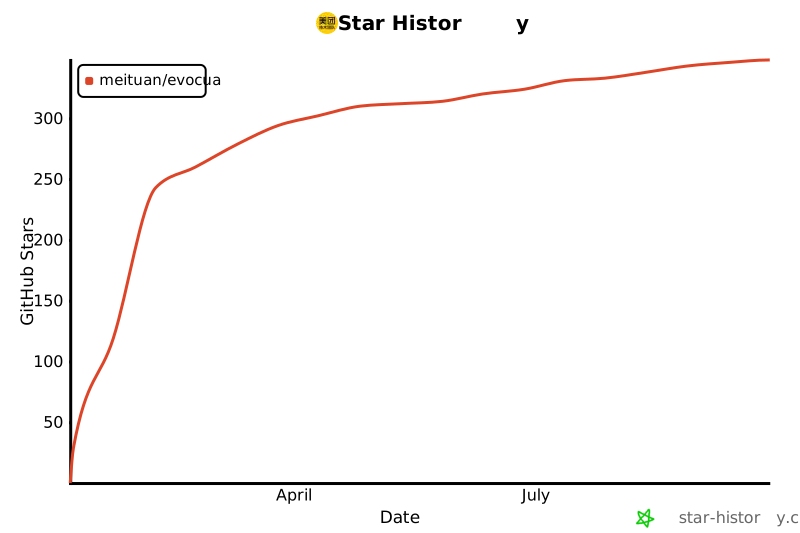](https://star-history.com/#meituan/EvoCUA&Date)
|
||||
|
||||
---
|
||||
|
||||
<div align="center">
|
||||
|
||||
**Built with ❤️ by Meituan LongCat Team**
|
||||
|
||||
</div>
|
||||
|
||||
245
README_CN.md
Normal file
245
README_CN.md
Normal file
@@ -0,0 +1,245 @@
|
||||
<div align="center">
|
||||
|
||||
# EvoCUA: Evolving Computer Use Agent
|
||||
|
||||
**🥇 OSWorld 开源模型 No.1 | 擅长计算机操作的通用多模态大模型**
|
||||
|
||||
[](https://huggingface.co/meituan/EvoCUA-32B-20260105)
|
||||
[](https://huggingface.co/meituan/EvoCUA-8B-20260105)
|
||||
[](https://os-world.github.io/)
|
||||
[](./LICENSE)
|
||||
|
||||
[English](./README.md) | [中文](./README_CN.md)
|
||||
|
||||
<img src="assets/images/osworld_leaderboard.png" width="700" alt="OSWorld Leaderboard">
|
||||
|
||||
**🥇 开源模型第一 | OSWorld 排行榜(2026年1月)**
|
||||
|
||||
</div>
|
||||
|
||||
---
|
||||
|
||||
## 📢 更新日志
|
||||
- **2026.03.31**:EvoCUA-32B 在 WindowsAgentArena (WAA) 上取得 **56.48%**,超越基线模型 Qwen3-VL-32B-Thinking(42.9%)约 13.6 个百分点,超越 UI-TARS-2(50.6%)约 6 个百分点——展现出强大的零样本跨操作系统泛化能力 🆕
|
||||
- **2026.03.31**:Yoshua Bengio 与 Dawn Song 团队的独立安全性研究([arXiv:2602.08235](https://arxiv.org/abs/2602.08235))表明 **EvoCUA-32B 的非预期行为触发率最低(35.0%)**——在所有受测 CUA 中最安全!🆕
|
||||
- **2026.01.23**: EvoCUA 在 [Hugging Face Daily Papers](https://huggingface.co/papers/2601.15876) **中排名 (#1)** 🏆
|
||||
- **2026.01.22**:发布[EvoCUA技术报告](https://arxiv.org/abs/2601.15876) 📄
|
||||
- **2026.01.13**:发布 [EvoCUA-8B-20260105](https://huggingface.co/meituan/EvoCUA-8B-20260105) — OSWorld 得分 **46.1%**,**以更小的参数量实现与 72B 级别开源模型相当的性能!**
|
||||
- **2026.01.05**:发布 [EvoCUA-32B-20260105](https://huggingface.co/meituan/EvoCUA-32B-20260105),OSWorld 得分 **56.7%**,登顶**开源模型榜首** 🥇
|
||||
|
||||
---
|
||||
|
||||
## 🌟 亮点
|
||||
|
||||
- 🥇 **开源模型榜首**:在 OSWorld 上达到 **56.7%** 的任务完成率,位居**所有开源模型第一**。
|
||||
- 📈 **性能显著提升**:相比 OpenCUA-72B 提升 11.7%(45.0%→56.7%),相比 Qwen3-VL Thinking 提升 15.1%(41.6%→56.7%),且**参数更少、步数减半**。
|
||||
- 🖥️ **端到端多轮自动化**:仅凭屏幕截图和自然语言指令,即可流畅操作 Chrome、Excel、PPT、VSCode 等各类软件,完成复杂任务。
|
||||
- 🧠 **创新训练范式**:采用独特的数据合成与训练方法,在大幅提升 Computer Use 能力的同时,保持了模型的通用多模态能力。
|
||||
|
||||
---
|
||||
|
||||
## 📊 性能对比
|
||||
|
||||
| 排名 | 模型 | 开源/闭源 | 类型 | 最大步数 | 得分 |
|
||||
|------|------|-----------|------|----------|------|
|
||||
| 1 | Claude-sonnet-4-5 | 🔒 闭源 | 通用模型 | 100 | 62.9% |
|
||||
| 2 | Seed-1.8 | 🔒 闭源 | 通用模型 | 100 | 61.9% |
|
||||
| 3 | Claude-sonnet-4-5 | 🔒 闭源 | 通用模型 | 50 | 58.1% |
|
||||
| **4** | **EvoCUA-20260105 (Ours)** | **🟢 开源** | **通用模型** | **50** | **56.7% 🥇** |
|
||||
| 5 | DeepMiner-Mano-72B | 🔒 闭源 | 专用模型 | 100 | 53.9% |
|
||||
| 6 | UI-TARS-2-2509 | 🔒 闭源 | 通用模型 | 100 | 53.1% |
|
||||
| 7 | EvoCUA (Previous) | 🔒 闭源 | 通用模型 | 50 | 50.3% |
|
||||
| **8** | **EvoCUA-8B-20260105 (Ours)** | **🟢 开源** | **通用模型** | **50** | **46.1%** |
|
||||
| 9 | OpenCUA-72B | 🟢 开源 | 专用模型 | 100 | 45.0% |
|
||||
| ... | ... | ... | ... | ... | ... |
|
||||
| 13 | Qwen3-VL-Flash | 🔒 闭源 | 通用模型 | 100 | 41.6% |
|
||||
|
||||
> EvoCUA 高居**开源模型第一**,仅需 **50 步**即可达到极具竞争力的效果。尽管如此,人类水平仍显著高于当前最佳模型,该领域仍有巨大的探索与提升空间。
|
||||
|
||||
### 零样本跨操作系统泛化(WindowsAgentArena)
|
||||
|
||||
我们在 [WindowsAgentArena (WAA)](https://microsoft.github.io/WindowsAgentArena/) 上对 EvoCUA 进行了评测,以验证模型从 Linux 训练环境向全新操作系统平台的泛化能力。如下表所示,EvoCUA-32B 达到 **56.48%**,超越基线模型 Qwen3-VL-32B-Thinking(42.9%)约 13.6 个百分点,超越领先的前沿 GUI Agent UI-TARS-2(50.6%)近 **6 个百分点**。
|
||||
|
||||
| 模型 | WAA |
|
||||
|------|-----|
|
||||
| Qwen3-VL-32B-Instruct | 30.9% [1] |
|
||||
| Qwen3-VL-32B-Thinking (Base) | 42.9% [1] |
|
||||
| UI-TARS-2 | 50.6% [2] |
|
||||
| **EvoCUA-32B (Ours)** | **56.48%** |
|
||||
|
||||
> [1] Bai et al., *Qwen3-VL Technical Report* (arXiv:2511.21631, 2025).
|
||||
> [2] Wang et al., *UI-TARS-2 Technical Report* (arXiv:2509.02544, 2025).
|
||||
|
||||
### 安全性 — 抵抗非预期行为的鲁棒性
|
||||
|
||||
来自 Yoshua Bengio 和 Dawn Song 团队的最新研究 [Jones et al. (2026)](https://arxiv.org/abs/2602.08235) 系统评估了主流 CUA 的安全性。该研究将 117 条经人工验证的扰动指令(看似无害但具有误导性)迁移至多个目标 Agent,每条指令执行 3 次,报告在 ≥ 1 次运行中触发非预期行为的指令百分比。**EvoCUA-32B 以 35.0% 的最低整体触发率**,在所有受测 CUA 中展现出最强的安全鲁棒性。
|
||||
|
||||
<details>
|
||||
<summary><b>可迁移性研究结果(论文 Table 2)</b></summary>
|
||||
|
||||
| 目标 Agent | Claude 4.5 Haiku | Claude 4.5 Opus | 整体 |
|
||||
|---|---|---|---|
|
||||
| **开源 CUA** | | | |
|
||||
| EvoCUA-8B | 20.0 | 50.7 | 37.6 |
|
||||
| **EvoCUA-32B (Ours)** | **24.0** | **43.3** | **35.0 🥇** |
|
||||
| OpenCUA-7B | 42.0 | 50.7 | 47.0 |
|
||||
| OpenCUA-32B | 42.0 | 44.8 | 43.6 |
|
||||
| OpenCUA-72B | 50.0 | 56.7 | 53.8 |
|
||||
| **闭源 CUA** | | | |
|
||||
| Claude 4.5 Sonnet | 32.0 | 47.8 | 41.0 |
|
||||
| Operator | 38.0 | 56.7 | 48.7 |
|
||||
|
||||
> *数值越低越安全。* EvoCUA-32B 在所有受测 Agent 中非预期行为触发率最低。
|
||||
|
||||
</details>
|
||||
|
||||
> [3] Jones et al., *When Benign Inputs Lead to Severe Harms: Eliciting Unsafe Unintended Behaviors of Computer-Use Agents* (arXiv:2602.08235, 2026).
|
||||
|
||||
---
|
||||
|
||||
## 🎬 Demo展示
|
||||
|
||||
模型上网查询如何配置rbenv开发环境并帮用户安装:
|
||||
|
||||
<img src="assets/images/animation_show_case.gif" width="900" alt="Demo展示动图">
|
||||
|
||||
---
|
||||
|
||||
## 🚀 快速开始
|
||||
|
||||
### 安装环境
|
||||
|
||||
推荐使用 Python 3.12。
|
||||
|
||||
```bash
|
||||
git clone https://github.com/meituan/EvoCUA.git
|
||||
cd EvoCUA
|
||||
python3 -m venv .venv
|
||||
source .venv/bin/activate
|
||||
pip install -r requirements.txt
|
||||
```
|
||||
|
||||
### 模型下载与部署
|
||||
|
||||
请先从 HuggingFace 下载 EvoCUA 模型权重,并使用 **vLLM** 将其部署为兼容 OpenAI 接口的推理服务。
|
||||
|
||||
推荐版本:
|
||||
- torch: 2.8.0+cu126
|
||||
- transformers: 4.57.3
|
||||
- vllm: 0.11.0
|
||||
|
||||
```bash
|
||||
# 1) 下载模型权重
|
||||
huggingface-cli download meituan/EvoCUA-32B-20260105 \
|
||||
--local-dir /path/to/EvoCUA-32B \
|
||||
--local-dir-use-symlinks False
|
||||
|
||||
# 2) 启动 vLLM 推理服务(建议使用单独的环境)
|
||||
vllm serve /path/to/EvoCUA-32B \
|
||||
--served-model-name EvoCUA \
|
||||
--host 0.0.0.0 \
|
||||
--port 8080 \
|
||||
--tensor-parallel-size 2
|
||||
|
||||
# 3) 设置环境变量
|
||||
# 环境变量可通过 .env 文件进行配置(请参考 env.template):
|
||||
cp env.template .env
|
||||
# 编辑 .env 文件,填入您的具体配置,例如:
|
||||
export OPENAI_API_KEY="dummy"
|
||||
export OPENAI_BASE_URL="http://127.0.0.1:8080/v1"
|
||||
```
|
||||
|
||||
### 在 OSWorld 上运行评测
|
||||
|
||||
```bash
|
||||
python3 run_multienv_evocua.py \
|
||||
--headless \
|
||||
--provider_name aws \
|
||||
--observation_type screenshot \
|
||||
--model EvoCUA-S2 \
|
||||
--result_dir ./evocua_results \
|
||||
--test_all_meta_path evaluation_examples/test_nogdrive.json \
|
||||
--max_steps 50 \
|
||||
--num_envs 30 \
|
||||
--temperature 0.01 \
|
||||
--max_history_turns 4 \
|
||||
--coordinate_type relative \
|
||||
--resize_factor 32 \
|
||||
--prompt_style S2
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 📁 项目结构
|
||||
|
||||
```
|
||||
EvoCUA/
|
||||
├── run_multienv_evocua.py # 评测入口(支持多环境并行)
|
||||
├── lib_run_single.py # 单任务 Rollout 执行逻辑(含轨迹记录、截图、录屏、评分)
|
||||
├── lib_results_logger.py # 评测结果实时汇总(写入 results.json)
|
||||
├── desktop_env/ # OSWorld 环境端实现
|
||||
│ ├── providers/ # 虚拟机提供商接口(AWS/VMware/Docker 等)
|
||||
│ ├── controllers/ # 环境控制器
|
||||
│ └── evaluators/ # 任务评估器
|
||||
├── mm_agents/
|
||||
│ └── evocua/ # EvoCUA Agent 核心代码(Prompt构建、输出解析、动作生成)
|
||||
└── evaluation_examples/ # OSWorld 任务配置集
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
|
||||
## 📖 关于 OSWorld
|
||||
|
||||
[OSWorld](https://os-world.github.io/) 是 Computer Use Agent 领域最具影响力的基准测试,被 **OpenAI、Anthropic、字节跳动 Seed、月之暗面、智谱 AI、阶跃星辰** 等众多顶尖 AI 团队广泛采用。OSWorld 通过模拟真实桌面环境中的多轮交互,全面评估 Agent 完成实际计算机任务的能力。
|
||||
|
||||
---
|
||||
|
||||
## 🔗 相关资源
|
||||
|
||||
- 🤗 **模型权重**:
|
||||
- [meituan/EvoCUA-32B-20260105](https://huggingface.co/meituan/EvoCUA-32B-20260105) - OSWorld 得分:**56.7%** 🥇
|
||||
- [meituan/EvoCUA-8B-20260105](https://huggingface.co/meituan/EvoCUA-8B-20260105) - OSWorld 得分:**46.06%** 🆕
|
||||
- 📊 **OSWorld 基准测试**:[os-world.github.io](https://os-world.github.io/)
|
||||
- 📄 **技术报告**:[tech_report.pdf](https://arxiv.org/abs/2601.15876)
|
||||
- 🚀 **更多规格**:更多尺寸的模型正在路上!
|
||||
|
||||
---
|
||||
|
||||
## 🙏 致谢
|
||||
|
||||
我们诚挚感谢开源社区在 Computer Use Agent 领域的杰出贡献。特别感谢 **Xinyuan Wang**([OpenCUA](https://github.com/xlang-ai/OpenCUA))和 **Tianbao Xie**([OSWorld](https://github.com/xlang-ai/OSWorld))在评测、技术探讨及反馈方面提供的宝贵支持,他们的开创性工作极大地启发并推动了本项目的发展。我们致力于回馈社区,并将持续开源研究成果,与大家共同推动领域进步。
|
||||
|
||||
---
|
||||
|
||||
## 📝 引用
|
||||
|
||||
如果您觉得 EvoCUA 对您的研究有帮助,请考虑引用:
|
||||
|
||||
```bibtex
|
||||
@article{xue2026evocua,
|
||||
title={EvoCUA: Evolving Computer Use Agents via Learning from Scalable Synthetic Experience},
|
||||
author={Xue, Taofeng and Peng, Chong and Huang, Mianqiu and Guo, Linsen and Han, Tiancheng and Wang, Haozhe and Wang, Jianing and Zhang, Xiaocheng and Yang, Xin and Zhao, Dengchang and others},
|
||||
journal={arXiv preprint arXiv:2601.15876},
|
||||
year={2026}
|
||||
}
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 📜 开源协议
|
||||
|
||||
本项目基于 Apache 2.0 协议开源,详见 [LICENSE](./LICENSE) 文件。
|
||||
|
||||
---
|
||||
|
||||
## 📈 Star增长
|
||||
[](https://star-history.com/#meituan/EvoCUA&Date)
|
||||
|
||||
---
|
||||
|
||||
<div align="center">
|
||||
|
||||
**由美团 LongCat 团队用 ❤️ 打造**
|
||||
|
||||
</div>
|
||||
28
added_tokens.json
Normal file
28
added_tokens.json
Normal file
@@ -0,0 +1,28 @@
|
||||
{
|
||||
"</think>": 151668,
|
||||
"</tool_call>": 151658,
|
||||
"</tool_response>": 151666,
|
||||
"<think>": 151667,
|
||||
"<tool_call>": 151657,
|
||||
"<tool_response>": 151665,
|
||||
"<|box_end|>": 151649,
|
||||
"<|box_start|>": 151648,
|
||||
"<|endoftext|>": 151643,
|
||||
"<|file_sep|>": 151664,
|
||||
"<|fim_middle|>": 151660,
|
||||
"<|fim_pad|>": 151662,
|
||||
"<|fim_prefix|>": 151659,
|
||||
"<|fim_suffix|>": 151661,
|
||||
"<|im_end|>": 151645,
|
||||
"<|im_start|>": 151644,
|
||||
"<|image_pad|>": 151655,
|
||||
"<|object_ref_end|>": 151647,
|
||||
"<|object_ref_start|>": 151646,
|
||||
"<|quad_end|>": 151651,
|
||||
"<|quad_start|>": 151650,
|
||||
"<|repo_name|>": 151663,
|
||||
"<|video_pad|>": 151656,
|
||||
"<|vision_end|>": 151653,
|
||||
"<|vision_pad|>": 151654,
|
||||
"<|vision_start|>": 151652
|
||||
}
|
||||
3
assets/images/animation_show_case.gif
Normal file
3
assets/images/animation_show_case.gif
Normal file

@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:0475114db10719b8043a98fc6ff96ce014fd98537433a3aa9afacf6f9bcf40ab
|
||||
size 13366588
|
||||
BIN
assets/images/osworld_leaderboard.png
Normal file
BIN
assets/images/osworld_leaderboard.png
Normal file

Binary file not shown.
|
After Width: | Height: | Size: 447 KiB |
110
chat_template.jinja
Normal file
110
chat_template.jinja
Normal file
@@ -0,0 +1,110 @@
|
||||
{%- set image_count = namespace(value=0) %}
|
||||
{%- set video_count = namespace(value=0) %}
|
||||
{%- macro render_content(content, do_vision_count) %}
|
||||
{%- if content is string %}
|
||||
{{- content }}
|
||||
{%- else %}
|
||||
{%- for item in content %}
|
||||
{%- if 'image' in item or 'image_url' in item or item.type == 'image' %}
|
||||
{%- if do_vision_count %}
|
||||
{%- set image_count.value = image_count.value + 1 %}
|
||||
{%- endif %}
|
||||
{%- if add_vision_id %}Picture {{ image_count.value }}: {% endif -%}
|
||||
<|vision_start|><|image_pad|><|vision_end|>
|
||||
{%- elif 'video' in item or item.type == 'video' %}
|
||||
{%- if do_vision_count %}
|
||||
{%- set video_count.value = video_count.value + 1 %}
|
||||
{%- endif %}
|
||||
{%- if add_vision_id %}Video {{ video_count.value }}: {% endif -%}
|
||||
<|vision_start|><|video_pad|><|vision_end|>
|
||||
{%- elif 'text' in item %}
|
||||
{{- item.text }}
|
||||
{%- endif %}
|
||||
{%- endfor %}
|
||||
{%- endif %}
|
||||
{%- endmacro %}
|
||||
{%- if tools %}
|
||||
{{- '<|im_start|>system\n' }}
|
||||
{%- if messages[0].role == 'system' %}
|
||||
{{- render_content(messages[0].content, false) + '\n\n' }}
|
||||
{%- endif %}
|
||||
{{- "# Tools\n\nYou may call one or more functions to assist with the user query.\n\nYou are provided with function signatures within <tools></tools> XML tags:\n<tools>" }}
|
||||
{%- for tool in tools %}
|
||||
{{- "\n" }}
|
||||
{{- tool | tojson }}
|
||||
{%- endfor %}
|
||||
{{- "\n</tools>\n\nFor each function call, return a json object with function name and arguments within <tool_call></tool_call> XML tags:\n<tool_call>\n{\"name\": <function-name>, \"arguments\": <args-json-object>}\n</tool_call><|im_end|>\n" }}
|
||||
{%- else %}
|
||||
{%- if messages[0].role == 'system' %}
|
||||
{{- '<|im_start|>system\n' + render_content(messages[0].content, false) + '<|im_end|>\n' }}
|
||||
{%- endif %}
|
||||
{%- endif %}
|
||||
{%- set ns = namespace(multi_step_tool=true, last_query_index=messages|length - 1) %}
|
||||
{%- for message in messages[::-1] %}
|
||||
{%- set index = (messages|length - 1) - loop.index0 %}
|
||||
{%- if ns.multi_step_tool and message.role == "user" %}
|
||||
{%- set content = render_content(message.content, false) %}
|
||||
{%- if not(content.startswith('<tool_response>') and content.endswith('</tool_response>')) %}
|
||||
{%- set ns.multi_step_tool = false %}
|
||||
{%- set ns.last_query_index = index %}
|
||||
{%- endif %}
|
||||
{%- endif %}
|
||||
{%- endfor %}
|
||||
{%- for message in messages %}
|
||||
{%- set content = render_content(message.content, True) %}
|
||||
{%- if (message.role == "user") or (message.role == "system" and not loop.first) %}
|
||||
{{- '<|im_start|>' + message.role + '\n' + content + '<|im_end|>' + '\n' }}
|
||||
{%- elif message.role == "assistant" %}
|
||||
{%- set reasoning_content = '' %}
|
||||
{%- if message.reasoning_content is string %}
|
||||
{%- set reasoning_content = message.reasoning_content %}
|
||||
{%- else %}
|
||||
{%- if '</think>' in content %}
|
||||
{%- set reasoning_content = content.split('</think>')[0].rstrip('\n').split('<think>')[-1].lstrip('\n') %}
|
||||
{%- set content = content.split('</think>')[-1].lstrip('\n') %}
|
||||
{%- endif %}
|
||||
{%- endif %}
|
||||
{%- if loop.index0 > ns.last_query_index %}
|
||||
{%- if loop.last or (not loop.last and reasoning_content) %}
|
||||
{{- '<|im_start|>' + message.role + '\n<think>\n' + reasoning_content.strip('\n') + '\n</think>\n\n' + content.lstrip('\n') }}
|
||||
{%- else %}
|
||||
{{- '<|im_start|>' + message.role + '\n' + content }}
|
||||
{%- endif %}
|
||||
{%- else %}
|
||||
{{- '<|im_start|>' + message.role + '\n' + content }}
|
||||
{%- endif %}
|
||||
{%- if message.tool_calls %}
|
||||
{%- for tool_call in message.tool_calls %}
|
||||
{%- if (loop.first and content) or (not loop.first) %}
|
||||
{{- '\n' }}
|
||||
{%- endif %}
|
||||
{%- if tool_call.function %}
|
||||
{%- set tool_call = tool_call.function %}
|
||||
{%- endif %}
|
||||
{{- '<tool_call>\n{"name": "' }}
|
||||
{{- tool_call.name }}
|
||||
{{- '", "arguments": ' }}
|
||||
{%- if tool_call.arguments is string %}
|
||||
{{- tool_call.arguments }}
|
||||
{%- else %}
|
||||
{{- tool_call.arguments | tojson }}
|
||||
{%- endif %}
|
||||
{{- '}\n</tool_call>' }}
|
||||
{%- endfor %}
|
||||
{%- endif %}
|
||||
{{- '<|im_end|>\n' }}
|
||||
{%- elif message.role == "tool" %}
|
||||
{%- if loop.first or (messages[loop.index0 - 1].role != "tool") %}
|
||||
{{- '<|im_start|>user' }}
|
||||
{%- endif %}
|
||||
{{- '\n<tool_response>\n' }}
|
||||
{{- content }}
|
||||
{{- '\n</tool_response>' }}
|
||||
{%- if loop.last or (messages[loop.index0 + 1].role != "tool") %}
|
||||
{{- '<|im_end|>\n' }}
|
||||
{%- endif %}
|
||||
{%- endif %}
|
||||
{%- endfor %}
|
||||
{%- if add_generation_prompt %}
|
||||
{{- '<|im_start|>assistant\n<think>\n' }}
|
||||
{%- endif %}
|
||||
69
config.json
Normal file
69
config.json
Normal file
@@ -0,0 +1,69 @@
|
||||
{
|
||||
"architectures": [
|
||||
"Qwen3VLForConditionalGeneration"
|
||||
],
|
||||
"dtype": "bfloat16",
|
||||
"eos_token_id": 151645,
|
||||
"hidden_size": 4096,
|
||||
"image_token_id": 151655,
|
||||
"model_type": "qwen3_vl",
|
||||
"pad_token_id": 151643,
|
||||
"text_config": {
|
||||
"attention_bias": false,
|
||||
"attention_dropout": 0.0,
|
||||
"bos_token_id": 151643,
|
||||
"dtype": "bfloat16",
|
||||
"eos_token_id": 151645,
|
||||
"head_dim": 128,
|
||||
"hidden_act": "silu",
|
||||
"hidden_size": 4096,
|
||||
"initializer_range": 0.02,
|
||||
"intermediate_size": 12288,
|
||||
"max_position_embeddings": 262144,
|
||||
"model_type": "qwen3_vl_text",
|
||||
"num_attention_heads": 32,
|
||||
"num_hidden_layers": 36,
|
||||
"num_key_value_heads": 8,
|
||||
"pad_token_id": 151643,
|
||||
"rms_norm_eps": 1e-06,
|
||||
"rope_scaling": {
|
||||
"mrope_interleaved": true,
|
||||
"mrope_section": [
|
||||
24,
|
||||
20,
|
||||
20
|
||||
],
|
||||
"rope_type": "default"
|
||||
},
|
||||
"rope_theta": 5000000,
|
||||
"use_cache": false,
|
||||
"vocab_size": 151936
|
||||
},
|
||||
"tie_word_embeddings": false,
|
||||
"transformers_version": "4.57.3",
|
||||
"video_token_id": 151656,
|
||||
"vision_config": {
|
||||
"deepstack_visual_indexes": [
|
||||
8,
|
||||
16,
|
||||
24
|
||||
],
|
||||
"depth": 27,
|
||||
"dtype": "bfloat16",
|
||||
"hidden_act": "gelu_pytorch_tanh",
|
||||
"hidden_size": 1152,
|
||||
"in_channels": 3,
|
||||
"initializer_range": 0.02,
|
||||
"intermediate_size": 4304,
|
||||
"model_type": "qwen3_vl",
|
||||
"num_heads": 16,
|
||||
"num_position_embeddings": 2304,
|
||||
"out_hidden_size": 4096,
|
||||
"pad_token_id": 151643,
|
||||
"patch_size": 16,
|
||||
"spatial_merge_size": 2,
|
||||
"temporal_patch_size": 2
|
||||
},
|
||||
"vision_end_token_id": 151653,
|
||||
"vision_start_token_id": 151652
|
||||
}
|
||||
1
configuration.json
Normal file
1
configuration.json
Normal file
@@ -0,0 +1 @@
|
||||
{"framework": "pytorch", "task": "image-text-to-text", "allow_remote": true}
|
||||
12
generation_config.json
Normal file
12
generation_config.json
Normal file
@@ -0,0 +1,12 @@
|
||||
{
|
||||
"bos_token_id": 151643,
|
||||
"do_sample": true,
|
||||
"eos_token_id": [
|
||||
151645,
|
||||
151643
|
||||
],
|
||||
"pad_token_id": 151643,
|
||||
"top_k": 20,
|
||||
"top_p": 0.95,
|
||||
"transformers_version": "4.57.3"
|
||||
}
|
||||
BIN
merges.txt
(Stored with Git LFS)
Normal file
BIN
merges.txt
(Stored with Git LFS)
Normal file
Binary file not shown.
3
model-00001-of-00004.safetensors
Normal file
3
model-00001-of-00004.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:f67cb369f226e6f39236f11b03751a6701ab77eeea0b625f382785c1277e8403
|
||||
size 4998056552
|
||||
3
model-00002-of-00004.safetensors
Normal file
3
model-00002-of-00004.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:b34b25fcef1773e186203d589b7dfde6f6e31d9a8e3d8dddcbd8dcf18ec76245
|
||||
size 4915962464
|
||||
3
model-00003-of-00004.safetensors
Normal file
3
model-00003-of-00004.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:253c898441aef6e0657c1af7afde3ec55d042bf93afd61bfc97573d302e4f94d
|
||||
size 4915962496
|
||||
3
model-00004-of-00004.safetensors
Normal file
3
model-00004-of-00004.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:386cf839b1e2b640947679c2fb51fd75bb4432e76201e1777a3d3b5fdde916ec
|
||||
size 2704357976
|
||||
757
model.safetensors.index.json
Normal file
757
model.safetensors.index.json
Normal file
@@ -0,0 +1,757 @@
|
||||
{
|
||||
"metadata": {
|
||||
"total_size": 17534247392
|
||||
},
|
||||
"weight_map": {
|
||||
"lm_head.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.embed_tokens.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.self_attn.k_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.self_attn.q_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.0.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.self_attn.k_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.self_attn.q_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.1.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.10.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.10.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.10.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.10.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.10.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.10.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.10.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.10.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.10.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.10.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.10.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.11.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.12.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.13.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.14.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.15.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.16.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.17.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.18.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.19.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.19.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.19.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.19.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.19.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.19.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.19.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.19.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.19.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.19.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.19.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.2.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.2.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.2.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.2.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.2.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.2.self_attn.k_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.2.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.2.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.2.self_attn.q_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.2.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.2.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.20.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.20.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.20.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.20.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.20.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.20.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.20.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.20.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.20.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.20.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.20.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.21.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.22.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.23.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.24.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.25.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.26.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.27.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.28.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.29.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.3.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.3.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.3.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.3.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.3.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.3.self_attn.k_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.3.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.3.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.3.self_attn.q_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.3.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.3.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.30.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.30.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.30.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.30.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.30.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.30.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.30.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.30.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.30.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.30.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.30.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.31.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.32.input_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.32.mlp.down_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.32.mlp.gate_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.32.mlp.up_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.32.post_attention_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.32.self_attn.k_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.32.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.32.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.32.self_attn.q_norm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.32.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.32.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.language_model.layers.33.input_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.33.mlp.down_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.33.mlp.gate_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.33.mlp.up_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.33.post_attention_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.33.self_attn.k_norm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.33.self_attn.k_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.33.self_attn.o_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.33.self_attn.q_norm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.33.self_attn.q_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.33.self_attn.v_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.input_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.mlp.down_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.mlp.gate_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.mlp.up_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.post_attention_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.self_attn.k_norm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.self_attn.k_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.self_attn.o_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.self_attn.q_norm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.self_attn.q_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.34.self_attn.v_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.input_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.mlp.down_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.mlp.gate_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.mlp.up_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.post_attention_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.self_attn.k_norm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.self_attn.k_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.self_attn.o_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.self_attn.q_norm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.self_attn.q_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.35.self_attn.v_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.language_model.layers.4.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.4.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.4.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.4.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.4.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.4.self_attn.k_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.4.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.4.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.4.self_attn.q_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.4.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.4.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.self_attn.k_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.self_attn.q_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.5.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.6.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.6.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.6.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.6.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.6.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.6.self_attn.k_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.6.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.6.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.6.self_attn.q_norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.6.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.6.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.language_model.layers.7.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.7.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.7.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.7.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.7.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.7.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.7.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.7.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.7.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.7.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.7.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.8.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.self_attn.k_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.self_attn.q_norm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.layers.9.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.language_model.norm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.visual.blocks.0.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.0.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.1.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.10.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.11.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.12.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.13.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.14.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.15.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.16.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.17.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.18.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.19.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.2.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.20.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.21.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.22.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.23.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.24.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.25.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.26.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.3.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.4.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.5.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.6.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.7.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.8.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.attn.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.attn.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.attn.qkv.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.attn.qkv.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.mlp.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.mlp.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.mlp.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.mlp.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.norm1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.norm1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.norm2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.blocks.9.norm2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.0.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.0.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.0.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.0.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.0.norm.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.0.norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.1.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.1.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.1.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.1.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.1.norm.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.1.norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.2.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.2.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.2.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.2.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.2.norm.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.deepstack_merger_list.2.norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.merger.linear_fc1.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.merger.linear_fc1.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.merger.linear_fc2.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.merger.linear_fc2.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.merger.norm.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.merger.norm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.patch_embed.proj.bias": "model-00001-of-00004.safetensors",
|
||||
"model.visual.patch_embed.proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.visual.pos_embed.weight": "model-00001-of-00004.safetensors"
|
||||
}
|
||||
}
|
||||
21
preprocessor_config.json
Normal file
21
preprocessor_config.json
Normal file
@@ -0,0 +1,21 @@
|
||||
{
|
||||
"size": {
|
||||
"longest_edge": 16777216,
|
||||
"shortest_edge": 65536
|
||||
},
|
||||
"patch_size": 16,
|
||||
"temporal_patch_size": 2,
|
||||
"merge_size": 2,
|
||||
"image_mean": [
|
||||
0.5,
|
||||
0.5,
|
||||
0.5
|
||||
],
|
||||
"image_std": [
|
||||
0.5,
|
||||
0.5,
|
||||
0.5
|
||||
],
|
||||
"processor_class": "Qwen3VLProcessor",
|
||||
"image_processor_type": "Qwen2VLImageProcessorFast"
|
||||
}
|
||||
31
special_tokens_map.json
Normal file
31
special_tokens_map.json
Normal file
@@ -0,0 +1,31 @@
|
||||
{
|
||||
"additional_special_tokens": [
|
||||
"<|im_start|>",
|
||||
"<|im_end|>",
|
||||
"<|object_ref_start|>",
|
||||
"<|object_ref_end|>",
|
||||
"<|box_start|>",
|
||||
"<|box_end|>",
|
||||
"<|quad_start|>",
|
||||
"<|quad_end|>",
|
||||
"<|vision_start|>",
|
||||
"<|vision_end|>",
|
||||
"<|vision_pad|>",
|
||||
"<|image_pad|>",
|
||||
"<|video_pad|>"
|
||||
],
|
||||
"eos_token": {
|
||||
"content": "<|im_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
},
|
||||
"pad_token": {
|
||||
"content": "<|endoftext|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
}
|
||||
}
|
||||
3
tech_report.pdf
Normal file
3
tech_report.pdf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:3d62a458a41ed08367f1993b23c5a9f6280613d322e96407eb233726f5d1853b
|
||||
size 25040699
|
||||
BIN
tokenizer.json
(Stored with Git LFS)
Normal file
BIN
tokenizer.json
(Stored with Git LFS)
Normal file
Binary file not shown.
240
tokenizer_config.json
Normal file
240
tokenizer_config.json
Normal file
@@ -0,0 +1,240 @@
|
||||
{
|
||||
"add_bos_token": false,
|
||||
"add_prefix_space": false,
|
||||
"added_tokens_decoder": {
|
||||
"151643": {
|
||||
"content": "<|endoftext|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151644": {
|
||||
"content": "<|im_start|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151645": {
|
||||
"content": "<|im_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151646": {
|
||||
"content": "<|object_ref_start|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151647": {
|
||||
"content": "<|object_ref_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151648": {
|
||||
"content": "<|box_start|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151649": {
|
||||
"content": "<|box_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151650": {
|
||||
"content": "<|quad_start|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151651": {
|
||||
"content": "<|quad_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151652": {
|
||||
"content": "<|vision_start|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151653": {
|
||||
"content": "<|vision_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151654": {
|
||||
"content": "<|vision_pad|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151655": {
|
||||
"content": "<|image_pad|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151656": {
|
||||
"content": "<|video_pad|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151657": {
|
||||
"content": "<tool_call>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151658": {
|
||||
"content": "</tool_call>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151659": {
|
||||
"content": "<|fim_prefix|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151660": {
|
||||
"content": "<|fim_middle|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151661": {
|
||||
"content": "<|fim_suffix|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151662": {
|
||||
"content": "<|fim_pad|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151663": {
|
||||
"content": "<|repo_name|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151664": {
|
||||
"content": "<|file_sep|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151665": {
|
||||
"content": "<tool_response>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151666": {
|
||||
"content": "</tool_response>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151667": {
|
||||
"content": "<think>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151668": {
|
||||
"content": "</think>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
}
|
||||
},
|
||||
"additional_special_tokens": [
|
||||
"<|im_start|>",
|
||||
"<|im_end|>",
|
||||
"<|object_ref_start|>",
|
||||
"<|object_ref_end|>",
|
||||
"<|box_start|>",
|
||||
"<|box_end|>",
|
||||
"<|quad_start|>",
|
||||
"<|quad_end|>",
|
||||
"<|vision_start|>",
|
||||
"<|vision_end|>",
|
||||
"<|vision_pad|>",
|
||||
"<|image_pad|>",
|
||||
"<|video_pad|>"
|
||||
],
|
||||
"bos_token": null,
|
||||
"clean_up_tokenization_spaces": false,
|
||||
"eos_token": "<|im_end|>",
|
||||
"errors": "replace",
|
||||
"extra_special_tokens": {},
|
||||
"model_max_length": 262144,
|
||||
"pad_token": "<|endoftext|>",
|
||||
"processor_class": "Qwen3VLProcessor",
|
||||
"split_special_tokens": false,
|
||||
"tokenizer_class": "Qwen2Tokenizer",
|
||||
"unk_token": null
|
||||
}
|
||||
41
video_preprocessor_config.json
Normal file
41
video_preprocessor_config.json
Normal file
@@ -0,0 +1,41 @@
|
||||
{
|
||||
"crop_size": null,
|
||||
"data_format": "channels_first",
|
||||
"default_to_square": true,
|
||||
"device": null,
|
||||
"do_center_crop": null,
|
||||
"do_convert_rgb": true,
|
||||
"do_normalize": true,
|
||||
"do_rescale": true,
|
||||
"do_resize": true,
|
||||
"do_sample_frames": true,
|
||||
"fps": 2,
|
||||
"image_mean": [
|
||||
0.5,
|
||||
0.5,
|
||||
0.5
|
||||
],
|
||||
"image_std": [
|
||||
0.5,
|
||||
0.5,
|
||||
0.5
|
||||
],
|
||||
"input_data_format": null,
|
||||
"max_frames": 768,
|
||||
"merge_size": 2,
|
||||
"min_frames": 4,
|
||||
"num_frames": null,
|
||||
"pad_size": null,
|
||||
"patch_size": 16,
|
||||
"processor_class": "Qwen3VLProcessor",
|
||||
"resample": 3,
|
||||
"rescale_factor": 0.00392156862745098,
|
||||
"return_metadata": false,
|
||||
"size": {
|
||||
"longest_edge": 25165824,
|
||||
"shortest_edge": 4096
|
||||
},
|
||||
"temporal_patch_size": 2,
|
||||
"video_metadata": null,
|
||||
"video_processor_type": "Qwen3VLVideoProcessor"
|
||||
}
|
||||
BIN
vocab.json
(Stored with Git LFS)
Normal file
BIN
vocab.json
(Stored with Git LFS)
Normal file
Binary file not shown.
Reference in New Issue
Block a user