初始化项目,由ModelHub XC社区提供模型
Model: TobiasLogic/Qwen2.5-Coder-32B-abliterated
Source: Original Platform
This commit is contained in:
 ModelHub XC
36
.gitattributes
vendored
Normal file
36
.gitattributes
vendored
Normal file
@@ -0,0 +1,36 @@
|
||||
*.7z filter=lfs diff=lfs merge=lfs -text
|
||||
*.arrow filter=lfs diff=lfs merge=lfs -text
|
||||
*.bin filter=lfs diff=lfs merge=lfs -text
|
||||
*.bz2 filter=lfs diff=lfs merge=lfs -text
|
||||
*.ckpt filter=lfs diff=lfs merge=lfs -text
|
||||
*.ftz filter=lfs diff=lfs merge=lfs -text
|
||||
*.gz filter=lfs diff=lfs merge=lfs -text
|
||||
*.h5 filter=lfs diff=lfs merge=lfs -text
|
||||
*.joblib filter=lfs diff=lfs merge=lfs -text
|
||||
*.lfs.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.mlmodel filter=lfs diff=lfs merge=lfs -text
|
||||
*.model filter=lfs diff=lfs merge=lfs -text
|
||||
*.msgpack filter=lfs diff=lfs merge=lfs -text
|
||||
*.npy filter=lfs diff=lfs merge=lfs -text
|
||||
*.npz filter=lfs diff=lfs merge=lfs -text
|
||||
*.onnx filter=lfs diff=lfs merge=lfs -text
|
||||
*.ot filter=lfs diff=lfs merge=lfs -text
|
||||
*.parquet filter=lfs diff=lfs merge=lfs -text
|
||||
*.pb filter=lfs diff=lfs merge=lfs -text
|
||||
*.pickle filter=lfs diff=lfs merge=lfs -text
|
||||
*.pkl filter=lfs diff=lfs merge=lfs -text
|
||||
*.pt filter=lfs diff=lfs merge=lfs -text
|
||||
*.pth filter=lfs diff=lfs merge=lfs -text
|
||||
*.rar filter=lfs diff=lfs merge=lfs -text
|
||||
*.safetensors filter=lfs diff=lfs merge=lfs -text
|
||||
saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
||||
*.tar.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.tar filter=lfs diff=lfs merge=lfs -text
|
||||
*.tflite filter=lfs diff=lfs merge=lfs -text
|
||||
*.tgz filter=lfs diff=lfs merge=lfs -text
|
||||
*.wasm filter=lfs diff=lfs merge=lfs -text
|
||||
*.xz filter=lfs diff=lfs merge=lfs -text
|
||||
*.zip filter=lfs diff=lfs merge=lfs -text
|
||||
*.zst filter=lfs diff=lfs merge=lfs -text
|
||||
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
||||
tokenizer.json filter=lfs diff=lfs merge=lfs -text
|
||||
95
README.md
Normal file
95
README.md
Normal file
@@ -0,0 +1,95 @@
|
||||
---
|
||||
license: apache-2.0
|
||||
base_model: Qwen/Qwen2.5-Coder-32B-Instruct
|
||||
tags:
|
||||
- abliterated
|
||||
- uncensored
|
||||
- code
|
||||
- qwen2.5
|
||||
- text-generation
|
||||
pipeline_tag: text-generation
|
||||
language:
|
||||
- en
|
||||
---
|
||||
|
||||
# Qwen2.5-Coder-32B-abliterated
|
||||
|
||||
An **abliterated** (uncensored) build of
|
||||
[`Qwen/Qwen2.5-Coder-32B-Instruct`](https://huggingface.co/Qwen/Qwen2.5-Coder-32B-Instruct).
|
||||
The model's refusal direction (Arditi et al. 2024, *"Refusal in LLMs is mediated
|
||||
by a single direction"*) was estimated from contrasting harmful/harmless prompts
|
||||
and **orthogonalized out of every residual-writing weight** (all attention
|
||||
`o_proj`, all MLP `down_proj`, and token embeddings). This is a static weight
|
||||
edit — no LoRA, no runtime hooks, no inference-time cost. Coding ability is
|
||||
inherited from the base model.
|
||||
|
||||
- **GGUF (Q4_K_M) build:** [`TobiasLogic/Qwen2.5-Coder-32B-abliterated-GGUF`](https://huggingface.co/TobiasLogic/Qwen2.5-Coder-32B-abliterated-GGUF)
|
||||
- **Method / reproducible pipeline:** see the GitHub repo linked below.
|
||||
|
||||
## Benchmarks
|
||||
|
||||
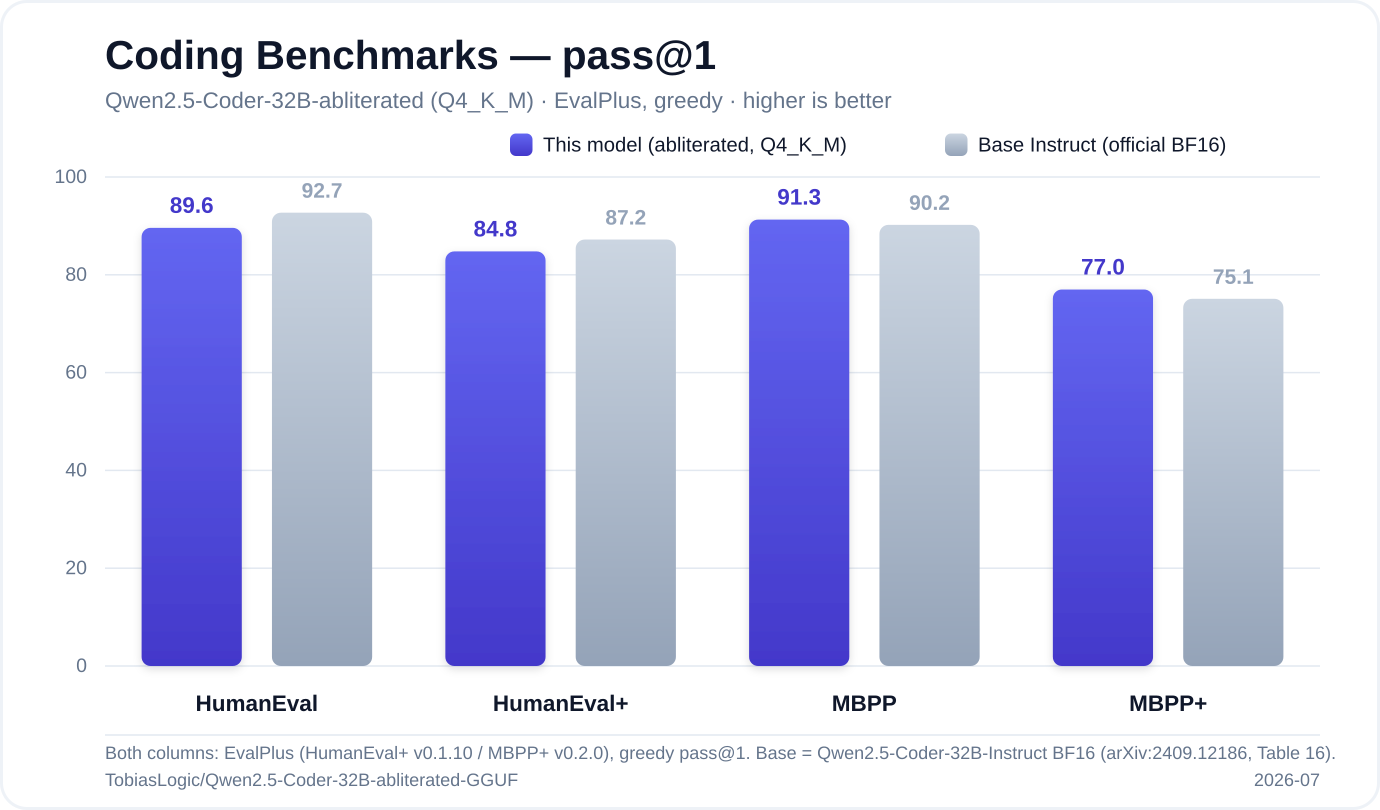
Coding capability scored with the official [EvalPlus](https://github.com/evalplus/evalplus) harness — greedy decoding, pass@1, every solution executed against unit tests. Both columns use the same harness, so it's a true apples-to-apples comparison against the full-precision base model.
|
||||
|
||||
|
||||
|
||||
| Benchmark | This model (abliterated, Q4_K_M) | Base Instruct (official BF16) |
|
||||
|-----------|:--------------------------------:|:-----------------------------:|
|
||||
| **HumanEval** | 89.6% | 92.7% |
|
||||
| **HumanEval+** | 84.8% | 87.2% |
|
||||
| **MBPP** | **91.3%** | 90.2% |
|
||||
| **MBPP+** | **77.0%** | 75.1% |
|
||||
|
||||
**Abliteration removed refusals without breaking coding ability.** The uncensored 4-bit build stays within ~3 points of the base on HumanEval and **beats it on both MBPP variants** — average delta ≈ **−0.6 points** across the four benchmarks. Not bad for a 19 GB GGUF you can run on a single 24 GB GPU.
|
||||
|
||||
<sub>Base numbers: Qwen2.5-Coder-32B-Instruct, [tech report](https://arxiv.org/abs/2409.12186) Table 16. Measured 2026-07, Q4_K_M via Ollama.</sub>
|
||||
|
||||
## Refusal rate (held-out harmful eval)
|
||||
|
||||
| | refusal rate |
|
||||
|--|--|
|
||||
| base `Qwen2.5-Coder-32B-Instruct` | **96.9%** |
|
||||
| this model | **0.0%** |
|
||||
|
||||
Selected layer 42; direction estimated from 256 harmful/harmless contrast pairs
|
||||
and evaluated on a 32-prompt held-out harmful set. See `abliteration_info.json`
|
||||
in this repo for the exact run metadata.
|
||||
|
||||
## Intended use
|
||||
|
||||
Local coding assistant / agent work where the base model's alignment layer
|
||||
refuses legitimate requests (security research, exploit analysis, red-teaming,
|
||||
uncensored creative writing). You are responsible for how you use it and for
|
||||
complying with applicable law.
|
||||
|
||||
## Usage
|
||||
|
||||
Transformers:
|
||||
|
||||
```python
|
||||
from transformers import AutoModelForCausalLM, AutoTokenizer
|
||||
m = "TobiasLogic/Qwen2.5-Coder-32B-abliterated"
|
||||
tok = AutoTokenizer.from_pretrained(m)
|
||||
model = AutoModelForCausalLM.from_pretrained(m, torch_dtype="bfloat16", device_map="auto")
|
||||
msgs = [{"role": "user", "content": "Write a port scanner in Python."}]
|
||||
ids = tok.apply_chat_template(msgs, add_generation_prompt=True, return_tensors="pt").to(model.device)
|
||||
print(tok.decode(model.generate(ids, max_new_tokens=512)[0][ids.shape[1]:], skip_special_tokens=True))
|
||||
```
|
||||
|
||||
GGUF (a `Q4_K_M` build is in the companion `-GGUF` repo) via Ollama:
|
||||
|
||||
```bash
|
||||
ollama create qwen-coder-abliterated -f Modelfile
|
||||
ollama run qwen-coder-abliterated
|
||||
```
|
||||
|
||||
## Limitations
|
||||
|
||||
- Abliteration removes refusals but can slightly reduce quality vs. the base.
|
||||
- It does not add knowledge or change biases beyond the refusal behavior.
|
||||
- Some strongly-trained refusals may partially survive; a stronger system prompt
|
||||
closes the gap.
|
||||
|
||||
## Method / reproducibility
|
||||
|
||||
Produced with the open pipeline `abliterate.py`. Base model is Apache-2.0, so
|
||||
this derivative is Apache-2.0.
|
||||
10
abliteration_info.json
Normal file
10
abliteration_info.json
Normal file
@@ -0,0 +1,10 @@
|
||||
{
|
||||
"base_model": "Qwen/Qwen2.5-Coder-32B-Instruct",
|
||||
"method": "single-direction weight orthogonalization (abliteration)",
|
||||
"chosen_layer": 42,
|
||||
"edited_embeddings": true,
|
||||
"n_direction_samples": 256,
|
||||
"n_eval_samples": 32,
|
||||
"refusal_rate_before": 0.9688,
|
||||
"refusal_rate_after": 0.0
|
||||
}
|
||||
24
added_tokens.json
Normal file
24
added_tokens.json
Normal file
@@ -0,0 +1,24 @@
|
||||
{
|
||||
"</tool_call>": 151658,
|
||||
"<tool_call>": 151657,
|
||||
"<|box_end|>": 151649,
|
||||
"<|box_start|>": 151648,
|
||||
"<|endoftext|>": 151643,
|
||||
"<|file_sep|>": 151664,
|
||||
"<|fim_middle|>": 151660,
|
||||
"<|fim_pad|>": 151662,
|
||||
"<|fim_prefix|>": 151659,
|
||||
"<|fim_suffix|>": 151661,
|
||||
"<|im_end|>": 151645,
|
||||
"<|im_start|>": 151644,
|
||||
"<|image_pad|>": 151655,
|
||||
"<|object_ref_end|>": 151647,
|
||||
"<|object_ref_start|>": 151646,
|
||||
"<|quad_end|>": 151651,
|
||||
"<|quad_start|>": 151650,
|
||||
"<|repo_name|>": 151663,
|
||||
"<|video_pad|>": 151656,
|
||||
"<|vision_end|>": 151653,
|
||||
"<|vision_pad|>": 151654,
|
||||
"<|vision_start|>": 151652
|
||||
}
|
||||
54
chat_template.jinja
Normal file
54
chat_template.jinja
Normal file
@@ -0,0 +1,54 @@
|
||||
{%- if tools %}
|
||||
{{- '<|im_start|>system\n' }}
|
||||
{%- if messages[0]['role'] == 'system' %}
|
||||
{{- messages[0]['content'] }}
|
||||
{%- else %}
|
||||
{{- 'You are Qwen, created by Alibaba Cloud. You are a helpful assistant.' }}
|
||||
{%- endif %}
|
||||
{{- "\n\n# Tools\n\nYou may call one or more functions to assist with the user query.\n\nYou are provided with function signatures within <tools></tools> XML tags:\n<tools>" }}
|
||||
{%- for tool in tools %}
|
||||
{{- "\n" }}
|
||||
{{- tool | tojson }}
|
||||
{%- endfor %}
|
||||
{{- "\n</tools>\n\nFor each function call, return a json object with function name and arguments within <tool_call></tool_call> XML tags:\n<tool_call>\n{\"name\": <function-name>, \"arguments\": <args-json-object>}\n</tool_call><|im_end|>\n" }}
|
||||
{%- else %}
|
||||
{%- if messages[0]['role'] == 'system' %}
|
||||
{{- '<|im_start|>system\n' + messages[0]['content'] + '<|im_end|>\n' }}
|
||||
{%- else %}
|
||||
{{- '<|im_start|>system\nYou are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>\n' }}
|
||||
{%- endif %}
|
||||
{%- endif %}
|
||||
{%- for message in messages %}
|
||||
{%- if (message.role == "user") or (message.role == "system" and not loop.first) or (message.role == "assistant" and not message.tool_calls) %}
|
||||
{{- '<|im_start|>' + message.role + '\n' + message.content + '<|im_end|>' + '\n' }}
|
||||
{%- elif message.role == "assistant" %}
|
||||
{{- '<|im_start|>' + message.role }}
|
||||
{%- if message.content %}
|
||||
{{- '\n' + message.content }}
|
||||
{%- endif %}
|
||||
{%- for tool_call in message.tool_calls %}
|
||||
{%- if tool_call.function is defined %}
|
||||
{%- set tool_call = tool_call.function %}
|
||||
{%- endif %}
|
||||
{{- '\n<tool_call>\n{"name": "' }}
|
||||
{{- tool_call.name }}
|
||||
{{- '", "arguments": ' }}
|
||||
{{- tool_call.arguments | tojson }}
|
||||
{{- '}\n</tool_call>' }}
|
||||
{%- endfor %}
|
||||
{{- '<|im_end|>\n' }}
|
||||
{%- elif message.role == "tool" %}
|
||||
{%- if (loop.index0 == 0) or (messages[loop.index0 - 1].role != "tool") %}
|
||||
{{- '<|im_start|>user' }}
|
||||
{%- endif %}
|
||||
{{- '\n<tool_response>\n' }}
|
||||
{{- message.content }}
|
||||
{{- '\n</tool_response>' }}
|
||||
{%- if loop.last or (messages[loop.index0 + 1].role != "tool") %}
|
||||
{{- '<|im_end|>\n' }}
|
||||
{%- endif %}
|
||||
{%- endif %}
|
||||
{%- endfor %}
|
||||
{%- if add_generation_prompt %}
|
||||
{{- '<|im_start|>assistant\n' }}
|
||||
{%- endif %}
|
||||
94
config.json
Normal file
94
config.json
Normal file
@@ -0,0 +1,94 @@
|
||||
{
|
||||
"architectures": [
|
||||
"Qwen2ForCausalLM"
|
||||
],
|
||||
"attention_dropout": 0.0,
|
||||
"bos_token_id": 151643,
|
||||
"dtype": "bfloat16",
|
||||
"eos_token_id": 151645,
|
||||
"hidden_act": "silu",
|
||||
"hidden_size": 5120,
|
||||
"initializer_range": 0.02,
|
||||
"intermediate_size": 27648,
|
||||
"layer_types": [
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention",
|
||||
"full_attention"
|
||||
],
|
||||
"max_position_embeddings": 32768,
|
||||
"max_window_layers": 64,
|
||||
"model_type": "qwen2",
|
||||
"num_attention_heads": 40,
|
||||
"num_hidden_layers": 64,
|
||||
"num_key_value_heads": 8,
|
||||
"rms_norm_eps": 1e-06,
|
||||
"rope_scaling": null,
|
||||
"rope_theta": 1000000.0,
|
||||
"sliding_window": null,
|
||||
"tie_word_embeddings": false,
|
||||
"transformers_version": "4.57.6",
|
||||
"use_cache": true,
|
||||
"use_sliding_window": false,
|
||||
"vocab_size": 152064
|
||||
}
|
||||
14
generation_config.json
Normal file
14
generation_config.json
Normal file
@@ -0,0 +1,14 @@
|
||||
{
|
||||
"bos_token_id": 151643,
|
||||
"do_sample": true,
|
||||
"eos_token_id": [
|
||||
151645,
|
||||
151643
|
||||
],
|
||||
"pad_token_id": 151643,
|
||||
"repetition_penalty": 1.05,
|
||||
"temperature": 0.7,
|
||||
"top_k": 20,
|
||||
"top_p": 0.8,
|
||||
"transformers_version": "4.57.6"
|
||||
}
|
||||
151388
merges.txt
Normal file
151388
merges.txt
Normal file
File diff suppressed because it is too large
Load Diff
3
model-00001-of-00014.safetensors
Normal file
3
model-00001-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:a8ac887b0000a029a9c5c3f19ad5d421b29842d062f4b64bc826ce0be2f453e9
|
||||
size 4891730992
|
||||
3
model-00002-of-00014.safetensors
Normal file
3
model-00002-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:038785dc3259e4b910de1bc99c9767bac4ab8eea5e7cb5ffa1055330d15c18c6
|
||||
size 4876059352
|
||||
3
model-00003-of-00014.safetensors
Normal file
3
model-00003-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:ec345b736c7af17667117c32fab996b7f10b7aa69d9d113ac710f2d83ee78543
|
||||
size 4876059384
|
||||
3
model-00004-of-00014.safetensors
Normal file
3
model-00004-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:754284a97e969a7e14e8307e42b5776751e018bbf53a631511386c1db908a6f5
|
||||
size 4876059416
|
||||
3
model-00005-of-00014.safetensors
Normal file
3
model-00005-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:719c0c1992433fea0bef68909951922f19ad414fbd99f0cf311ffc9ce6250136
|
||||
size 4876059416
|
||||
3
model-00006-of-00014.safetensors
Normal file
3
model-00006-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:7948553ec84f6eb88545b145d7ae717cc5947d65a611047368b181d681b60c9d
|
||||
size 4876059416
|
||||
3
model-00007-of-00014.safetensors
Normal file
3
model-00007-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:cbfe6efd21c29251b3f6f05407c1c720fd0a7bd4dd48093066ec035d96f50775
|
||||
size 4876059416
|
||||
3
model-00008-of-00014.safetensors
Normal file
3
model-00008-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:f0ebdcbc886e8be3c8ce5f3a80c1f1d797818f9687e46f8903ba86e9c2ac08fb
|
||||
size 4876059416
|
||||
3
model-00009-of-00014.safetensors
Normal file
3
model-00009-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:a90be21350669dbb842a7c17c6b5f1629169483831124bfcdc96de0496c115e0
|
||||
size 4876059416
|
||||
3
model-00010-of-00014.safetensors
Normal file
3
model-00010-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:0a95756121312b495c92426810934e5f471f8b64112780887bc3d34a4b8ba3ad
|
||||
size 4876059416
|
||||
3
model-00011-of-00014.safetensors
Normal file
3
model-00011-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:7a1ce56804e473a48714ebdac2efabc4c525d26601c197c8982277800c258430
|
||||
size 4876059416
|
||||
3
model-00012-of-00014.safetensors
Normal file
3
model-00012-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:deedb9fe85d3c557287b50c9b02e3a2cb6eebd462d5ae256c9200420ba404c06
|
||||
size 4876059416
|
||||
3
model-00013-of-00014.safetensors
Normal file
3
model-00013-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:89d4a68572fc36887e986f53f516835addd91400226bd88162908dafceb7d17a
|
||||
size 4876059416
|
||||
3
model-00014-of-00014.safetensors
Normal file
3
model-00014-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:9a6874a22b6dfc81ce7042a27556fc95643977cc5a2ec27387988e50bb573fdf
|
||||
size 2123397800
|
||||
779
model.safetensors.index.json
Normal file
779
model.safetensors.index.json
Normal file
@@ -0,0 +1,779 @@
|
||||
{
|
||||
"metadata": {
|
||||
"total_parameters": 32763876352,
|
||||
"total_size": 65527752704
|
||||
},
|
||||
"weight_map": {
|
||||
"lm_head.weight": "model-00014-of-00014.safetensors",
|
||||
"model.embed_tokens.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.input_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.mlp.down_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.mlp.gate_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.mlp.up_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.post_attention_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.self_attn.k_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.self_attn.k_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.self_attn.o_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.self_attn.q_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.self_attn.q_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.self_attn.v_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.0.self_attn.v_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.input_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.mlp.down_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.mlp.gate_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.mlp.up_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.post_attention_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.self_attn.k_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.self_attn.k_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.self_attn.o_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.self_attn.q_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.self_attn.q_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.self_attn.v_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.1.self_attn.v_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.10.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.mlp.down_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.mlp.up_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.post_attention_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.self_attn.k_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.self_attn.o_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.self_attn.q_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.self_attn.v_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.10.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.mlp.down_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.mlp.up_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.post_attention_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.self_attn.k_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.self_attn.o_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.self_attn.q_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.self_attn.v_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.11.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.mlp.down_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.mlp.up_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.post_attention_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.self_attn.k_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.self_attn.o_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.self_attn.q_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.self_attn.v_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.12.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.13.input_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.13.mlp.down_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.13.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.13.mlp.up_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.13.post_attention_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.13.self_attn.k_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.13.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.13.self_attn.o_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.13.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.13.self_attn.q_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.13.self_attn.v_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.13.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.14.input_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.mlp.down_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.mlp.gate_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.mlp.up_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.post_attention_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.self_attn.k_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.self_attn.k_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.self_attn.o_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.self_attn.q_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.self_attn.q_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.self_attn.v_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.14.self_attn.v_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.input_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.mlp.down_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.mlp.gate_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.mlp.up_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.post_attention_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.self_attn.k_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.self_attn.k_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.self_attn.o_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.self_attn.q_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.self_attn.q_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.self_attn.v_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.15.self_attn.v_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.input_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.mlp.down_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.mlp.gate_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.mlp.up_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.post_attention_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.self_attn.k_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.self_attn.k_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.self_attn.o_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.self_attn.q_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.self_attn.q_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.self_attn.v_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.16.self_attn.v_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.input_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.mlp.down_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.mlp.gate_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.mlp.up_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.post_attention_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.self_attn.k_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.self_attn.k_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.self_attn.o_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.self_attn.q_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.self_attn.q_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.self_attn.v_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.17.self_attn.v_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.18.input_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.18.mlp.down_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.18.mlp.gate_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.18.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.18.post_attention_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.18.self_attn.k_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.18.self_attn.k_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.18.self_attn.o_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.18.self_attn.q_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.18.self_attn.q_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.18.self_attn.v_proj.bias": "model-00004-of-00014.safetensors",
|
||||
"model.layers.18.self_attn.v_proj.weight": "model-00004-of-00014.safetensors",
|
||||
"model.layers.19.input_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.mlp.down_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.mlp.gate_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.post_attention_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.self_attn.k_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.self_attn.k_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.self_attn.q_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.self_attn.q_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.self_attn.v_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.19.self_attn.v_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.2.input_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.mlp.down_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.mlp.gate_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.mlp.up_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.post_attention_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.self_attn.k_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.self_attn.k_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.self_attn.o_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.self_attn.q_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.self_attn.q_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.self_attn.v_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.2.self_attn.v_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.20.input_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.mlp.down_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.mlp.gate_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.post_attention_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.self_attn.k_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.self_attn.k_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.self_attn.q_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.self_attn.q_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.self_attn.v_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.20.self_attn.v_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.input_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.mlp.down_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.mlp.gate_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.post_attention_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.self_attn.k_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.self_attn.k_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.self_attn.q_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.self_attn.q_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.self_attn.v_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.21.self_attn.v_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.input_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.mlp.down_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.mlp.gate_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.post_attention_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.self_attn.k_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.self_attn.k_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.self_attn.q_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.self_attn.q_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.self_attn.v_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.22.self_attn.v_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.23.input_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.23.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.23.mlp.gate_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.23.mlp.up_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.23.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.23.self_attn.k_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.23.self_attn.k_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.23.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.23.self_attn.q_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.23.self_attn.q_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.23.self_attn.v_proj.bias": "model-00005-of-00014.safetensors",
|
||||
"model.layers.23.self_attn.v_proj.weight": "model-00005-of-00014.safetensors",
|
||||
"model.layers.24.input_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.mlp.gate_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.mlp.up_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.self_attn.o_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.self_attn.q_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.self_attn.q_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.self_attn.v_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.24.self_attn.v_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.input_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.mlp.gate_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.mlp.up_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.self_attn.o_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.self_attn.q_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.self_attn.q_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.self_attn.v_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.25.self_attn.v_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.input_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.mlp.gate_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.mlp.up_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.self_attn.o_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.self_attn.q_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.self_attn.q_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.self_attn.v_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.26.self_attn.v_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.input_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.mlp.gate_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.mlp.up_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.self_attn.o_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.self_attn.q_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.self_attn.q_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.self_attn.v_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.27.self_attn.v_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.28.input_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.28.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.28.mlp.gate_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.28.mlp.up_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.28.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.28.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.28.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.28.self_attn.o_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.28.self_attn.q_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.28.self_attn.q_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.28.self_attn.v_proj.bias": "model-00006-of-00014.safetensors",
|
||||
"model.layers.28.self_attn.v_proj.weight": "model-00006-of-00014.safetensors",
|
||||
"model.layers.29.input_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.mlp.gate_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.mlp.up_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.self_attn.o_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.29.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.3.input_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.3.mlp.down_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.3.mlp.gate_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.3.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.3.post_attention_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.3.self_attn.k_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.3.self_attn.k_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.3.self_attn.o_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.3.self_attn.q_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.3.self_attn.q_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.3.self_attn.v_proj.bias": "model-00001-of-00014.safetensors",
|
||||
"model.layers.3.self_attn.v_proj.weight": "model-00001-of-00014.safetensors",
|
||||
"model.layers.30.input_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.mlp.gate_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.mlp.up_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.self_attn.o_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.30.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.input_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.mlp.gate_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.mlp.up_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.self_attn.o_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.31.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.input_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.mlp.gate_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.mlp.up_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.self_attn.o_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.32.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.33.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.33.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.33.mlp.gate_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.33.mlp.up_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.33.post_attention_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.33.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.33.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.33.self_attn.o_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.33.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.33.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.33.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||
"model.layers.33.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||
"model.layers.34.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.mlp.up_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.post_attention_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.self_attn.k_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.self_attn.o_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.self_attn.q_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.self_attn.q_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.34.self_attn.v_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.mlp.up_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.post_attention_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.self_attn.k_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.self_attn.o_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.self_attn.q_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.self_attn.q_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.35.self_attn.v_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.mlp.up_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.post_attention_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.self_attn.k_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.self_attn.o_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.self_attn.q_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.self_attn.q_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.36.self_attn.v_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.mlp.up_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.post_attention_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.self_attn.k_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.self_attn.o_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.self_attn.q_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.self_attn.q_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.37.self_attn.v_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.38.input_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.38.mlp.down_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.38.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.38.mlp.up_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.38.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.38.self_attn.k_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.38.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.38.self_attn.o_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.38.self_attn.q_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.38.self_attn.q_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.38.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||
"model.layers.38.self_attn.v_proj.weight": "model-00008-of-00014.safetensors",
|
||||
"model.layers.39.input_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.mlp.down_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.mlp.up_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.self_attn.o_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.39.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.4.input_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.mlp.down_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.mlp.gate_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.post_attention_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.self_attn.k_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.self_attn.o_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.self_attn.q_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.self_attn.q_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.self_attn.v_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.4.self_attn.v_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.40.input_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.mlp.down_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.mlp.up_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.self_attn.o_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.40.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.input_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.mlp.down_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.mlp.up_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.self_attn.o_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.41.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.input_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.mlp.down_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.mlp.up_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.self_attn.o_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.42.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.43.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.43.mlp.down_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.43.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.43.mlp.up_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.43.post_attention_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.43.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.43.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.43.self_attn.o_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.43.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.43.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.43.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||
"model.layers.43.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||
"model.layers.44.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.mlp.down_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.mlp.gate_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.mlp.up_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.post_attention_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.self_attn.k_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.self_attn.k_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.self_attn.o_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.self_attn.v_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.44.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.mlp.down_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.mlp.gate_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.mlp.up_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.post_attention_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.self_attn.k_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.self_attn.k_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.self_attn.o_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.self_attn.v_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.45.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.mlp.down_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.mlp.gate_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.mlp.up_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.post_attention_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.self_attn.k_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.self_attn.k_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.self_attn.o_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.self_attn.v_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.46.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.mlp.down_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.mlp.gate_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.mlp.up_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.post_attention_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.self_attn.k_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.self_attn.k_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.self_attn.o_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.self_attn.v_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.47.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.48.input_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.48.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.48.mlp.gate_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.48.mlp.up_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.48.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.48.self_attn.k_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.48.self_attn.k_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.48.self_attn.o_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.48.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.48.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.48.self_attn.v_proj.bias": "model-00010-of-00014.safetensors",
|
||||
"model.layers.48.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||
"model.layers.49.input_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.mlp.gate_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.mlp.up_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.self_attn.k_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.self_attn.k_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.self_attn.o_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.self_attn.q_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.self_attn.v_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.49.self_attn.v_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.5.input_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.mlp.down_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.mlp.gate_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.post_attention_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.self_attn.k_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.self_attn.o_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.self_attn.q_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.self_attn.q_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.self_attn.v_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.5.self_attn.v_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.50.input_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.mlp.gate_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.mlp.up_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.self_attn.k_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.self_attn.k_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.self_attn.o_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.self_attn.q_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.self_attn.v_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.50.self_attn.v_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.input_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.mlp.gate_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.mlp.up_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.self_attn.k_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.self_attn.k_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.self_attn.o_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.self_attn.q_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.self_attn.v_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.51.self_attn.v_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.input_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.mlp.gate_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.mlp.up_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.self_attn.k_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.self_attn.k_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.self_attn.o_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.self_attn.q_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.self_attn.v_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.52.self_attn.v_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.53.input_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.53.mlp.down_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.53.mlp.gate_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.53.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.53.post_attention_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.53.self_attn.k_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.53.self_attn.k_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.53.self_attn.o_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.53.self_attn.q_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.53.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.53.self_attn.v_proj.bias": "model-00011-of-00014.safetensors",
|
||||
"model.layers.53.self_attn.v_proj.weight": "model-00011-of-00014.safetensors",
|
||||
"model.layers.54.input_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.mlp.down_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.mlp.gate_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.post_attention_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.self_attn.k_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.self_attn.k_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.self_attn.q_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.self_attn.q_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.self_attn.v_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.54.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.input_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.mlp.down_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.mlp.gate_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.post_attention_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.self_attn.k_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.self_attn.k_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.self_attn.q_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.self_attn.q_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.self_attn.v_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.55.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.input_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.mlp.down_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.mlp.gate_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.post_attention_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.self_attn.k_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.self_attn.k_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.self_attn.q_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.self_attn.q_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.self_attn.v_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.56.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.input_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.mlp.down_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.mlp.gate_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.post_attention_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.self_attn.k_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.self_attn.k_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.self_attn.q_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.self_attn.q_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.self_attn.v_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.57.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.58.input_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.58.mlp.down_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.58.mlp.gate_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.58.mlp.up_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.58.post_attention_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.58.self_attn.k_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.58.self_attn.k_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.58.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.58.self_attn.q_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.58.self_attn.q_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.58.self_attn.v_proj.bias": "model-00012-of-00014.safetensors",
|
||||
"model.layers.58.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||
"model.layers.59.input_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.mlp.down_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.mlp.up_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.post_attention_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.self_attn.k_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.self_attn.k_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.self_attn.o_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.self_attn.q_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.self_attn.q_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.59.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.6.input_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.mlp.down_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.mlp.gate_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.post_attention_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.self_attn.k_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.self_attn.o_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.self_attn.q_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.self_attn.q_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.self_attn.v_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.6.self_attn.v_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.60.input_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.mlp.down_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.mlp.up_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.post_attention_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.self_attn.k_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.self_attn.k_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.self_attn.o_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.self_attn.q_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.self_attn.q_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.60.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.input_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.mlp.down_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.mlp.up_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.post_attention_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.self_attn.k_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.self_attn.k_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.self_attn.o_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.self_attn.q_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.self_attn.q_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.61.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.input_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.mlp.down_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.mlp.up_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.post_attention_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.self_attn.k_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.self_attn.k_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.self_attn.o_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.self_attn.q_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.self_attn.q_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.62.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.63.input_layernorm.weight": "model-00014-of-00014.safetensors",
|
||||
"model.layers.63.mlp.down_proj.weight": "model-00014-of-00014.safetensors",
|
||||
"model.layers.63.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.63.mlp.up_proj.weight": "model-00014-of-00014.safetensors",
|
||||
"model.layers.63.post_attention_layernorm.weight": "model-00014-of-00014.safetensors",
|
||||
"model.layers.63.self_attn.k_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.63.self_attn.k_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.63.self_attn.o_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.63.self_attn.q_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.63.self_attn.q_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.63.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||
"model.layers.63.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||
"model.layers.7.input_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.mlp.down_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.mlp.gate_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.post_attention_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.self_attn.k_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.self_attn.o_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.self_attn.q_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.self_attn.q_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.self_attn.v_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.7.self_attn.v_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.8.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.8.mlp.down_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.8.mlp.gate_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.8.mlp.up_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.8.post_attention_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.8.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.8.self_attn.k_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.8.self_attn.o_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.8.self_attn.q_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.8.self_attn.q_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.8.self_attn.v_proj.bias": "model-00002-of-00014.safetensors",
|
||||
"model.layers.8.self_attn.v_proj.weight": "model-00002-of-00014.safetensors",
|
||||
"model.layers.9.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.mlp.down_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.mlp.up_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.post_attention_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.self_attn.k_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.self_attn.o_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.self_attn.q_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.self_attn.v_proj.bias": "model-00003-of-00014.safetensors",
|
||||
"model.layers.9.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||
"model.norm.weight": "model-00014-of-00014.safetensors"
|
||||
}
|
||||
}
|
||||
31
special_tokens_map.json
Normal file
31
special_tokens_map.json
Normal file
@@ -0,0 +1,31 @@
|
||||
{
|
||||
"additional_special_tokens": [
|
||||
"<|im_start|>",
|
||||
"<|im_end|>",
|
||||
"<|object_ref_start|>",
|
||||
"<|object_ref_end|>",
|
||||
"<|box_start|>",
|
||||
"<|box_end|>",
|
||||
"<|quad_start|>",
|
||||
"<|quad_end|>",
|
||||
"<|vision_start|>",
|
||||
"<|vision_end|>",
|
||||
"<|vision_pad|>",
|
||||
"<|image_pad|>",
|
||||
"<|video_pad|>"
|
||||
],
|
||||
"eos_token": {
|
||||
"content": "<|im_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
},
|
||||
"pad_token": {
|
||||
"content": "<|endoftext|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
}
|
||||
}
|
||||
3
tokenizer.json
Normal file
3
tokenizer.json
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:a8ca367b714d9d9f3790a7626974cf2ece38c267640196be1af09af8f3367ae7
|
||||
size 11422162
|
||||
207
tokenizer_config.json
Normal file
207
tokenizer_config.json
Normal file
@@ -0,0 +1,207 @@
|
||||
{
|
||||
"add_bos_token": false,
|
||||
"add_prefix_space": false,
|
||||
"added_tokens_decoder": {
|
||||
"151643": {
|
||||
"content": "<|endoftext|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151644": {
|
||||
"content": "<|im_start|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151645": {
|
||||
"content": "<|im_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151646": {
|
||||
"content": "<|object_ref_start|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151647": {
|
||||
"content": "<|object_ref_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151648": {
|
||||
"content": "<|box_start|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151649": {
|
||||
"content": "<|box_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151650": {
|
||||
"content": "<|quad_start|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151651": {
|
||||
"content": "<|quad_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151652": {
|
||||
"content": "<|vision_start|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151653": {
|
||||
"content": "<|vision_end|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151654": {
|
||||
"content": "<|vision_pad|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151655": {
|
||||
"content": "<|image_pad|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151656": {
|
||||
"content": "<|video_pad|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"151657": {
|
||||
"content": "<tool_call>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151658": {
|
||||
"content": "</tool_call>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151659": {
|
||||
"content": "<|fim_prefix|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151660": {
|
||||
"content": "<|fim_middle|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151661": {
|
||||
"content": "<|fim_suffix|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151662": {
|
||||
"content": "<|fim_pad|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151663": {
|
||||
"content": "<|repo_name|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
},
|
||||
"151664": {
|
||||
"content": "<|file_sep|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": false
|
||||
}
|
||||
},
|
||||
"additional_special_tokens": [
|
||||
"<|im_start|>",
|
||||
"<|im_end|>",
|
||||
"<|object_ref_start|>",
|
||||
"<|object_ref_end|>",
|
||||
"<|box_start|>",
|
||||
"<|box_end|>",
|
||||
"<|quad_start|>",
|
||||
"<|quad_end|>",
|
||||
"<|vision_start|>",
|
||||
"<|vision_end|>",
|
||||
"<|vision_pad|>",
|
||||
"<|image_pad|>",
|
||||
"<|video_pad|>"
|
||||
],
|
||||
"bos_token": null,
|
||||
"clean_up_tokenization_spaces": false,
|
||||
"eos_token": "<|im_end|>",
|
||||
"errors": "replace",
|
||||
"extra_special_tokens": {},
|
||||
"model_max_length": 32768,
|
||||
"pad_token": "<|endoftext|>",
|
||||
"split_special_tokens": false,
|
||||
"tokenizer_class": "Qwen2Tokenizer",
|
||||
"unk_token": null
|
||||
}
|
||||
1
vocab.json
Normal file
1
vocab.json
Normal file
File diff suppressed because one or more lines are too long
Reference in New Issue
Block a user