初始化项目,由ModelHub XC社区提供模型
Model: TIGER-Lab/StructLM-7B
Source: Original Platform
This commit is contained in:
 ModelHub XC
35
.gitattributes
vendored
Normal file
35
.gitattributes
vendored
Normal file
@@ -0,0 +1,35 @@
|
||||
*.7z filter=lfs diff=lfs merge=lfs -text
|
||||
*.arrow filter=lfs diff=lfs merge=lfs -text
|
||||
*.bin filter=lfs diff=lfs merge=lfs -text
|
||||
*.bz2 filter=lfs diff=lfs merge=lfs -text
|
||||
*.ckpt filter=lfs diff=lfs merge=lfs -text
|
||||
*.ftz filter=lfs diff=lfs merge=lfs -text
|
||||
*.gz filter=lfs diff=lfs merge=lfs -text
|
||||
*.h5 filter=lfs diff=lfs merge=lfs -text
|
||||
*.joblib filter=lfs diff=lfs merge=lfs -text
|
||||
*.lfs.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.mlmodel filter=lfs diff=lfs merge=lfs -text
|
||||
*.model filter=lfs diff=lfs merge=lfs -text
|
||||
*.msgpack filter=lfs diff=lfs merge=lfs -text
|
||||
*.npy filter=lfs diff=lfs merge=lfs -text
|
||||
*.npz filter=lfs diff=lfs merge=lfs -text
|
||||
*.onnx filter=lfs diff=lfs merge=lfs -text
|
||||
*.ot filter=lfs diff=lfs merge=lfs -text
|
||||
*.parquet filter=lfs diff=lfs merge=lfs -text
|
||||
*.pb filter=lfs diff=lfs merge=lfs -text
|
||||
*.pickle filter=lfs diff=lfs merge=lfs -text
|
||||
*.pkl filter=lfs diff=lfs merge=lfs -text
|
||||
*.pt filter=lfs diff=lfs merge=lfs -text
|
||||
*.pth filter=lfs diff=lfs merge=lfs -text
|
||||
*.rar filter=lfs diff=lfs merge=lfs -text
|
||||
*.safetensors filter=lfs diff=lfs merge=lfs -text
|
||||
saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
||||
*.tar.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.tar filter=lfs diff=lfs merge=lfs -text
|
||||
*.tflite filter=lfs diff=lfs merge=lfs -text
|
||||
*.tgz filter=lfs diff=lfs merge=lfs -text
|
||||
*.wasm filter=lfs diff=lfs merge=lfs -text
|
||||
*.xz filter=lfs diff=lfs merge=lfs -text
|
||||
*.zip filter=lfs diff=lfs merge=lfs -text
|
||||
*.zst filter=lfs diff=lfs merge=lfs -text
|
||||
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
||||
130
README.md
Normal file
130
README.md
Normal file
@@ -0,0 +1,130 @@
|
||||
---
|
||||
license: mit
|
||||
datasets:
|
||||
- TIGER-Lab/SKGInstruct
|
||||
language:
|
||||
- en
|
||||
---
|
||||
# 🏗️ StructLM: Towards Building Generalist Models for Structured Knowledge Grounding
|
||||
|
||||
Project Page: [https://tiger-ai-lab.github.io/StructLM/](https://tiger-ai-lab.github.io/StructLM/)
|
||||
|
||||
Paper: [https://arxiv.org/pdf/2402.16671.pdf](https://arxiv.org/pdf/2402.16671.pdf)
|
||||
|
||||
Code: [https://github.com/TIGER-AI-Lab/StructLM](https://github.com/TIGER-AI-Lab/StructLM)
|
||||
|
||||
<span style="color:red">This checkpoing has been updated to the correct version, feel free to use it.</span>
|
||||
|
||||
|
||||
|
||||
## Introduction
|
||||
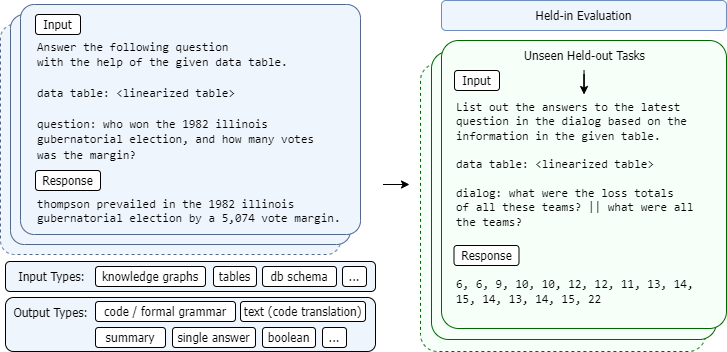
StructLM, is a series of open-source large language models (LLMs) finetuned for structured knowledge grounding (SKG) tasks. We release 3 models:
|
||||
|
||||
7B | [StructLM-7B](https://huggingface.co/TIGER-Lab/StructLM-7B)
|
||||
|
||||
13B | [StructLM-13B](https://huggingface.co/TIGER-Lab/StructLM-13B)
|
||||
|
||||
34B | [StructLM-34B](https://huggingface.co/TIGER-Lab/StructLM-34B)
|
||||
|
||||
|
||||
## Training Data
|
||||
These models are trained on 🤗 [SKGInstruct Dataset](https://huggingface.co/datasets/TIGER-Lab/SKGInstruct), an instruction-tuning dataset containing mixture of 19 SKG tasks combined with 🤗 [SlimOrca](https://huggingface.co/datasets/Open-Orca/SlimOrca). Check out the dataset card for more details.
|
||||
|
||||
|
||||
## Training Procedure
|
||||
The models are fine-tuned with CodeLlama-Instruct-hf models as base models. Each model is trained for 3 epochs, and the best checkpoint is selected.
|
||||
|
||||
## Evaluation
|
||||
Here are a subset of model evaluation results:
|
||||
|
||||
### Held in
|
||||
|
||||
| **Model** | **ToTTo** | **GrailQA** | **CompWebQ** | **MMQA** | **Feverous** | **Spider** | **TabFact** | **Dart** |
|
||||
|-----------------------|--------------|----------|----------|----------|----------|----------|----------|----------|
|
||||
| **StructLM-7B** | 49.4 | 80.4 | 78.3 | 85.2 | 84.4 | 72.4 | 80.8 | 62.2 |
|
||||
| **StructLM-13B** | 49.3 | 79.2 | 80.4 | 86.0 | 85.0 | 74.1 | 84.7 | 61.4 |
|
||||
| **StructLM-34B** | 50.2 | 82.2 | 81.9 | 88.1 | 85.7 | 74.6 | 86.6 | 61.8 |
|
||||
|
||||
|
||||
### Held out
|
||||
| **Model** | **BIRD** | **InfoTabs** | **FinQA** | **SQA** |
|
||||
|-----------------------|--------------|----------|----------|----------|
|
||||
| **StructLM-7B** | 22.3 | 55.3 | 27.3 | 49.7 |
|
||||
| **StructLM-13B** | 22.8 | 58.1 | 25.6 | 36.1 |
|
||||
| **StructLM-34B** | 24.7 | 61.8 | 36.2 | 44.2 |
|
||||
|
||||
|
||||
## Usage
|
||||
You can use the models through Huggingface's Transformers library.
|
||||
Check our Github repo for the evaluation code: [https://github.com/TIGER-AI-Lab/StructLM](https://github.com/TIGER-AI-Lab/StructLM)
|
||||
|
||||
|
||||
## Prompt Format
|
||||
|
||||
**For this 7B model, the prompt format (different from 13B, 34B) is**
|
||||
```
|
||||
[INST] <<SYS>>
|
||||
You are an AI assistant that specializes in analyzing and reasoning over structured information. You will be given a task, optionally with some structured knowledge input. Your answer must strictly adhere to the output format, if specified.
|
||||
<</SYS>>
|
||||
{instruction} [/INST]
|
||||
```
|
||||
|
||||
To see concrete examples of this linearization, you can directly reference the 🤗 [SKGInstruct Dataset](https://huggingface.co/datasets/TIGER-Lab/SKGInstruct) (coming soon).
|
||||
We will provide code for linearizing this data shortly.
|
||||
|
||||
|
||||
A few examples:
|
||||
|
||||
**Tabular data**
|
||||
```
|
||||
col : day | kilometers row 1 : tuesday | 0 row 2 : wednesday | 0 row 3 : thursday | 4 row 4 : friday | 0 row 5 : saturday | 0
|
||||
```
|
||||
|
||||
**Knowledge triples (dart)**
|
||||
```
|
||||
Hawaii Five-O : notes : Episode: The Flight of the Jewels | [TABLECONTEXT] : [title] : Jeff Daniels | [TABLECONTEXT] : title : Hawaii Five-O
|
||||
```
|
||||
|
||||
**Knowledge graph schema (grailqa)**
|
||||
```
|
||||
top antiquark: m.094nrqp | physics.particle_antiparticle.self_antiparticle physics.particle_family physics.particle.antiparticle physics.particle_family.subclasses physics.subatomic_particle_generation physics.particle_family.particles physics.particle common.image.appears_in_topic_gallery physics.subatomic_particle_generation.particles physics.particle.family physics.particle_family.parent_class physics.particle_antiparticle physics.particle_antiparticle.particle physics.particle.generation
|
||||
```
|
||||
|
||||
**Example input**
|
||||
|
||||
```
|
||||
[INST] <<SYS>>
|
||||
You are an AI assistant that specializes in analyzing and reasoning over structured information. You will be given a task, optionally with some structured knowledge input. Your answer must strictly adhere to the output format, if specified.
|
||||
<</SYS>>
|
||||
|
||||
Use the information in the following table to solve the problem, choose between the choices if they are provided. table:
|
||||
|
||||
col : day | kilometers row 1 : tuesday | 0 row 2 : wednesday | 0 row 3 : thursday | 4 row 4 : friday | 0 row 5 : saturday | 0
|
||||
|
||||
|
||||
question:
|
||||
|
||||
Allie kept track of how many kilometers she walked during the past 5 days. What is the range of the numbers? [/INST]
|
||||
```
|
||||
|
||||
|
||||
## Intended Uses
|
||||
These models are trained for research purposes. They are designed to be proficient in interpreting linearized structured input. Downstream uses can potentially include various applications requiring the interpretation of structured data.
|
||||
|
||||
## Limitations
|
||||
While we've tried to build an SKG-specialized model capable of generalizing, we have shown that this is a challenging domain, and it may lack performance characteristics that allow it to be directly used in chat or other applications.
|
||||
|
||||
|
||||
## Citation
|
||||
If you use the models, data, or code from this project, please cite the original paper:
|
||||
|
||||
```
|
||||
@misc{zhuang2024structlm,
|
||||
title={StructLM: Towards Building Generalist Models for Structured Knowledge Grounding},
|
||||
author={Alex Zhuang and Ge Zhang and Tianyu Zheng and Xinrun Du and Junjie Wang and Weiming Ren and Stephen W. Huang and Jie Fu and Xiang Yue and Wenhu Chen},
|
||||
year={2024},
|
||||
eprint={2402.16671},
|
||||
archivePrefix={arXiv},
|
||||
primaryClass={cs.CL}
|
||||
}
|
||||
```
|
||||
30
config.json
Normal file
30
config.json
Normal file
@@ -0,0 +1,30 @@
|
||||
{
|
||||
"_name_or_path": "/home/azhuang/CodeLlama-7b-Instruct-hf",
|
||||
"architectures": [
|
||||
"LlamaForCausalLM"
|
||||
],
|
||||
"attention_bias": false,
|
||||
"attention_dropout": 0.0,
|
||||
"bos_token_id": 1,
|
||||
"eos_token_id": 2,
|
||||
"head_dim": 128,
|
||||
"hidden_act": "silu",
|
||||
"hidden_size": 4096,
|
||||
"initializer_range": 0.02,
|
||||
"intermediate_size": 11008,
|
||||
"max_position_embeddings": 16384,
|
||||
"mlp_bias": false,
|
||||
"model_type": "llama",
|
||||
"num_attention_heads": 32,
|
||||
"num_hidden_layers": 32,
|
||||
"num_key_value_heads": 32,
|
||||
"pretraining_tp": 1,
|
||||
"rms_norm_eps": 1e-05,
|
||||
"rope_scaling": null,
|
||||
"rope_theta": 1000000,
|
||||
"tie_word_embeddings": false,
|
||||
"torch_dtype": "bfloat16",
|
||||
"transformers_version": "4.45.0",
|
||||
"use_cache": false,
|
||||
"vocab_size": 32016
|
||||
}
|
||||
1
configuration.json
Normal file
1
configuration.json
Normal file
@@ -0,0 +1 @@
|
||||
{"framework": "pytorch", "task": "text-generation", "allow_remote": true}
|
||||
6
generation_config.json
Normal file
6
generation_config.json
Normal file
@@ -0,0 +1,6 @@
|
||||
{
|
||||
"_from_model_config": true,
|
||||
"bos_token_id": 1,
|
||||
"eos_token_id": 2,
|
||||
"transformers_version": "4.45.0"
|
||||
}
|
||||
3
model-00001-of-00003.safetensors
Normal file
3
model-00001-of-00003.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:b3a88670dc47a655be9bec1230bbcf936ac900ad5786797fd731b30789c2bfd3
|
||||
size 4939116424
|
||||
3
model-00002-of-00003.safetensors
Normal file
3
model-00002-of-00003.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:ff1afbfb752bd0bf541812a6933918f2dc353e0fb78245141ad961dae4759ad3
|
||||
size 4947390880
|
||||
3
model-00003-of-00003.safetensors
Normal file
3
model-00003-of-00003.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:d646f796359e02f0e0f7496b204a909d37a9dcd425c85a3fa792a5291bc98bcf
|
||||
size 3590619888
|
||||
298
model.safetensors.index.json
Normal file
298
model.safetensors.index.json
Normal file
@@ -0,0 +1,298 @@
|
||||
{
|
||||
"metadata": {
|
||||
"total_size": 13477093376
|
||||
},
|
||||
"weight_map": {
|
||||
"lm_head.weight": "model-00003-of-00003.safetensors",
|
||||
"model.embed_tokens.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.0.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.0.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.0.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.0.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.0.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.0.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.0.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.0.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.0.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.1.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.1.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.1.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.1.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.1.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.1.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.1.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.1.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.1.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.10.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.10.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.10.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.10.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.10.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.10.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.10.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.10.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.10.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.11.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.11.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.11.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.11.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.11.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.11.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.11.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.11.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.11.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.12.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.12.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.12.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.12.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.12.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.12.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.12.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.12.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.12.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.13.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.13.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.13.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.13.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.13.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.13.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.13.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.13.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.13.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.14.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.14.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.14.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.14.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.14.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.14.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.14.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.14.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.14.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.15.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.15.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.15.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.15.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.15.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.15.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.15.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.15.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.15.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.16.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.16.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.16.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.16.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.16.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.16.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.16.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.16.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.16.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.17.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.17.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.17.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.17.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.17.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.17.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.17.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.17.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.17.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.18.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.18.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.18.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.18.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.18.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.18.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.18.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.18.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.18.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.19.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.19.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.19.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.19.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.19.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.19.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.19.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.19.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.19.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.2.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.2.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.2.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.2.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.2.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.2.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.2.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.2.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.2.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.20.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.20.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.20.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.20.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.20.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.20.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.20.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.20.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.20.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.21.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.21.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.21.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.21.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.21.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.21.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.21.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.21.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.21.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.22.input_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.22.mlp.down_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.22.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.22.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.22.post_attention_layernorm.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.22.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.22.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.22.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.22.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.23.input_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.23.mlp.down_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.23.mlp.gate_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.23.mlp.up_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.23.post_attention_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.23.self_attn.k_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.23.self_attn.o_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.23.self_attn.q_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.23.self_attn.v_proj.weight": "model-00002-of-00003.safetensors",
|
||||
"model.layers.24.input_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.24.mlp.down_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.24.mlp.gate_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.24.mlp.up_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.24.post_attention_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.24.self_attn.k_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.24.self_attn.o_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.24.self_attn.q_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.24.self_attn.v_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.25.input_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.25.mlp.down_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.25.mlp.gate_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.25.mlp.up_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.25.post_attention_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.25.self_attn.k_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.25.self_attn.o_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.25.self_attn.q_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.25.self_attn.v_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.26.input_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.26.mlp.down_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.26.mlp.gate_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.26.mlp.up_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.26.post_attention_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.26.self_attn.k_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.26.self_attn.o_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.26.self_attn.q_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.26.self_attn.v_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.27.input_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.27.mlp.down_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.27.mlp.gate_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.27.mlp.up_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.27.post_attention_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.27.self_attn.k_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.27.self_attn.o_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.27.self_attn.q_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.27.self_attn.v_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.28.input_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.28.mlp.down_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.28.mlp.gate_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.28.mlp.up_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.28.post_attention_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.28.self_attn.k_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.28.self_attn.o_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.28.self_attn.q_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.28.self_attn.v_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.29.input_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.29.mlp.down_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.29.mlp.gate_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.29.mlp.up_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.29.post_attention_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.29.self_attn.k_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.29.self_attn.o_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.29.self_attn.q_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.29.self_attn.v_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.3.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.3.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.3.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.3.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.3.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.3.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.3.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.3.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.3.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.30.input_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.30.mlp.down_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.30.mlp.gate_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.30.mlp.up_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.30.post_attention_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.30.self_attn.k_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.30.self_attn.o_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.30.self_attn.q_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.30.self_attn.v_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.31.input_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.31.mlp.down_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.31.mlp.gate_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.31.mlp.up_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.31.post_attention_layernorm.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.31.self_attn.k_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.31.self_attn.o_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.31.self_attn.q_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.31.self_attn.v_proj.weight": "model-00003-of-00003.safetensors",
|
||||
"model.layers.4.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.4.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.4.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.4.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.4.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.4.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.4.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.4.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.4.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.5.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.5.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.5.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.5.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.5.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.5.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.5.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.5.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.5.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.6.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.6.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.6.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.6.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.6.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.6.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.6.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.6.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.6.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.7.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.7.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.7.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.7.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.7.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.7.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.7.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.7.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.7.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.8.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.8.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.8.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.8.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.8.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.8.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.8.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.8.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.8.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.9.input_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.9.mlp.down_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.9.mlp.gate_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.9.mlp.up_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.9.post_attention_layernorm.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.9.self_attn.k_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.9.self_attn.o_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.9.self_attn.q_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.layers.9.self_attn.v_proj.weight": "model-00001-of-00003.safetensors",
|
||||
"model.norm.weight": "model-00003-of-00003.safetensors"
|
||||
}
|
||||
}
|
||||
30
special_tokens_map.json
Normal file
30
special_tokens_map.json
Normal file
@@ -0,0 +1,30 @@
|
||||
{
|
||||
"additional_special_tokens": [
|
||||
"▁<PRE>",
|
||||
"▁<MID>",
|
||||
"▁<SUF>",
|
||||
"▁<EOT>"
|
||||
],
|
||||
"bos_token": {
|
||||
"content": "<s>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
},
|
||||
"eos_token": {
|
||||
"content": "</s>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
},
|
||||
"pad_token": "</s>",
|
||||
"unk_token": {
|
||||
"content": "<unk>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
}
|
||||
}
|
||||
277235
tokenizer.json
Normal file
277235
tokenizer.json
Normal file
File diff suppressed because it is too large
Load Diff
3
tokenizer.model
Normal file
3
tokenizer.model
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:45ccb9c8b6b561889acea59191d66986d314e7cbd6a78abc6e49b139ca91c1e6
|
||||
size 500058
|
||||
86
tokenizer_config.json
Normal file
86
tokenizer_config.json
Normal file
@@ -0,0 +1,86 @@
|
||||
{
|
||||
"add_bos_token": true,
|
||||
"add_eos_token": false,
|
||||
"added_tokens_decoder": {
|
||||
"0": {
|
||||
"content": "<unk>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"1": {
|
||||
"content": "<s>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"2": {
|
||||
"content": "</s>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"32007": {
|
||||
"content": "▁<PRE>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"32008": {
|
||||
"content": "▁<SUF>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"32009": {
|
||||
"content": "▁<MID>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
},
|
||||
"32010": {
|
||||
"content": "▁<EOT>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false,
|
||||
"special": true
|
||||
}
|
||||
},
|
||||
"additional_special_tokens": [
|
||||
"▁<PRE>",
|
||||
"▁<MID>",
|
||||
"▁<SUF>",
|
||||
"▁<EOT>"
|
||||
],
|
||||
"bos_token": "<s>",
|
||||
"chat_template": "{% if messages[0]['role'] == 'system' %}{% set system_message = messages[0]['content'] %}{% endif %}{% for message in messages %}{% set content = message['content'] %}{% if loop.index0 == 0 and system_message is defined %}{% set content = '<<SYS>>\n' + system_message + '\n<</SYS>>\n\n' + message['content'] %}{% endif %}{% if message['role'] == 'user' %}{{ '<s>' + '[INST] ' + content + ' [/INST]' }}{% elif message['role'] == 'assistant' %}{{ content + '</s>' }}{% endif %}{% endfor %}",
|
||||
"clean_up_tokenization_spaces": false,
|
||||
"eos_token": "</s>",
|
||||
"eot_token": "▁<EOT>",
|
||||
"fill_token": "<FILL_ME>",
|
||||
"legacy": null,
|
||||
"middle_token": "▁<MID>",
|
||||
"model_max_length": 1000000000000000019884624838656,
|
||||
"pad_token": "</s>",
|
||||
"padding_side": "right",
|
||||
"prefix_token": "▁<PRE>",
|
||||
"sp_model_kwargs": {},
|
||||
"split_special_tokens": false,
|
||||
"suffix_token": "▁<SUF>",
|
||||
"tokenizer_class": "CodeLlamaTokenizer",
|
||||
"unk_token": "<unk>",
|
||||
"use_default_system_prompt": false
|
||||
}
|
||||
3183
trainer_state.json
Normal file
3183
trainer_state.json
Normal file
File diff suppressed because it is too large
Load Diff
Reference in New Issue
Block a user