初始化项目,由ModelHub XC社区提供模型
Model: RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf
Source: Original Platform
This commit is contained in:
 ModelHub XC
54
.gitattributes
vendored
Normal file
54
.gitattributes
vendored
Normal file
@@ -0,0 +1,54 @@
|
||||
*.7z filter=lfs diff=lfs merge=lfs -text
|
||||
*.arrow filter=lfs diff=lfs merge=lfs -text
|
||||
*.bin filter=lfs diff=lfs merge=lfs -text
|
||||
*.bz2 filter=lfs diff=lfs merge=lfs -text
|
||||
*.ckpt filter=lfs diff=lfs merge=lfs -text
|
||||
*.ftz filter=lfs diff=lfs merge=lfs -text
|
||||
*.gz filter=lfs diff=lfs merge=lfs -text
|
||||
*.h5 filter=lfs diff=lfs merge=lfs -text
|
||||
*.joblib filter=lfs diff=lfs merge=lfs -text
|
||||
*.lfs.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.mlmodel filter=lfs diff=lfs merge=lfs -text
|
||||
*.model filter=lfs diff=lfs merge=lfs -text
|
||||
*.msgpack filter=lfs diff=lfs merge=lfs -text
|
||||
*.npy filter=lfs diff=lfs merge=lfs -text
|
||||
*.npz filter=lfs diff=lfs merge=lfs -text
|
||||
*.onnx filter=lfs diff=lfs merge=lfs -text
|
||||
*.ot filter=lfs diff=lfs merge=lfs -text
|
||||
*.parquet filter=lfs diff=lfs merge=lfs -text
|
||||
*.pb filter=lfs diff=lfs merge=lfs -text
|
||||
*.pickle filter=lfs diff=lfs merge=lfs -text
|
||||
*.pkl filter=lfs diff=lfs merge=lfs -text
|
||||
*.pt filter=lfs diff=lfs merge=lfs -text
|
||||
*.pth filter=lfs diff=lfs merge=lfs -text
|
||||
*.rar filter=lfs diff=lfs merge=lfs -text
|
||||
*.safetensors filter=lfs diff=lfs merge=lfs -text
|
||||
saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
||||
*.tar.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.tar filter=lfs diff=lfs merge=lfs -text
|
||||
*.tflite filter=lfs diff=lfs merge=lfs -text
|
||||
*.tgz filter=lfs diff=lfs merge=lfs -text
|
||||
*.wasm filter=lfs diff=lfs merge=lfs -text
|
||||
*.xz filter=lfs diff=lfs merge=lfs -text
|
||||
*.zip filter=lfs diff=lfs merge=lfs -text
|
||||
*.zst filter=lfs diff=lfs merge=lfs -text
|
||||
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q2_K.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q3_K_S.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q3_K.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q3_K_M.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q3_K_L.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.IQ4_XS.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q4_0.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.IQ4_NL.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q4_K_S.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q4_K.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q4_K_M.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q4_1.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q5_0.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q5_K_S.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q5_K.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q5_K_M.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q5_1.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q6_K.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
CursorCore-Yi-1.5B-SR.Q8_0.gguf filter=lfs diff=lfs merge=lfs -text
|
||||
3
CursorCore-Yi-1.5B-SR.IQ4_NL.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.IQ4_NL.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:42bb0910d3f141c4272e01a488654ef7cbe368cd660a21981420be5d5250b113
|
||||
size 872681600
|
||||
3
CursorCore-Yi-1.5B-SR.IQ4_XS.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.IQ4_XS.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:9981be8c24951ca4bc257a0fae9fe2b6e3545009184cd3d193d3f6c02395b9f6
|
||||
size 839090304
|
||||
3
CursorCore-Yi-1.5B-SR.Q2_K.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q2_K.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:10665aac298485b8478182ea97ab6a700851ec6268e07d602018cfb51d4e8955
|
||||
size 634853504
|
||||
3
CursorCore-Yi-1.5B-SR.Q3_K.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q3_K.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:50c42ee1884578233c78933e3c9bc09b3747fef9f7a696cc570daae6de55e40a
|
||||
size 785886336
|
||||
3
CursorCore-Yi-1.5B-SR.Q3_K_L.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q3_K_L.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:e27cca6134da20f60258f36053c090ac96de477ee30b90d0dbb708ea9fe2718d
|
||||
size 826207360
|
||||
3
CursorCore-Yi-1.5B-SR.Q3_K_M.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q3_K_M.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:50c42ee1884578233c78933e3c9bc09b3747fef9f7a696cc570daae6de55e40a
|
||||
size 785886336
|
||||
3
CursorCore-Yi-1.5B-SR.Q3_K_S.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q3_K_S.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:cb93d4ea01f5c25842404aefd4c91308f2f67f0fdd54de959d985824d38af29b
|
||||
size 723577984
|
||||
3
CursorCore-Yi-1.5B-SR.Q4_0.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q4_0.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:78ef720bcdd823a0ab67cc7a7d60f4c54925b6289a392641fa2c75487aac390d
|
||||
size 866340992
|
||||
3
CursorCore-Yi-1.5B-SR.Q4_1.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q4_1.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:48c9027ee03dc511b38bdf06e216648ebbc841207f9d523197c954abcd64af4e
|
||||
size 950431872
|
||||
3
CursorCore-Yi-1.5B-SR.Q4_K.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q4_K.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:abb3c3f525df448e8acfe2cde991bc6cc9ecd6e9222d452b0a2a00d12103c424
|
||||
size 963858560
|
||||
3
CursorCore-Yi-1.5B-SR.Q4_K_M.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q4_K_M.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:abb3c3f525df448e8acfe2cde991bc6cc9ecd6e9222d452b0a2a00d12103c424
|
||||
size 963858560
|
||||
3
CursorCore-Yi-1.5B-SR.Q4_K_S.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q4_K_S.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:fba419c76e745ea73bcbd582ab04afa4c6c80bdcb9b8e3e3fc67041ea7b87766
|
||||
size 904368256
|
||||
3
CursorCore-Yi-1.5B-SR.Q5_0.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q5_0.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:25673154907337065b40a84d9a9e2fbdf0d7b9209cf400eba907cabcee01287d
|
||||
size 1034522752
|
||||
3
CursorCore-Yi-1.5B-SR.Q5_1.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q5_1.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:cf15ce725e963a8d43c19e5f7fac318084692dfdfc0fa52b03dfd762b85602de
|
||||
size 1118613632
|
||||
3
CursorCore-Yi-1.5B-SR.Q5_K.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q5_K.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:edfc4e95de1c1535c507b8c6e91ff932c1fb03d8fc60745c3054437e398a7eb1
|
||||
size 1100386432
|
||||
3
CursorCore-Yi-1.5B-SR.Q5_K_M.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q5_K_M.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:edfc4e95de1c1535c507b8c6e91ff932c1fb03d8fc60745c3054437e398a7eb1
|
||||
size 1100386432
|
||||
3
CursorCore-Yi-1.5B-SR.Q5_K_S.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q5_K_S.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:f5dc39086bdf305f7ed5ea39438d4341474e21461d78c835c5c058e1618f4035
|
||||
size 1051431040
|
||||
3
CursorCore-Yi-1.5B-SR.Q6_K.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q6_K.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:868b149887bbfbe386b23d78a20ba418325ba0a6032ce14e04d95c8b49ac0277
|
||||
size 1278735488
|
||||
3
CursorCore-Yi-1.5B-SR.Q8_0.gguf
Normal file
3
CursorCore-Yi-1.5B-SR.Q8_0.gguf
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:2f3be1a700c5f0a43ced321f4642d62a157b1547b843de2f7ad2d7eef9a89d4c
|
||||
size 1570843776
|
||||
472
README.md
Normal file
472
README.md
Normal file
@@ -0,0 +1,472 @@
|
||||
---
|
||||
license: apache-2.0
|
||||
library_name: transformers
|
||||
pipeline_tag: text-generation
|
||||
tags:
|
||||
- code
|
||||
base_model:
|
||||
- 01-ai/Yi-Coder-1.5B
|
||||
---
|
||||
|
||||
This repository contains GGUF-quantized weights by Richard Erkhov for the model introduced in [CursorCore: Assist Programming through Aligning Anything](https://huggingface.co/papers/2410.07002).
|
||||
|
||||
Original model card: https://huggingface.co/TechxGenus/CursorCore-Yi-1.5B-SR
|
||||
Code repository: https://github.com/TechxGenus/CursorCore
|
||||
|
||||
Quantization made by Richard Erkhov.
|
||||
|
||||
- [Github](https://github.com/RichardErkhov)
|
||||
- [Discord](https://discord.gg/pvy7H8DZMG)
|
||||
- [Request more models](https://github.com/RichardErkhov/quant_request)
|
||||
|
||||
|
||||
CursorCore-Yi-1.5B-SR - GGUF
|
||||
- Model creator: https://huggingface.co/TechxGenus/
|
||||
- Original model: https://huggingface.co/TechxGenus/CursorCore-Yi-1.5B-SR/
|
||||
|
||||
|
||||
| Name | Quant method | Size |
|
||||
| ---- | ---- | ---- |
|
||||
| [CursorCore-Yi-1.5B-SR.Q2_K.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q2_K.gguf) | Q2_K | 0.59GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q3_K_S.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q3_K_S.gguf) | Q3_K_S | 0.67GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q3_K.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q3_K.gguf) | Q3_K | 0.73GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q3_K_M.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q3_K_M.gguf) | Q3_K_M | 0.73GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q3_K_L.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q3_K_L.gguf) | Q3_K_L | 0.77GB |
|
||||
| [CursorCore-Yi-1.5B-SR.IQ4_XS.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.IQ4_XS.gguf) | IQ4_XS | 0.78GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q4_0.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q4_0.gguf) | Q4_0 | 0.81GB |
|
||||
| [CursorCore-Yi-1.5B-SR.IQ4_NL.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.IQ4_NL.gguf) | IQ4_NL | 0.81GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q4_K_S.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q4_K_S.gguf) | Q4_K_S | 0.84GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q4_K.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q4_K.gguf) | Q4_K | 0.9GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q4_K_M.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q4_K_M.gguf) | Q4_K_M | 0.9GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q4_1.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q4_1.gguf) | Q4_1 | 0.89GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q5_0.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q5_0.gguf) | Q5_0 | 0.96GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q5_K_S.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q5_K_S.gguf) | Q5_K_S | 0.98GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q5_K.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q5_K.gguf) | Q5_K | 1.02GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q5_K_M.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q5_K_M.gguf) | Q5_K_M | 1.02GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q5_1.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q5_1.gguf) | Q5_1 | 1.04GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q6_K.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q6_K.gguf) | Q6_K | 1.19GB |
|
||||
| [CursorCore-Yi-1.5B-SR.Q8_0.gguf](https://huggingface.co/RichardErkhov/TechxGenus_-_CursorCore-Yi-1.5B-SR-gguf/blob/main/CursorCore-Yi-1.5B-SR.Q8_0.gguf) | Q8_0 | 1.46GB |
|
||||
|
||||
|
||||
|
||||
|
||||
Original model description:
|
||||
---
|
||||
tags:
|
||||
- code
|
||||
base_model:
|
||||
- 01-ai/Yi-Coder-1.5B
|
||||
library_name: transformers
|
||||
pipeline_tag: text-generation
|
||||
license: apache-2.0
|
||||
---
|
||||
|
||||
# CursorCore: Assist Programming through Aligning Anything
|
||||
|
||||
<p align="center">
|
||||
<a href="http://arxiv.org/abs/2410.07002">[📄arXiv]</a> |
|
||||
<a href="https://hf.co/papers/2410.07002">[🤗HF Paper]</a> |
|
||||
<a href="https://huggingface.co/collections/TechxGenus/cursorcore-series-6706618c38598468866b60e2">[🤖Models]</a> |
|
||||
<a href="https://github.com/TechxGenus/CursorCore">[🛠️Code]</a> |
|
||||
<a href="https://github.com/TechxGenus/CursorWeb">[Web]</a> |
|
||||
<a href="https://discord.gg/Z5Tev8fV">[Discord]</a>
|
||||
</p>
|
||||
|
||||
<hr>
|
||||
|
||||
- [CursorCore: Assist Programming through Aligning Anything](#cursorcore-assist-programming-through-aligning-anything)
|
||||
- [Introduction](#introduction)
|
||||
- [Models](#models)
|
||||
- [Usage](#usage)
|
||||
- [1) Normal chat](#1-normal-chat)
|
||||
- [2) Assistant-Conversation](#2-assistant-conversation)
|
||||
- [3) Web Demo](#3-web-demo)
|
||||
- [Future Work](#future-work)
|
||||
- [Citation](#citation)
|
||||
- [Contribution](#contribution)
|
||||
|
||||
<hr>
|
||||
|
||||
## Introduction
|
||||
|
||||
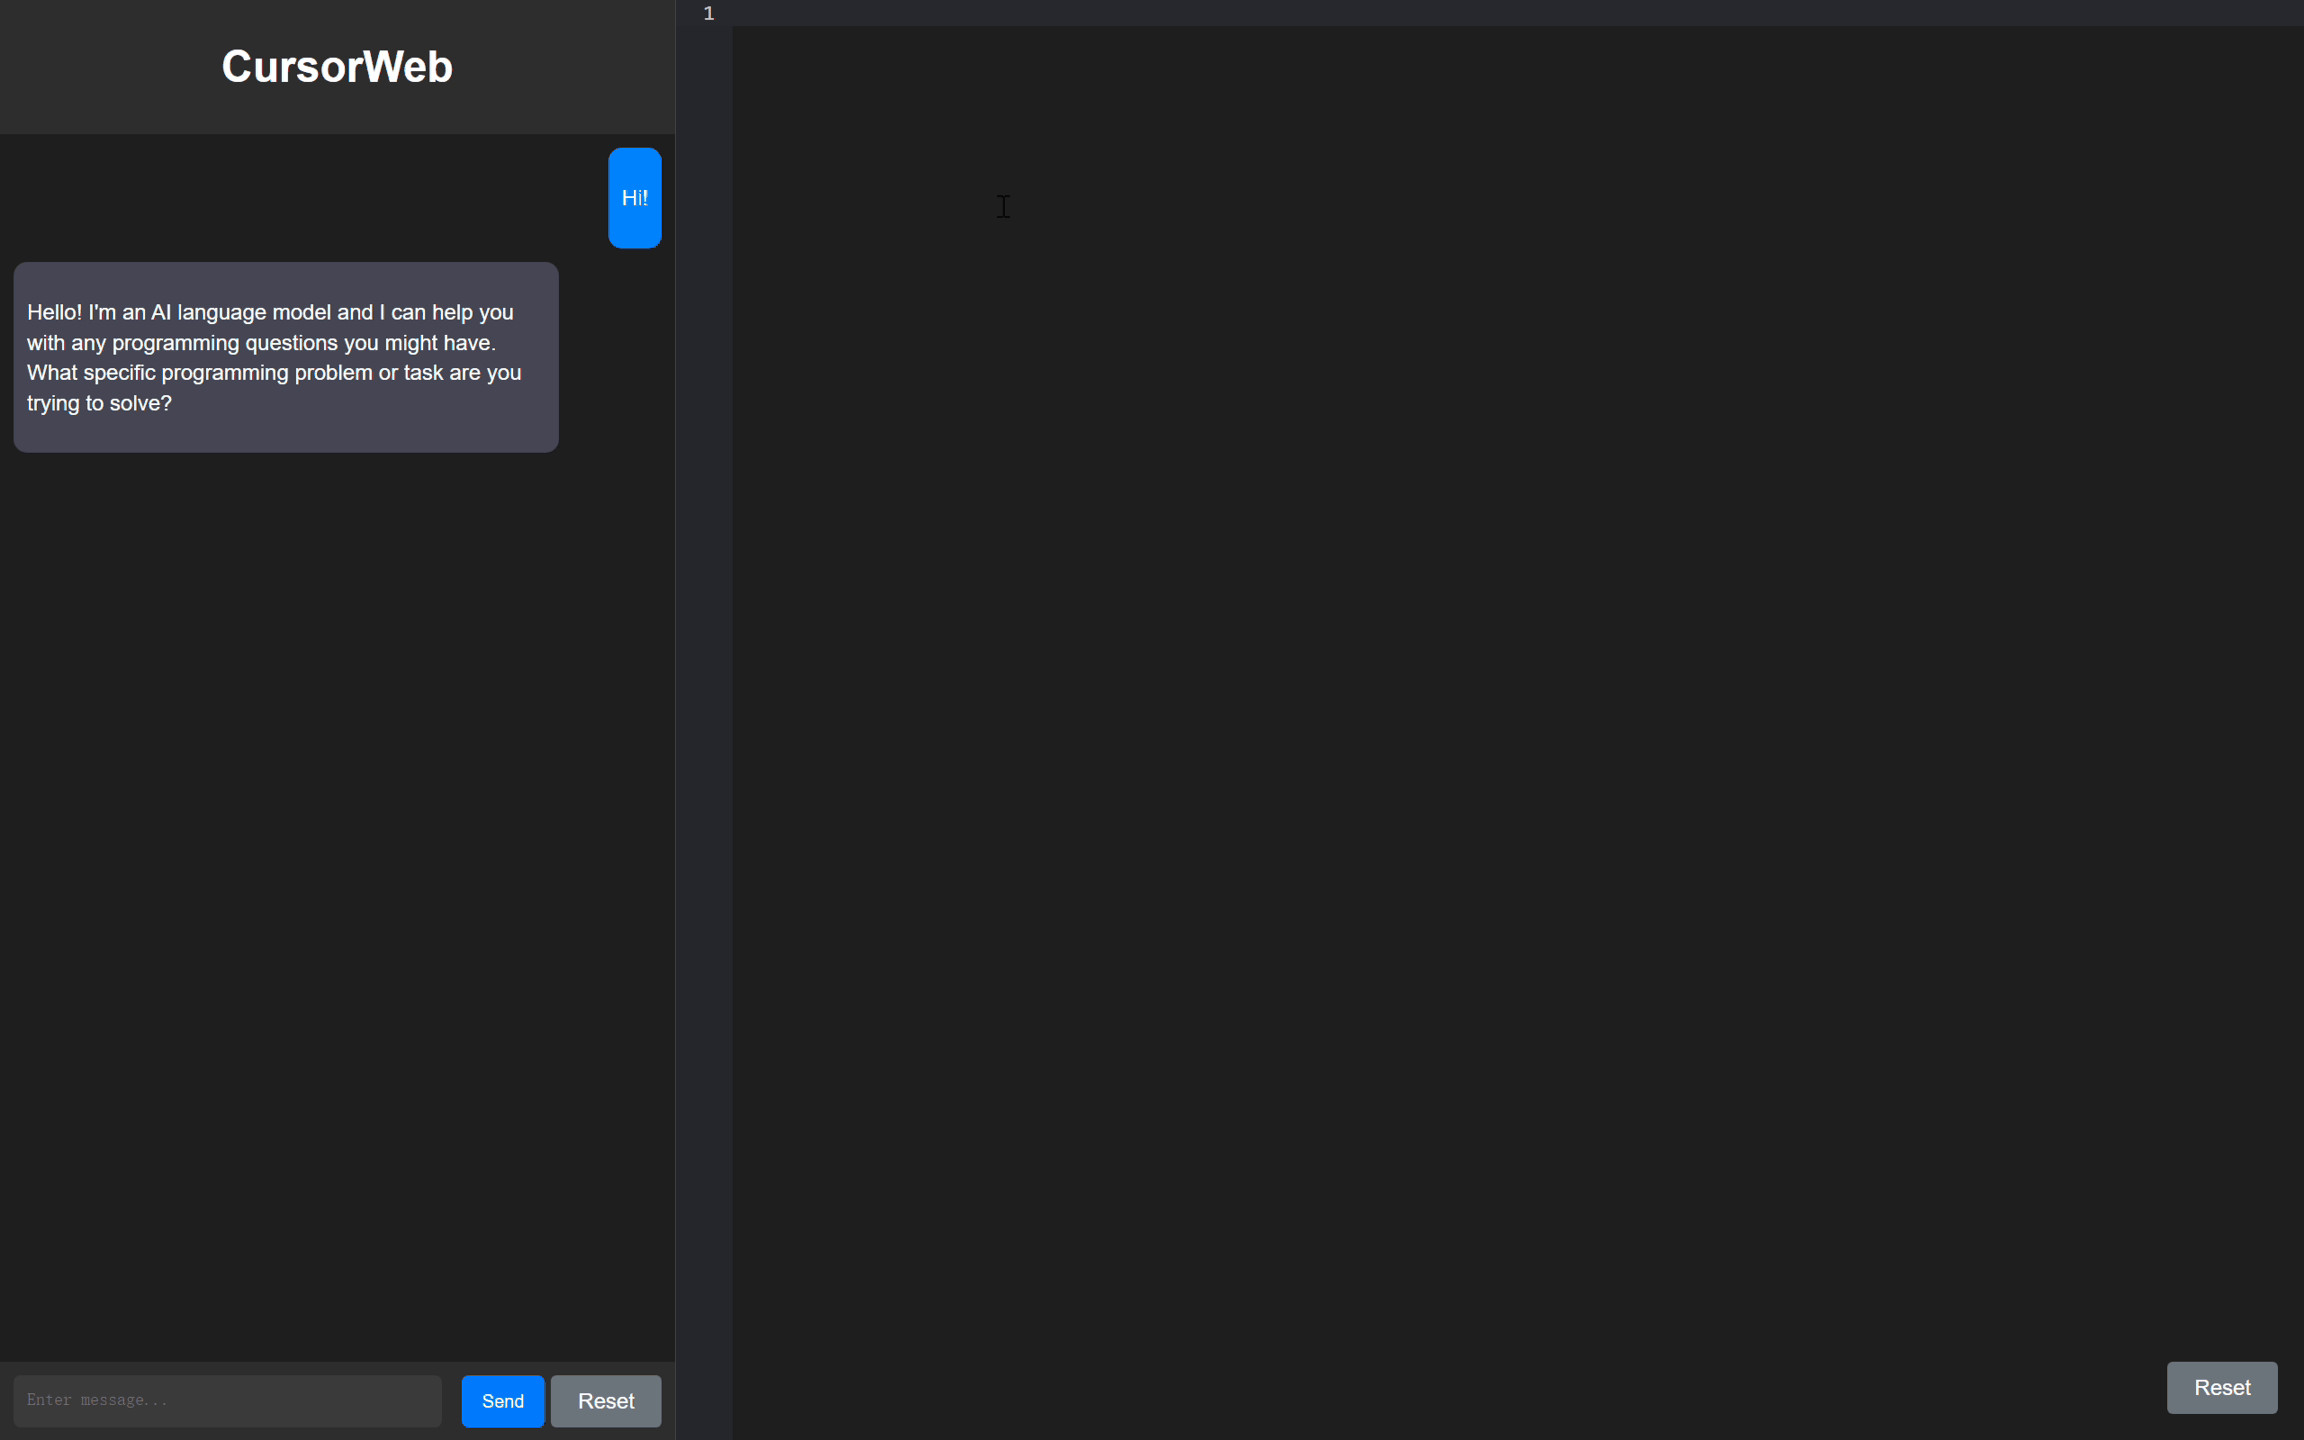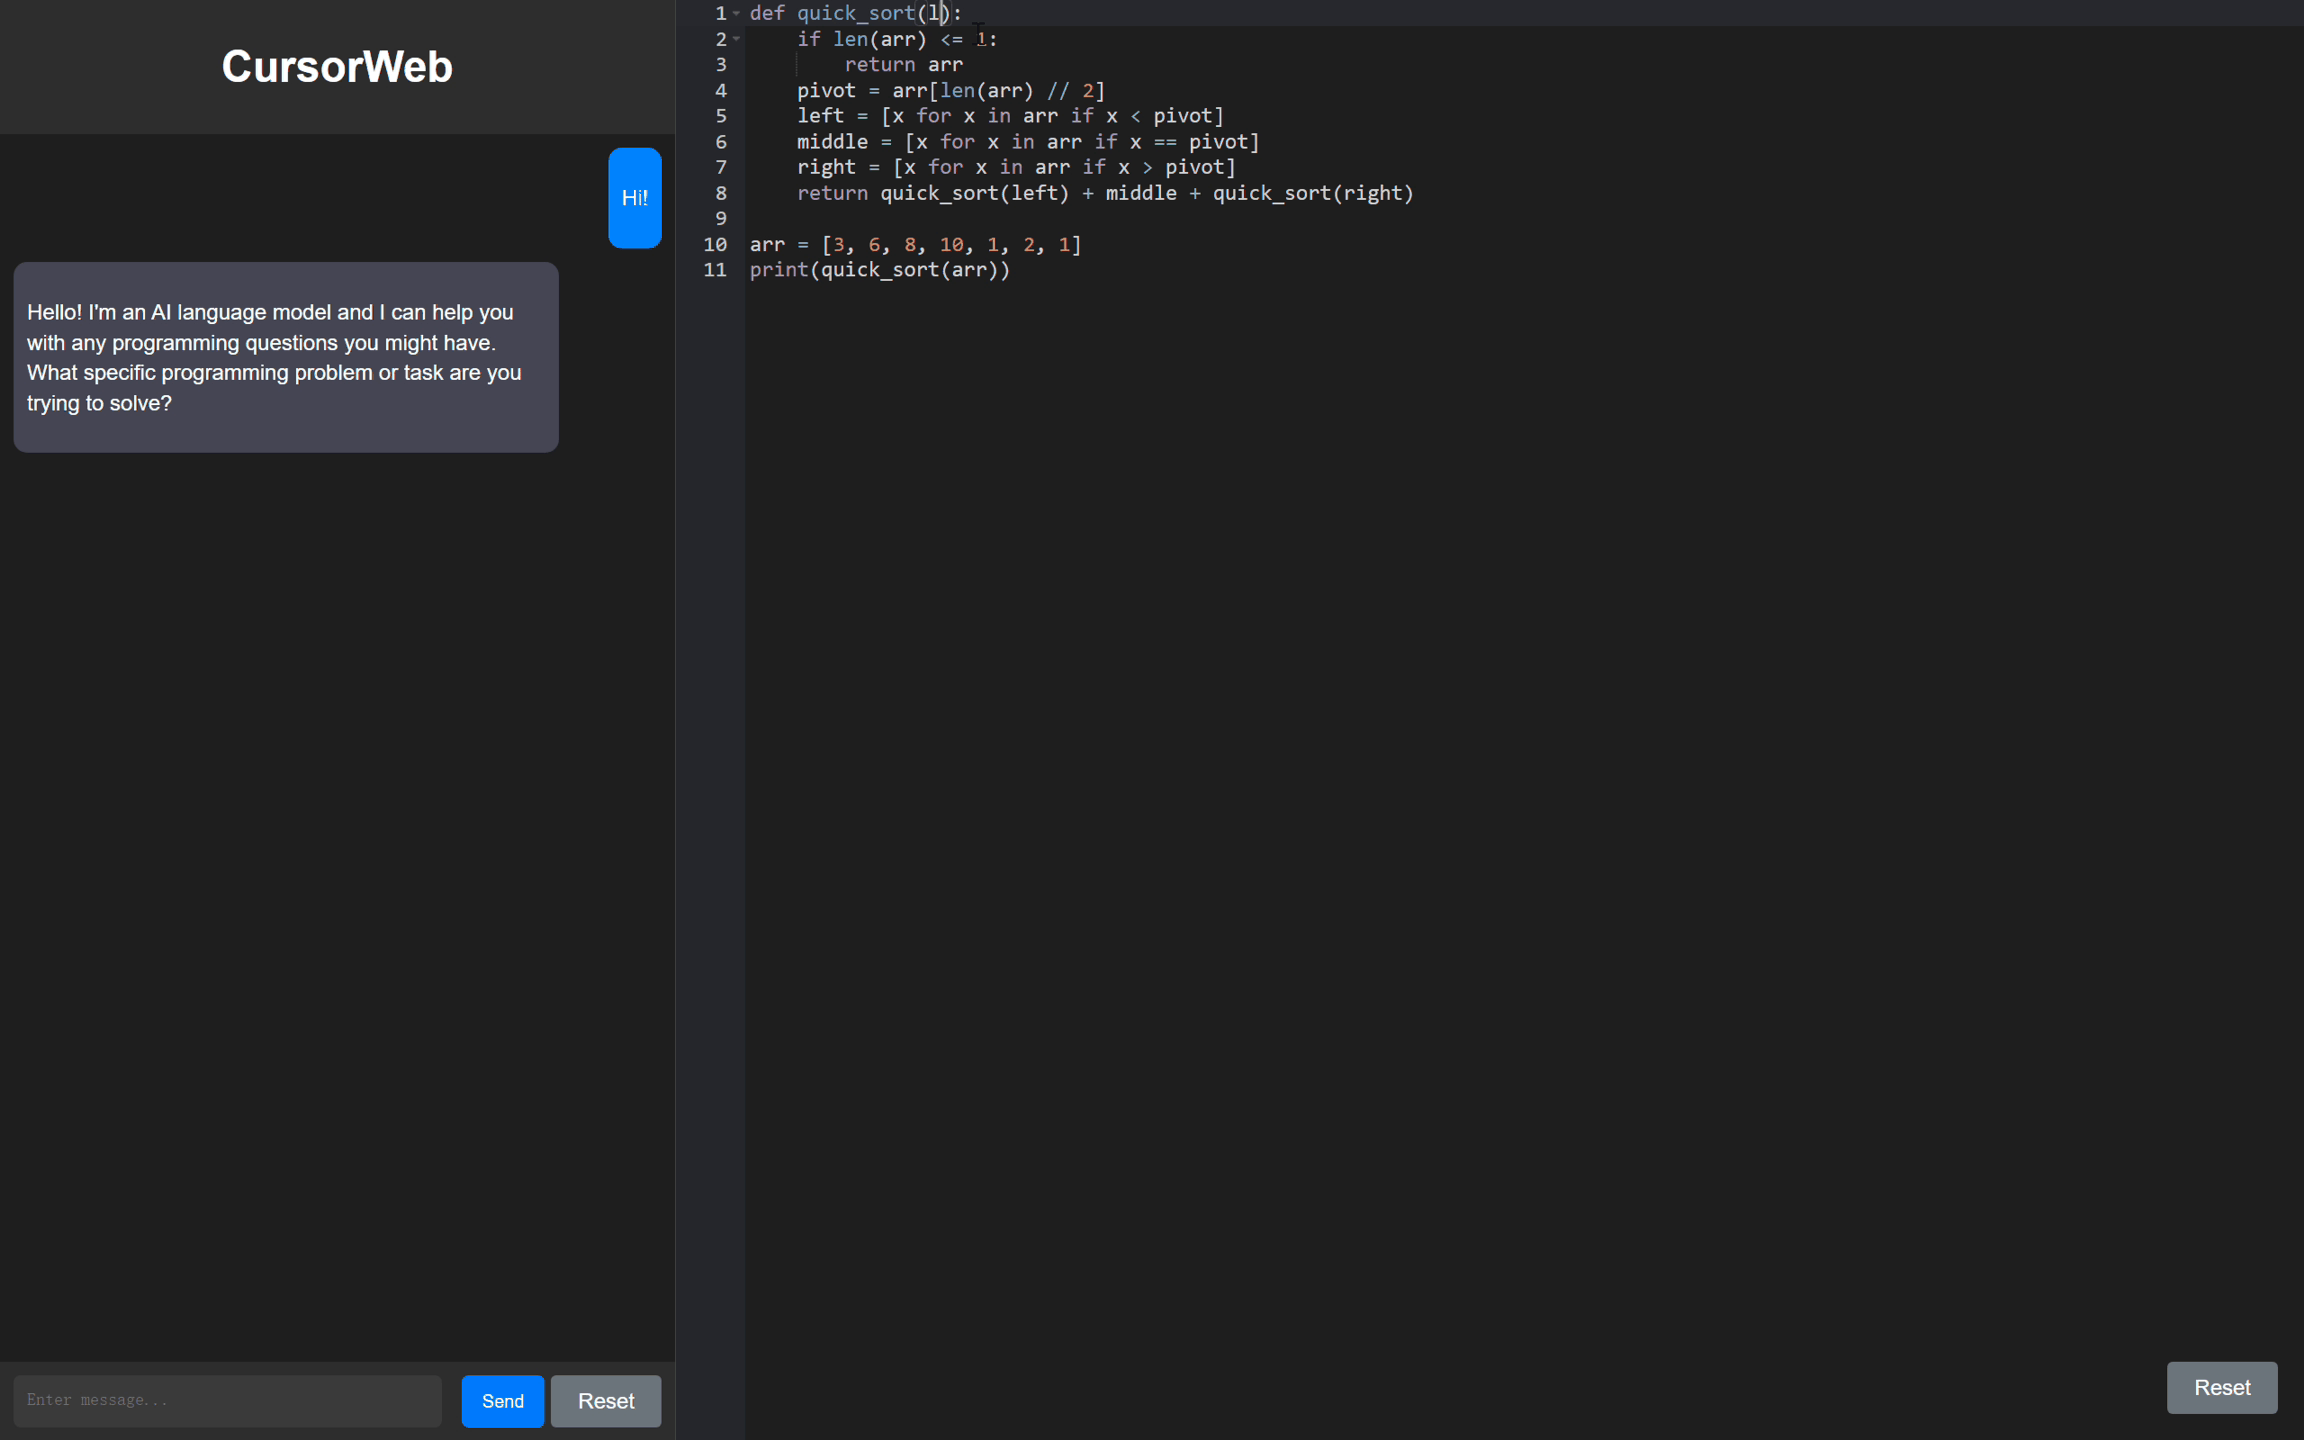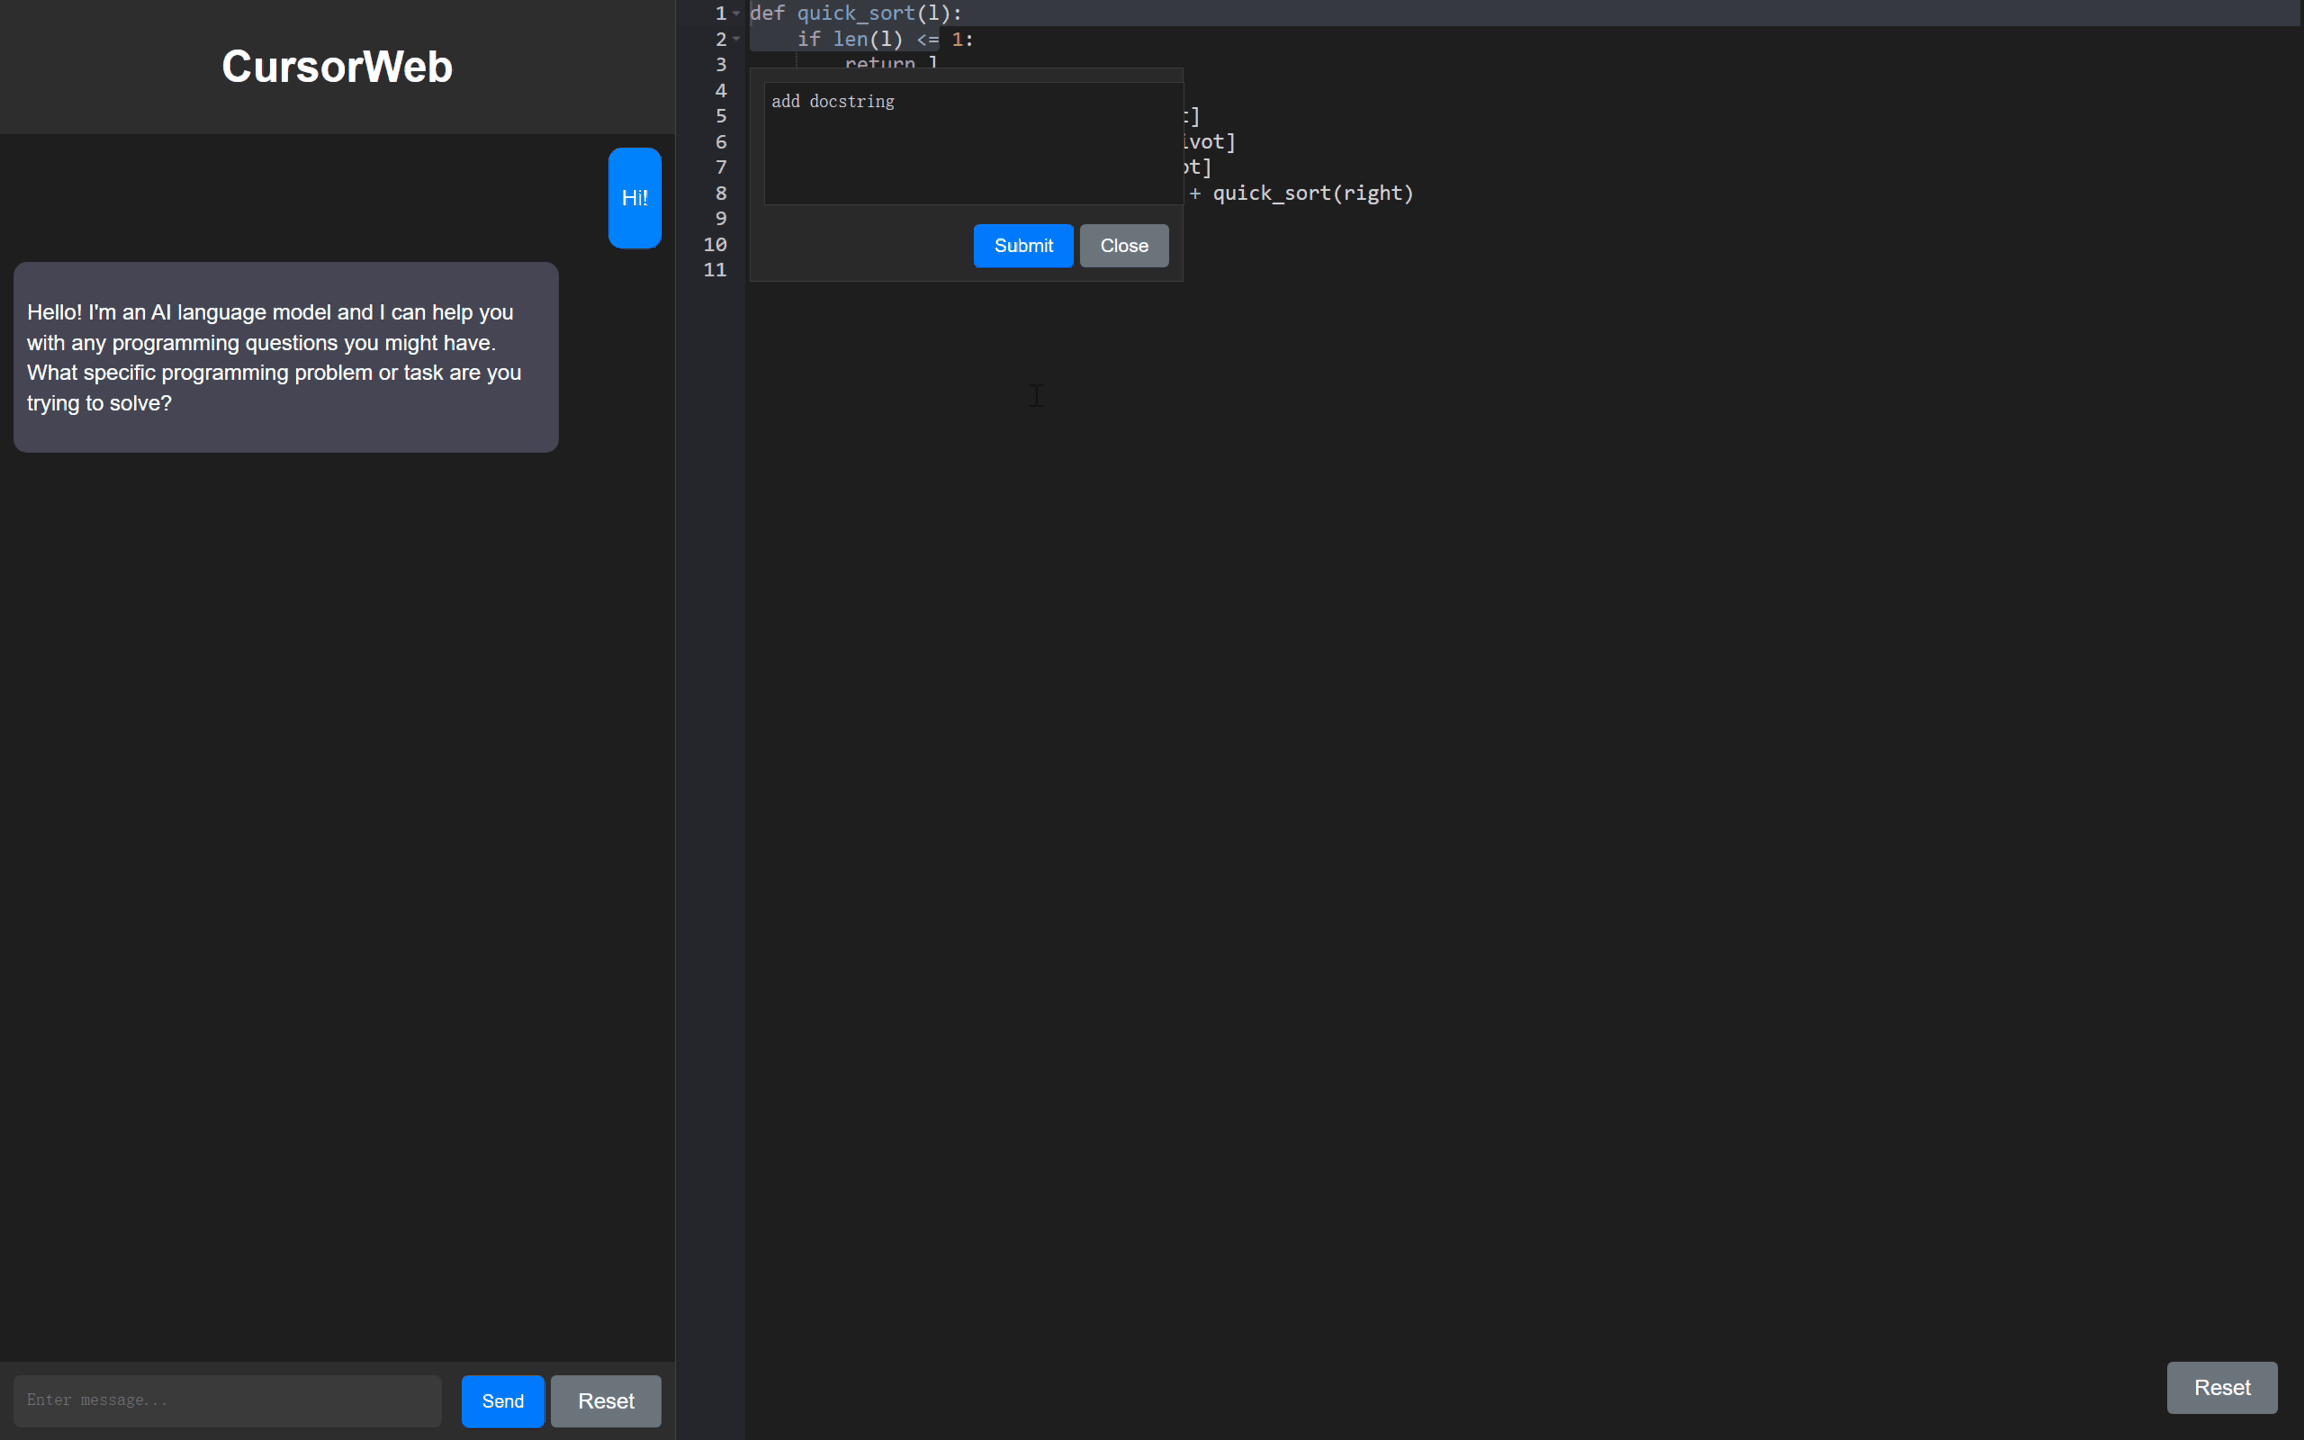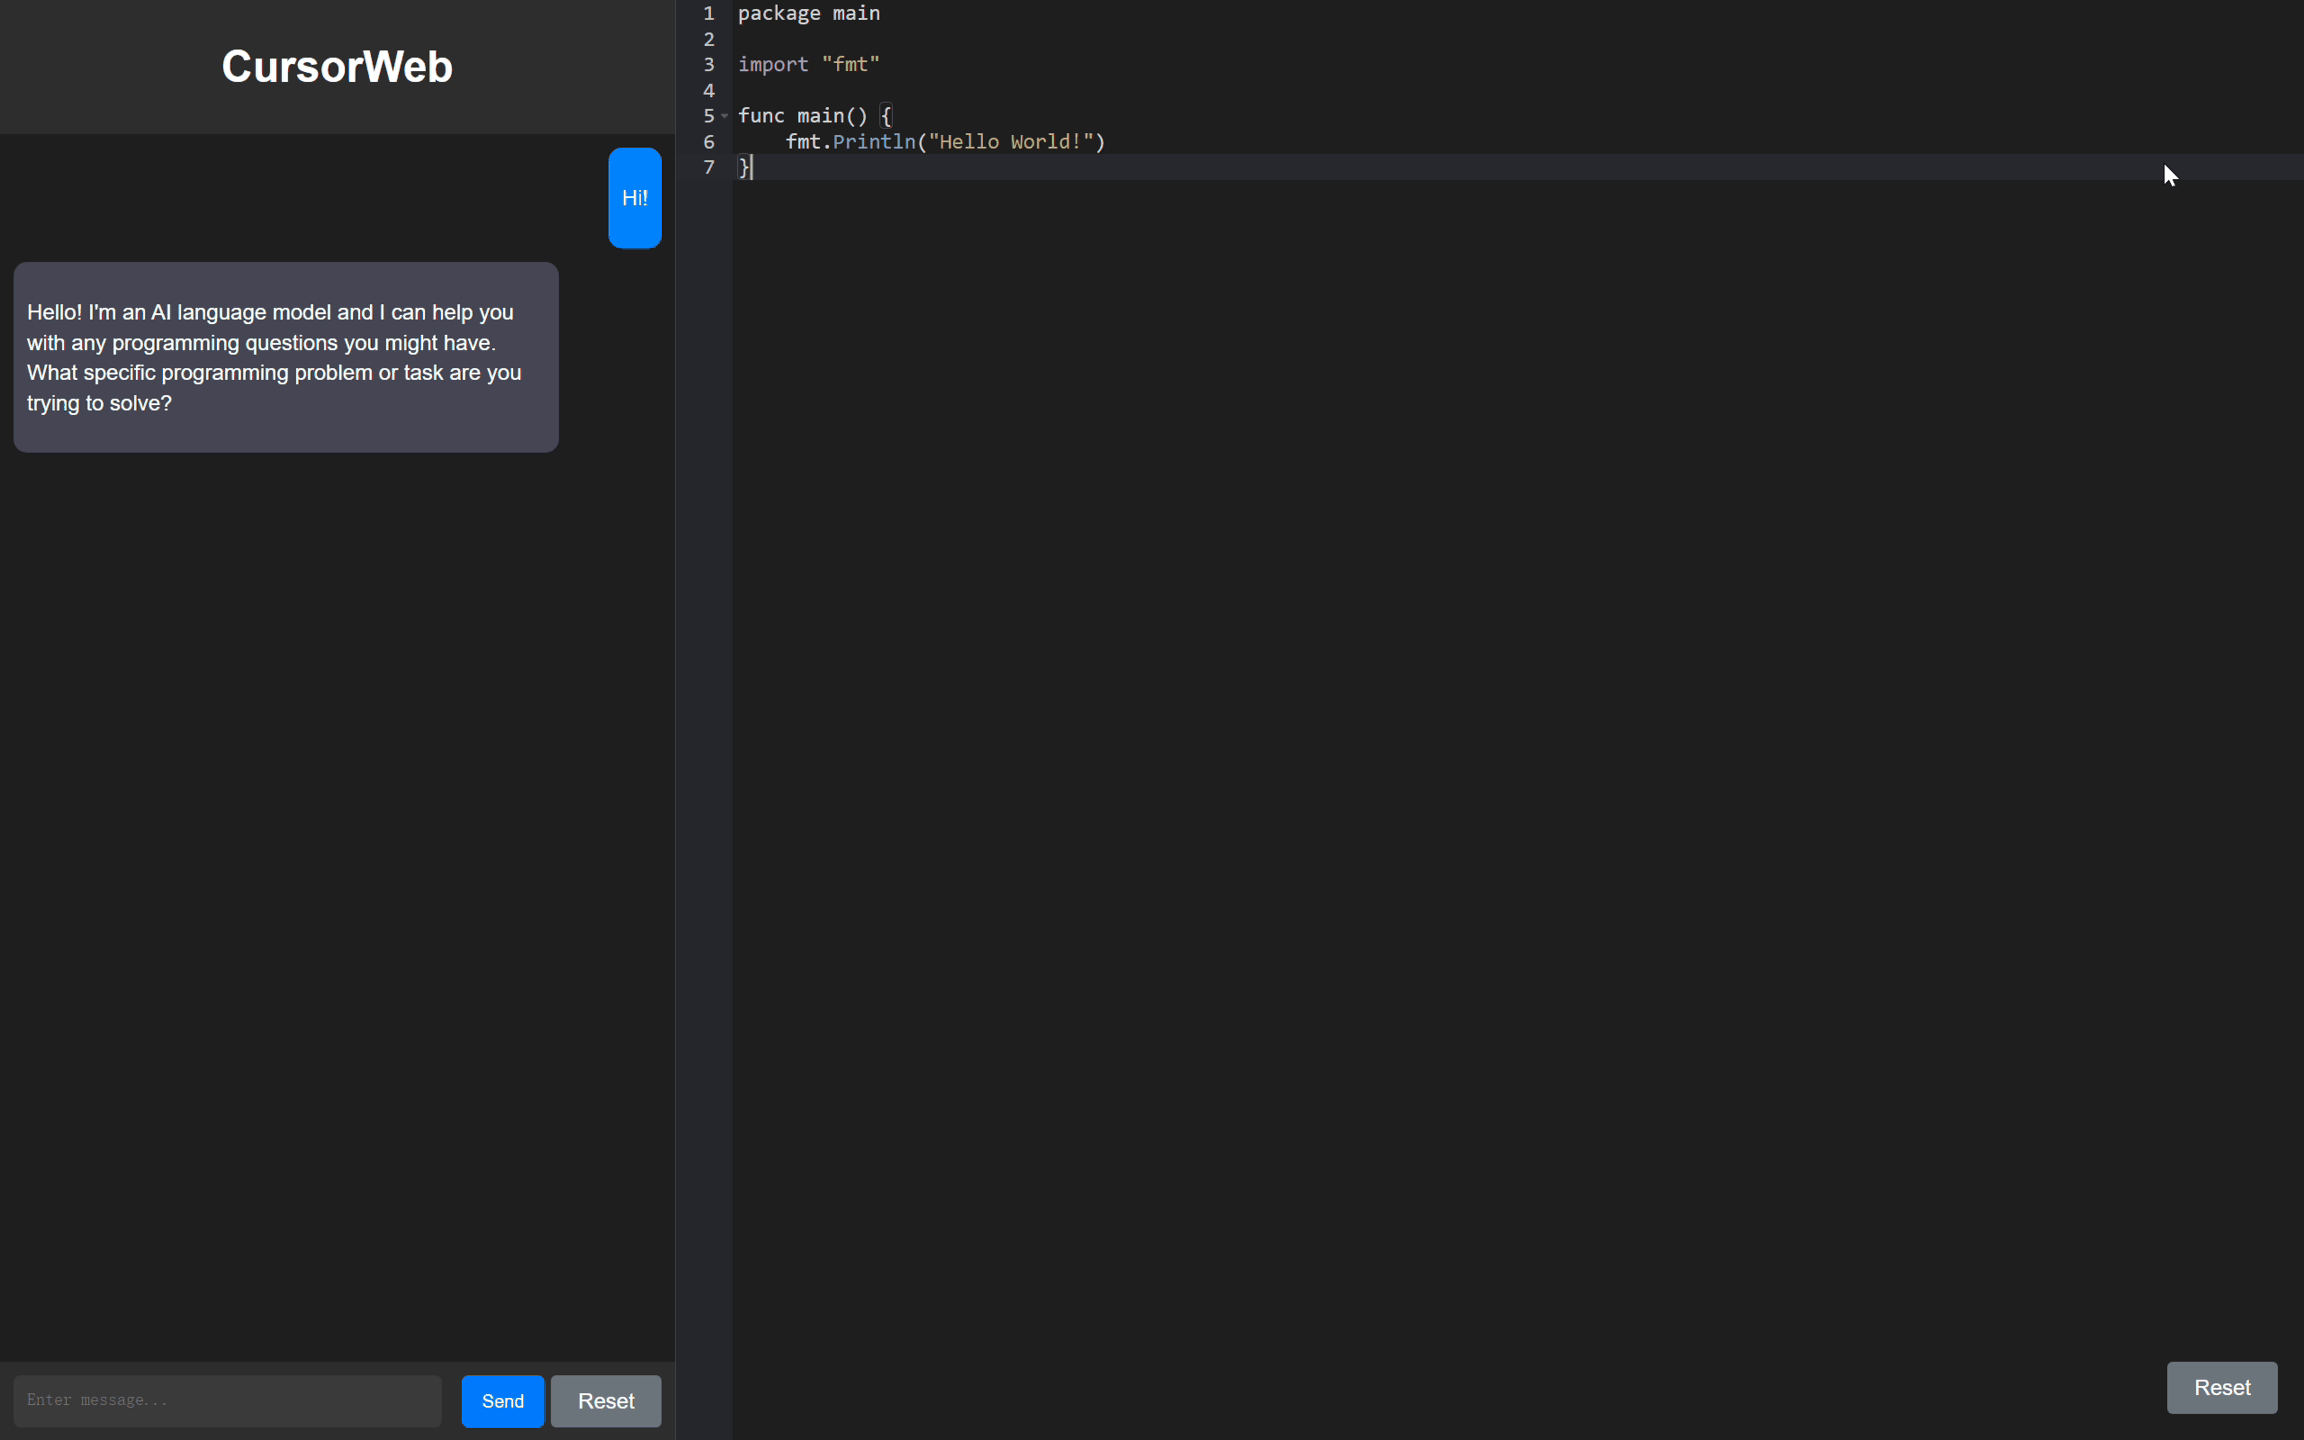
CursorCore is a series of open-source models designed for AI-assisted programming. It aims to support features such as automated editing and inline chat, replicating the core abilities of closed-source AI-assisted programming tools like Cursor. This is achieved by aligning data generated through Programming-Instruct. Please read [our paper](http://arxiv.org/abs/2410.07002) to learn more.
|
||||
|
||||
<p align="center">
|
||||
<img width="100%" alt="conversation" src="https://raw.githubusercontent.com/TechxGenus/CursorCore/main/pictures/conversation.png">
|
||||
</p>
|
||||
|
||||
|
||||
|
||||
## Models
|
||||
|
||||
Our models have been open-sourced on Hugging Face. You can access our models here: [CursorCore-Series](https://huggingface.co/collections/TechxGenus/cursorcore-series-6706618c38598468866b60e2"). We also provide pre-quantized weights for GPTQ and AWQ here: [CursorCore-Quantization](https://huggingface.co/collections/TechxGenus/cursorcore-quantization-67066431f29f252494ee8cf3)
|
||||
|
||||
## Usage
|
||||
|
||||
Here are some examples of how to use our model:
|
||||
|
||||
### 1) Normal chat
|
||||
|
||||
Script:
|
||||
|
||||
````python
|
||||
import torch
|
||||
from transformers import AutoTokenizer, AutoModelForCausalLM
|
||||
|
||||
tokenizer = AutoTokenizer.from_pretrained("TechxGenus/CursorCore-Yi-9B")
|
||||
model = AutoModelForCausalLM.from_pretrained(
|
||||
"TechxGenus/CursorCore-Yi-9B",
|
||||
torch_dtype=torch.bfloat16,
|
||||
device_map="auto"
|
||||
)
|
||||
|
||||
messages = [
|
||||
{"role": "user", "content": "Hi!"},
|
||||
]
|
||||
prompt = tokenizer.apply_chat_template(
|
||||
messages,
|
||||
tokenize=False,
|
||||
add_generation_prompt=True
|
||||
)
|
||||
|
||||
inputs = tokenizer.encode(prompt, return_tensors="pt")
|
||||
outputs = model.generate(input_ids=inputs.to(model.device), max_new_tokens=512)
|
||||
print(tokenizer.decode(outputs[0]))
|
||||
````
|
||||
|
||||
Output:
|
||||
|
||||
````txt
|
||||
<|im_start|>system
|
||||
You are a helpful programming assistant.<|im_end|>
|
||||
<|im_start|>user
|
||||
Hi!<|im_end|>
|
||||
<|im_start|>assistant
|
||||
Hello! I'm an AI language model and I can help you with any programming questions you might have. What specific problem or task are you trying to solve?<|im_end|>
|
||||
````
|
||||
|
||||
### 2) Assistant-Conversation
|
||||
|
||||
In our work, we introduce a new framework of AI-assisted programming task. It is designed for aligning anything during programming process, used for the implementation of features like Tab and Inline Chat.
|
||||
|
||||
Script 1:
|
||||
|
||||
````python
|
||||
import torch
|
||||
from transformers import AutoTokenizer, AutoModelForCausalLM
|
||||
from eval.utils import prepare_input_for_wf
|
||||
|
||||
tokenizer = AutoTokenizer.from_pretrained("TechxGenus/CursorCore-Yi-9B")
|
||||
model = AutoModelForCausalLM.from_pretrained(
|
||||
"TechxGenus/CursorCore-Yi-9B",
|
||||
torch_dtype=torch.bfloat16,
|
||||
device_map="auto"
|
||||
)
|
||||
sample = {
|
||||
"history": [
|
||||
{
|
||||
"type": "code",
|
||||
"lang": "python",
|
||||
"code": """def quick_sort(arr):\n if len(arr) <= 1:\n return arr\n pivot = arr[len(arr) // 2]\n left = [x for x in arr if x < pivot]\n middle = [x for x in arr if x == pivot]\n right = [x for x in arr if x > pivot]\n return quick_sort(left) + middle + quick_sort(right)"""
|
||||
}
|
||||
],
|
||||
"current": {
|
||||
"type": "code",
|
||||
"lang": "python",
|
||||
"code": """def quick_sort(array):\n if len(arr) <= 1:\n return arr\n pivot = arr[len(arr) // 2]\n left = [x for x in arr if x < pivot]\n middle = [x for x in arr if x == pivot]\n right = [x for x in arr if x > pivot]\n return quick_sort(left) + middle + quick_sort(right)"""
|
||||
},
|
||||
"user": ""
|
||||
}
|
||||
|
||||
prompt = tokenizer.apply_chat_template(
|
||||
prepare_input_for_wf(sample),
|
||||
tokenize=False,
|
||||
chat_template="assistant-conversation",
|
||||
add_generation_prompt=True
|
||||
)
|
||||
|
||||
inputs = tokenizer.encode(prompt, return_tensors="pt")
|
||||
outputs = model.generate(input_ids=inputs.to(model.device), max_new_tokens=512, do_sample=False)
|
||||
print(tokenizer.decode(outputs[0]))
|
||||
````
|
||||
|
||||
Output 1:
|
||||
|
||||
````txt
|
||||
<|im_start|>system
|
||||
You are a helpful programming assistant.<|im_end|>
|
||||
<|im_start|>history
|
||||
```python
|
||||
def quick_sort(arr):
|
||||
if len(arr) <= 1:
|
||||
return arr
|
||||
pivot = arr[len(arr) // 2]
|
||||
left = [x for x in arr if x < pivot]
|
||||
middle = [x for x in arr if x == pivot]
|
||||
right = [x for x in arr if x > pivot]
|
||||
return quick_sort(left) + middle + quick_sort(right)
|
||||
```<|im_end|>
|
||||
<|im_start|>current
|
||||
```python
|
||||
def quick_sort(array):
|
||||
if len(arr) <= 1:
|
||||
return arr
|
||||
pivot = arr[len(arr) // 2]
|
||||
left = [x for x in arr if x < pivot]
|
||||
middle = [x for x in arr if x == pivot]
|
||||
right = [x for x in arr if x > pivot]
|
||||
return quick_sort(left) + middle + quick_sort(right)
|
||||
```<|im_end|>
|
||||
<|im_start|>assistant
|
||||
<|next_start|>```python
|
||||
def quick_sort(array):
|
||||
if len(array) <= 1:
|
||||
return array
|
||||
pivot = array[len(array) // 2]
|
||||
left = [x for x in array if x < pivot]
|
||||
middle = [x for x in array if x == pivot]
|
||||
right = [x for x in array if x > pivot]
|
||||
return quick_sort(left) + middle + quick_sort(right)
|
||||
```<|next_end|>
|
||||
The user has provided a revised code change that corrects the parameter name from `arr` to `array` in the `quick_sort` function. This change ensures consistency in the function definition and avoids potential confusion or errors.
|
||||
|
||||
To implement this, we will:
|
||||
1. Update the parameter name in the function definition from `arr` to `array`.
|
||||
2. Ensure that all references to `arr` within the function are updated to `array`.
|
||||
|
||||
This will make the function definition and internal references consistent, improving code readability and maintainability.<|im_end|>
|
||||
````
|
||||
|
||||
Script 2:
|
||||
|
||||
````python
|
||||
import torch
|
||||
from transformers import AutoTokenizer, AutoModelForCausalLM
|
||||
from eval.utils import prepare_input_for_wf
|
||||
|
||||
tokenizer = AutoTokenizer.from_pretrained("TechxGenus/CursorCore-Yi-9B")
|
||||
model = AutoModelForCausalLM.from_pretrained(
|
||||
"TechxGenus/CursorCore-Yi-9B",
|
||||
torch_dtype=torch.bfloat16,
|
||||
device_map="auto"
|
||||
)
|
||||
sample = {
|
||||
"history": [],
|
||||
"current": {
|
||||
"type": "code",
|
||||
"lang": "python",
|
||||
"code": """def quick_sort(array):\n if len(arr) <= 1:\n return arr\n pivot = arr[len(arr) // 2]\n left = [x for x in arr if x < pivot]\n middle = [x for x in arr if x == pivot]\n right = [x for x in arr if x > pivot]\n return quick_sort(left) + middle + quick_sort(right)"""
|
||||
},
|
||||
"user": "Add Docstring."
|
||||
}
|
||||
|
||||
prompt = tokenizer.apply_chat_template(
|
||||
prepare_input_for_wf(sample),
|
||||
tokenize=False,
|
||||
chat_template="assistant-conversation",
|
||||
add_generation_prompt=True
|
||||
)
|
||||
|
||||
inputs = tokenizer.encode(prompt, return_tensors="pt")
|
||||
outputs = model.generate(input_ids=inputs.to(model.device), max_new_tokens=512, do_sample=False)
|
||||
print(tokenizer.decode(outputs[0]))
|
||||
````
|
||||
|
||||
Output 2:
|
||||
|
||||
````txt
|
||||
<|im_start|>system
|
||||
You are a helpful programming assistant.<|im_end|>
|
||||
<|im_start|>current
|
||||
```python
|
||||
def quick_sort(array):
|
||||
if len(arr) <= 1:
|
||||
return arr
|
||||
pivot = arr[len(arr) // 2]
|
||||
left = [x for x in arr if x < pivot]
|
||||
middle = [x for x in arr if x == pivot]
|
||||
right = [x for x in arr if x > pivot]
|
||||
return quick_sort(left) + middle + quick_sort(right)
|
||||
```<|im_end|>
|
||||
<|im_start|>user
|
||||
Add Docstring.<|im_end|>
|
||||
<|im_start|>assistant
|
||||
<|next_start|>```python
|
||||
def quick_sort(array):
|
||||
"""
|
||||
This is an implementation of the quick sort algorithm.
|
||||
"""
|
||||
if len(arr) <= 1:
|
||||
return arr
|
||||
pivot = arr[len(arr) // 2]
|
||||
left = [x for x in arr if x < pivot]
|
||||
middle = [x for x in arr if x == pivot]
|
||||
right = [x for x in arr if x > pivot]
|
||||
return quick_sort(left) + middle + quick_sort(right)
|
||||
```<|next_end|><|im_end|>
|
||||
````
|
||||
|
||||
For models in Locate-and-Change (LC) and Search-and-Replace (SR) formats, the output examples are as follows:
|
||||
|
||||
Script for LC:
|
||||
|
||||
````python
|
||||
import torch
|
||||
from transformers import AutoTokenizer, AutoModelForCausalLM
|
||||
from eval.utils import prepare_input_for_lc
|
||||
|
||||
tokenizer = AutoTokenizer.from_pretrained("TechxGenus/CursorCore-Yi-1.5B-LC")
|
||||
model = AutoModelForCausalLM.from_pretrained(
|
||||
"TechxGenus/CursorCore-Yi-1.5B-LC",
|
||||
torch_dtype=torch.bfloat16,
|
||||
device_map="auto"
|
||||
)
|
||||
sample = {
|
||||
"history": [],
|
||||
"current": {
|
||||
"type": "code",
|
||||
"lang": "python",
|
||||
"code": """def quick_sort(array):\n if len(arr) <= 1:\n return arr\n pivot = arr[len(arr) // 2]\n left = [x for x in arr if x < pivot]\n middle = [x for x in arr if x == pivot]\n right = [x for x in arr if x > pivot]\n return quick_sort(left) + middle + quick_sort(right)"""
|
||||
},
|
||||
"user": "Add Docstring."
|
||||
}
|
||||
|
||||
prompt = tokenizer.apply_chat_template(
|
||||
prepare_input_for_lc(sample),
|
||||
tokenize=False,
|
||||
chat_template="assistant-conversation",
|
||||
add_generation_prompt=True
|
||||
)
|
||||
|
||||
inputs = tokenizer.encode(prompt, return_tensors="pt")
|
||||
outputs = model.generate(input_ids=inputs.to(model.device), max_new_tokens=512, do_sample=False)
|
||||
print(tokenizer.decode(outputs[0]))
|
||||
````
|
||||
|
||||
Output for LC:
|
||||
|
||||
````txt
|
||||
<|im_start|>system
|
||||
You are a helpful programming assistant.<|im_end|>
|
||||
<|im_start|>current
|
||||
```python
|
||||
1 def quick_sort(array):
|
||||
2 if len(arr) <= 1:
|
||||
3 return arr
|
||||
4 pivot = arr[len(arr) // 2]
|
||||
5 left = [x for x in arr if x < pivot]
|
||||
6 middle = [x for x in arr if x == pivot]
|
||||
7 right = [x for x in arr if x > pivot]
|
||||
8 return quick_sort(left) + middle + quick_sort(right)
|
||||
```<|im_end|>
|
||||
<|im_start|>user
|
||||
Add Docstring.<|im_end|>
|
||||
<|im_start|>assistant
|
||||
<|next_start|>1,1
|
||||
```
|
||||
'''This function will sort an array using quick sort algorithm'''
|
||||
```<|next_end|>
|
||||
To enhance the readability and maintainability of the code, we should add a docstring to the `quick_sort` function. A docstring provides a clear description of what the function does, which is particularly useful for other developers who might use or modify this code in the future.
|
||||
|
||||
The docstring will be added immediately after the function definition, explaining that the function uses the quick sort algorithm to sort an array. This will make the code more self-explanatory and easier to understand.
|
||||
|
||||
Here's the plan:
|
||||
1. Add a docstring at the beginning of the `quick_sort` function.
|
||||
2. Ensure the docstring is clear and concise, describing the purpose of the function.
|
||||
|
||||
This modification will improve the code's documentation without altering its functionality.<|im_end|>
|
||||
````
|
||||
|
||||
Script for SR:
|
||||
|
||||
````python
|
||||
import torch
|
||||
from transformers import AutoTokenizer, AutoModelForCausalLM
|
||||
from eval.utils import prepare_input_for_sr
|
||||
|
||||
tokenizer = AutoTokenizer.from_pretrained("TechxGenus/CursorCore-Yi-1.5B-SR")
|
||||
model = AutoModelForCausalLM.from_pretrained(
|
||||
"TechxGenus/CursorCore-Yi-1.5B-SR",
|
||||
torch_dtype=torch.bfloat16,
|
||||
device_map="auto"
|
||||
)
|
||||
sample = {
|
||||
"history": [],
|
||||
"current": {
|
||||
"type": "code",
|
||||
"lang": "python",
|
||||
"code": """def quick_sort(array):\n if len(arr) <= 1:\n return arr\n pivot = arr[len(arr) // 2]\n left = [x for x in arr if x < pivot]\n middle = [x for x in arr if x == pivot]\n right = [x for x in arr if x > pivot]\n return quick_sort(left) + middle + quick_sort(right)"""
|
||||
},
|
||||
"user": "Add Docstring."
|
||||
}
|
||||
|
||||
prompt = tokenizer.apply_chat_template(
|
||||
prepare_input_for_sr(sample),
|
||||
tokenize=False,
|
||||
chat_template="assistant-conversation",
|
||||
add_generation_prompt=True
|
||||
)
|
||||
|
||||
inputs = tokenizer.encode(prompt, return_tensors="pt")
|
||||
outputs = model.generate(input_ids=inputs.to(model.device), max_new_tokens=512, do_sample=False)
|
||||
print(tokenizer.decode(outputs[0]))
|
||||
````
|
||||
|
||||
Output for SR:
|
||||
|
||||
````txt
|
||||
<|im_start|>system
|
||||
You are a helpful programming assistant.<|im_end|>
|
||||
<|im_start|>current
|
||||
```python
|
||||
def quick_sort(array):
|
||||
if len(arr) <= 1:
|
||||
return arr
|
||||
pivot = arr[len(arr) // 2]
|
||||
left = [x for x in arr if x < pivot]
|
||||
middle = [x for x in arr if x == pivot]
|
||||
right = [x for x in arr if x > pivot]
|
||||
return quick_sort(left) + middle + quick_sort(right)
|
||||
```<|im_end|>
|
||||
<|im_start|>user
|
||||
Add Docstring.<|im_end|>
|
||||
<|im_start|>assistant
|
||||
<|next_start|>```python
|
||||
def quick_sort(array):
|
||||
<|search_and_replace|>
|
||||
def quick_sort(array):
|
||||
"""
|
||||
This function implements quick sort algorithm
|
||||
"""
|
||||
```<|next_end|><|im_end|>
|
||||
````
|
||||
|
||||
### 3) Web Demo
|
||||
|
||||
We create a web demo for CursorCore. Please visit [CursorWeb](https://github.com/TechxGenus/CursorWeb) for more details.
|
||||
|
||||
## Future Work
|
||||
|
||||
CursorCore is still in a very early stage, and lots of work is needed to achieve a better user experience. For example:
|
||||
|
||||
- Repository-level editing support
|
||||
- Better and faster editing formats
|
||||
- Better user interface and presentation
|
||||
- ...
|
||||
|
||||
## Citation
|
||||
|
||||
```bibtex
|
||||
@article{jiang2024cursorcore,
|
||||
title = {CursorCore: Assist Programming through Aligning Anything},
|
||||
author = {Hao Jiang and Qi Liu and Rui Li and Shengyu Ye and Shijin Wang},
|
||||
year = {2024},
|
||||
journal = {arXiv preprint arXiv: 2410.07002}
|
||||
}
|
||||
```
|
||||
|
||||
## Contribution
|
||||
|
||||
Contributions are welcome! If you find any bugs or have suggestions for improvements, please open an issue or submit a pull request.
|
||||
|
||||
|
||||
Reference in New Issue
Block a user