初始化项目,由ModelHub XC社区提供模型
Model: sometimesanotion/Lamarck-14B-v0.7
Source: Original Platform
This commit is contained in:
 ModelHub XC
35
.gitattributes
vendored
Normal file
35
.gitattributes
vendored
Normal file
@@ -0,0 +1,35 @@
|
|||||||
|
*.7z filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.arrow filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.bin filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.bz2 filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.ckpt filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.ftz filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.gz filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.h5 filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.joblib filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.lfs.* filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.mlmodel filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.model filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.msgpack filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.npy filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.npz filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.onnx filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.ot filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.parquet filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.pb filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.pickle filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.pkl filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.pt filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.pth filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.rar filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.safetensors filter=lfs diff=lfs merge=lfs -text
|
||||||
|
saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.tar.* filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.tar filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.tflite filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.tgz filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.wasm filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.xz filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.zip filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.zst filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
||||||

BIN
Lamarck.webp
Normal file
BIN
Lamarck.webp
Normal file

Binary file not shown.
|
After Width: | Height: | Size: 86 KiB |
BIN
LamarckShades.webp
Normal file
BIN
LamarckShades.webp
Normal file

Binary file not shown.
|
After Width: | Height: | Size: 86 KiB |
39
README.md
Normal file
39
README.md
Normal file
@@ -0,0 +1,39 @@
|
|||||||
|
---
|
||||||
|
base_model:
|
||||||
|
- sometimesanotion/Lamarck-14B-v0.6
|
||||||
|
- deepseek-ai/DeepSeek-R1-Distill-Qwen-14B
|
||||||
|
- sometimesanotion/Lamarck-14B-v0.3
|
||||||
|
- sometimesanotion/Qwenvergence-14B-v9
|
||||||
|
- sometimesanotion/Qwenvergence-14B-v3-Prose
|
||||||
|
- arcee-ai/Virtuoso-Small
|
||||||
|
library_name: transformers
|
||||||
|
tags:
|
||||||
|
- mergekit
|
||||||
|
- merge
|
||||||
|
license: apache-2.0
|
||||||
|
language:
|
||||||
|
- en
|
||||||
|
pipeline_tag: text-generation
|
||||||
|
metrics:
|
||||||
|
- accuracy
|
||||||
|
---
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
> [!TIP] With no benchmark regressions, mostly gains over the previous release, this version of Lamarck has [broken the 41.0 average](https://shorturl.at/jUqEk) maximum for 14B parameter models. Those providing feedback, thank you!
|
||||||
|
|
||||||
|
Lamarck 14B v0.7: A generalist merge with emphasis on multi-step reasoning, prose, and multi-language ability. The 14B parameter model class has a lot of strong performers, and Lamarck strives to be well-rounded and solid: 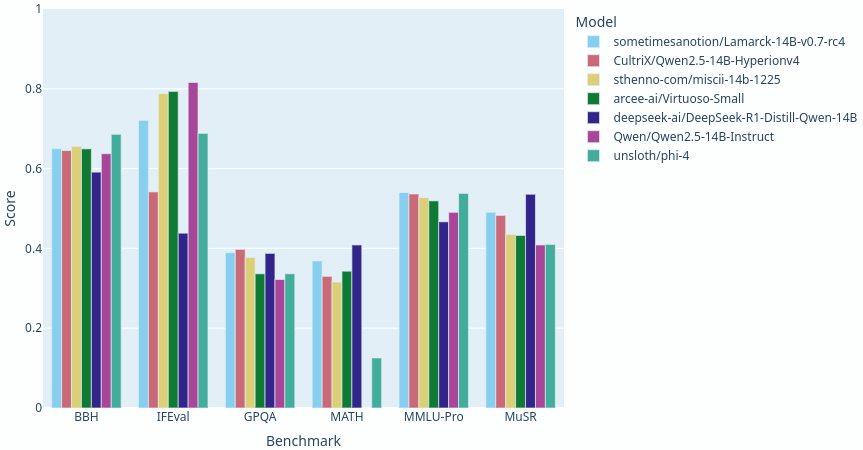
|
||||||
|
|
||||||
|
Lamarck is produced by a custom toolchain to automate a process of LoRAs and layer-targeting merges:
|
||||||
|
|
||||||
|
- **Extracted LoRA adapters from special-purpose merges**
|
||||||
|
- **Custom base models and model_stocks, with LoRAs from from [huihui-ai/Qwen2.5-14B-Instruct-abliterated-v2](https://huggingface.co/huihui-ai/Qwen2.5-14B-Instruct-abliterated-v2) to minimize IFEVAL loss often seen in model_stock merges**
|
||||||
|
- **Separate branches for aggressive breadcrumbs and conservative DELLA merges**
|
||||||
|
- **Highly targeted weight/density gradients for every 2-4 layers, at each stage**
|
||||||
|
- **Finalization through SLERP+TIES merges recombining the breadcrumbs and DELLA branches to taste**
|
||||||
|
|
||||||
|
Lamarck's performance comes from an ancestry that goes back through careful merges to select finetuning work, upcycled and combined. Through intermediate merges, [arcee-ai/Virtuoso-Small](https://huggingface.co/arcee-ai/Virtuoso-Small) [sthenno-com/miscii-14b-1225](https://huggingface.co/sthenno-com/miscii-14b-1225) and [VAGOsolutions/SauerkrautLM-v2-14b-DPO](https://huggingface.co/VAGOsolutions/SauerkrautLM-v2-14b-DPO) are emphasized in early layers for extra BBH; later layers add synergistic influence from [deepseek-ai/DeepSeek-R1-Distill-Qwen-14B](https://huggingface.co/deepseek-ai/DeepSeek-R1-Distill-Qwen-14B), [Krystalan/DRT-o1-14B](https://huggingface.co/Krystalan/DRT-o1-14B), [EVA-UNIT-01/EVA-Qwen2.5-14B-v0.2](https://huggingface.co/EVA-UNIT-01/EVA-Qwen2.5-14B-v0.2), and [CultriX/Qwen2.5-14B-Wernicke](https://huggingface.co/CultriX/Qwen2.5-14B-Wernicke).
|
||||||
|
|
||||||
|
More subjectively, its prose and translation abilities are boosted by repeated re-emphasis of [Krystalan/DRT-o1-14B](https://huggingface.co/Krystalan/DRT-o1-14B) and [underwoods/medius-erebus-magnum-14b](https://huggingface.co/underwoods/medius-erebus-magnum-14b). Other models found in [sometimesanotion/Qwenvergence-14B-v3-Prose](https://huggingface/sometimesanotion/Qwenvergence-14B-v3-Prose) have their impact on prose quality - and surprising synergy of reasoning.
|
||||||
|
|
||||||
|
Kudos to @arcee-ai, @deepseek-ai, @Krystalan, @underwoods, @VAGOSolutions, @CultriX, @sthenno-com, and @rombodawg whose models had the most influence. [Vimarckoso v3](https://huggingface.co/sometimesanotion/Qwen2.5-14B-Vimarckoso-v3) has the model card which documents its extended lineage.
|
||||||
24
added_tokens.json
Normal file
24
added_tokens.json
Normal file
@@ -0,0 +1,24 @@
|
|||||||
|
{
|
||||||
|
"</tool_call>": 151658,
|
||||||
|
"<tool_call>": 151657,
|
||||||
|
"<|box_end|>": 151649,
|
||||||
|
"<|box_start|>": 151648,
|
||||||
|
"<|endoftext|>": 151643,
|
||||||
|
"<|file_sep|>": 151664,
|
||||||
|
"<|fim_middle|>": 151660,
|
||||||
|
"<|fim_pad|>": 151662,
|
||||||
|
"<|fim_prefix|>": 151659,
|
||||||
|
"<|fim_suffix|>": 151661,
|
||||||
|
"<|im_end|>": 151645,
|
||||||
|
"<|im_start|>": 151644,
|
||||||
|
"<|image_pad|>": 151655,
|
||||||
|
"<|object_ref_end|>": 151647,
|
||||||
|
"<|object_ref_start|>": 151646,
|
||||||
|
"<|quad_end|>": 151651,
|
||||||
|
"<|quad_start|>": 151650,
|
||||||
|
"<|repo_name|>": 151663,
|
||||||
|
"<|video_pad|>": 151656,
|
||||||
|
"<|vision_end|>": 151653,
|
||||||
|
"<|vision_pad|>": 151654,
|
||||||
|
"<|vision_start|>": 151652
|
||||||
|
}
|
||||||
28
config.json
Normal file
28
config.json
Normal file
@@ -0,0 +1,28 @@
|
|||||||
|
{
|
||||||
|
"_name_or_path": "sometimesanotion/finalize-slerp",
|
||||||
|
"architectures": [
|
||||||
|
"Qwen2ForCausalLM"
|
||||||
|
],
|
||||||
|
"attention_dropout": 0.0,
|
||||||
|
"eos_token_id": 151645,
|
||||||
|
"hidden_act": "silu",
|
||||||
|
"hidden_size": 5120,
|
||||||
|
"initializer_range": 0.02,
|
||||||
|
"intermediate_size": 13824,
|
||||||
|
"max_position_embeddings": 131072,
|
||||||
|
"max_window_layers": 70,
|
||||||
|
"model_type": "qwen2",
|
||||||
|
"num_attention_heads": 40,
|
||||||
|
"num_hidden_layers": 48,
|
||||||
|
"num_key_value_heads": 8,
|
||||||
|
"rms_norm_eps": 1e-06,
|
||||||
|
"rope_scaling": null,
|
||||||
|
"rope_theta": 1000000.0,
|
||||||
|
"sliding_window": null,
|
||||||
|
"tie_word_embeddings": false,
|
||||||
|
"torch_dtype": "bfloat16",
|
||||||
|
"transformers_version": "4.45.2",
|
||||||
|
"use_cache": false,
|
||||||
|
"use_sliding_window": false,
|
||||||
|
"vocab_size": 151665
|
||||||
|
}
|
||||||
39
mergekit_config.yml
Normal file
39
mergekit_config.yml
Normal file
@@ -0,0 +1,39 @@
|
|||||||
|
name: Lamarck-14B-v0.7-rc4-r1
|
||||||
|
merge_method: ties
|
||||||
|
base_model: sometimesanotion/finalize-slerp
|
||||||
|
tokenizer_source: base
|
||||||
|
dtype: float32
|
||||||
|
out_dtype: bfloat16
|
||||||
|
parameters:
|
||||||
|
density: 1.00
|
||||||
|
weight: 1.00
|
||||||
|
int8_mask: true
|
||||||
|
normalize: true
|
||||||
|
rescale: false
|
||||||
|
slices:
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 0, 2 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 2, 6 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 6, 10 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 10, 14 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 14, 18 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 18, 22 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 22, 26 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 26, 30 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 30, 34 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 34, 38 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 38, 42 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 42, 46 ], model: sometimesanotion/finalize-slerp }
|
||||||
|
- sources:
|
||||||
|
- { layer_range: [ 46, 48 ], model: sometimesanotion/finalize-slerp }
|
||||||
151388
merges.txt
Normal file
151388
merges.txt
Normal file
File diff suppressed because it is too large
Load Diff
3
model-00001-of-00006.safetensors
Normal file
3
model-00001-of-00006.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:c6dce47b217c8b6304a119c4f1d5c936b4da4139ea1d72e31e84d4bad9a35696
|
||||||
|
size 4899283440
|
||||||
3
model-00002-of-00006.safetensors
Normal file
3
model-00002-of-00006.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:e59df5728450b4c90df040fd9016b4d9fa638ceb83518685fda7c3e8837e86fc
|
||||||
|
size 4954847384
|
||||||
3
model-00003-of-00006.safetensors
Normal file
3
model-00003-of-00006.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:0401d087af6f2a2151bd46e9f5c8c5e172c45506fa5d157bb498a89e6e4bba9c
|
||||||
|
size 4954847376
|
||||||
3
model-00004-of-00006.safetensors
Normal file
3
model-00004-of-00006.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:dbb5c994ee1de6d611cba5dc55ff61934246383840398f9350fa5bbd0a260eef
|
||||||
|
size 4954847376
|
||||||
3
model-00005-of-00006.safetensors
Normal file
3
model-00005-of-00006.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:aeb5e577ee137114ffdb44fc87822a1370b3959b3a86d81700d6e5869d800a37
|
||||||
|
size 4954847376
|
||||||
3
model-00006-of-00006.safetensors
Normal file
3
model-00006-of-00006.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:cb93ec4359a70fea61993a2cdaeca2d93497c678d856283c402eaa2df0157021
|
||||||
|
size 4813289432
|
||||||
1
model.safetensors.index.json
Normal file
1
model.safetensors.index.json
Normal file
File diff suppressed because one or more lines are too long
31
special_tokens_map.json
Normal file
31
special_tokens_map.json
Normal file
@@ -0,0 +1,31 @@
|
|||||||
|
{
|
||||||
|
"additional_special_tokens": [
|
||||||
|
"<|im_start|>",
|
||||||
|
"<|im_end|>",
|
||||||
|
"<|object_ref_start|>",
|
||||||
|
"<|object_ref_end|>",
|
||||||
|
"<|box_start|>",
|
||||||
|
"<|box_end|>",
|
||||||
|
"<|quad_start|>",
|
||||||
|
"<|quad_end|>",
|
||||||
|
"<|vision_start|>",
|
||||||
|
"<|vision_end|>",
|
||||||
|
"<|vision_pad|>",
|
||||||
|
"<|image_pad|>",
|
||||||
|
"<|video_pad|>"
|
||||||
|
],
|
||||||
|
"eos_token": {
|
||||||
|
"content": "<|im_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false
|
||||||
|
},
|
||||||
|
"pad_token": {
|
||||||
|
"content": "<|endoftext|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false
|
||||||
|
}
|
||||||
|
}
|
||||||
303282
tokenizer.json
Normal file
303282
tokenizer.json
Normal file
File diff suppressed because it is too large
Load Diff
207
tokenizer_config.json
Normal file
207
tokenizer_config.json
Normal file
@@ -0,0 +1,207 @@
|
|||||||
|
{
|
||||||
|
"add_bos_token": false,
|
||||||
|
"add_prefix_space": false,
|
||||||
|
"added_tokens_decoder": {
|
||||||
|
"151643": {
|
||||||
|
"content": "<|endoftext|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151644": {
|
||||||
|
"content": "<|im_start|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151645": {
|
||||||
|
"content": "<|im_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151646": {
|
||||||
|
"content": "<|object_ref_start|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151647": {
|
||||||
|
"content": "<|object_ref_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151648": {
|
||||||
|
"content": "<|box_start|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151649": {
|
||||||
|
"content": "<|box_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151650": {
|
||||||
|
"content": "<|quad_start|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151651": {
|
||||||
|
"content": "<|quad_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151652": {
|
||||||
|
"content": "<|vision_start|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151653": {
|
||||||
|
"content": "<|vision_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151654": {
|
||||||
|
"content": "<|vision_pad|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151655": {
|
||||||
|
"content": "<|image_pad|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151656": {
|
||||||
|
"content": "<|video_pad|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151657": {
|
||||||
|
"content": "<tool_call>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151658": {
|
||||||
|
"content": "</tool_call>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151659": {
|
||||||
|
"content": "<|fim_prefix|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151660": {
|
||||||
|
"content": "<|fim_middle|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151661": {
|
||||||
|
"content": "<|fim_suffix|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151662": {
|
||||||
|
"content": "<|fim_pad|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151663": {
|
||||||
|
"content": "<|repo_name|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151664": {
|
||||||
|
"content": "<|file_sep|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
}
|
||||||
|
},
|
||||||
|
"additional_special_tokens": [
|
||||||
|
"<|im_start|>",
|
||||||
|
"<|im_end|>",
|
||||||
|
"<|object_ref_start|>",
|
||||||
|
"<|object_ref_end|>",
|
||||||
|
"<|box_start|>",
|
||||||
|
"<|box_end|>",
|
||||||
|
"<|quad_start|>",
|
||||||
|
"<|quad_end|>",
|
||||||
|
"<|vision_start|>",
|
||||||
|
"<|vision_end|>",
|
||||||
|
"<|vision_pad|>",
|
||||||
|
"<|image_pad|>",
|
||||||
|
"<|video_pad|>"
|
||||||
|
],
|
||||||
|
"bos_token": null,
|
||||||
|
"chat_template": "{%- if tools %}\n {{- '<|im_start|>system\\n' }}\n {%- if messages[0]['role'] == 'system' %}\n {{- messages[0]['content'] }}\n {%- else %}\n {{- 'You are Virtuoso Small, created by Arcee AI. You are a helpful assistant.' }}\n {%- endif %}\n {{- \"\\n\\n# Tools\\n\\nYou may call one or more functions to assist with the user query.\\n\\nYou are provided with function signatures within <tools></tools> XML tags:\\n<tools>\" }}\n {%- for tool in tools %}\n {{- \"\\n\" }}\n {{- tool | tojson }}\n {%- endfor %}\n {{- \"\\n</tools>\\n\\nFor each function call, return a json object with function name and arguments within <tool_call></tool_call> XML tags:\\n<tool_call>\\n{\\\"name\\\": <function-name>, \\\"arguments\\\": <args-json-object>}\\n</tool_call><|im_end|>\\n\" }}\n{%- else %}\n {%- if messages[0]['role'] == 'system' %}\n {{- '<|im_start|>system\\n' + messages[0]['content'] + '<|im_end|>\\n' }}\n {%- else %}\n {{- '<|im_start|>system\\nYou are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>\\n' }}\n {%- endif %}\n{%- endif %}\n{%- for message in messages %}\n {%- if (message.role == \"user\") or (message.role == \"system\" and not loop.first) or (message.role == \"assistant\" and not message.tool_calls) %}\n {{- '<|im_start|>' + message.role + '\\n' + message.content + '<|im_end|>' + '\\n' }}\n {%- elif message.role == \"assistant\" %}\n {{- '<|im_start|>' + message.role }}\n {%- if message.content %}\n {{- '\\n' + message.content }}\n {%- endif %}\n {%- for tool_call in message.tool_calls %}\n {%- if tool_call.function is defined %}\n {%- set tool_call = tool_call.function %}\n {%- endif %}\n {{- '\\n<tool_call>\\n{\"name\": \"' }}\n {{- tool_call.name }}\n {{- '\", \"arguments\": ' }}\n {{- tool_call.arguments | tojson }}\n {{- '}\\n</tool_call>' }}\n {%- endfor %}\n {{- '<|im_end|>\\n' }}\n {%- elif message.role == \"tool\" %}\n {%- if (loop.index0 == 0) or (messages[loop.index0 - 1].role != \"tool\") %}\n {{- '<|im_start|>user' }}\n {%- endif %}\n {{- '\\n<tool_response>\\n' }}\n {{- message.content }}\n {{- '\\n</tool_response>' }}\n {%- if loop.last or (messages[loop.index0 + 1].role != \"tool\") %}\n {{- '<|im_end|>\\n' }}\n {%- endif %}\n {%- endif %}\n{%- endfor %}\n{%- if add_generation_prompt %}\n {{- '<|im_start|>assistant\\n' }}\n{%- endif %}\n",
|
||||||
|
"clean_up_tokenization_spaces": false,
|
||||||
|
"eos_token": "<|im_end|>",
|
||||||
|
"errors": "replace",
|
||||||
|
"model_max_length": 131072,
|
||||||
|
"pad_token": "<|endoftext|>",
|
||||||
|
"split_special_tokens": false,
|
||||||
|
"tokenizer_class": "Qwen2Tokenizer",
|
||||||
|
"unk_token": null
|
||||||
|
}
|
||||||
1
vocab.json
Normal file
1
vocab.json
Normal file
File diff suppressed because one or more lines are too long
Reference in New Issue
Block a user