初始化项目,由ModelHub XC社区提供模型
Model: QwenPilot/FIPO_32B
Source: Original Platform
This commit is contained in:
 ModelHub XC
36
.gitattributes
vendored
Normal file
36
.gitattributes
vendored
Normal file
@@ -0,0 +1,36 @@
|
|||||||
|
*.7z filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.arrow filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.bin filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.bz2 filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.ckpt filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.ftz filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.gz filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.h5 filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.joblib filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.lfs.* filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.mlmodel filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.model filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.msgpack filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.npy filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.npz filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.onnx filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.ot filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.parquet filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.pb filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.pickle filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.pkl filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.pt filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.pth filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.rar filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.safetensors filter=lfs diff=lfs merge=lfs -text
|
||||||
|
saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.tar.* filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.tar filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.tflite filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.tgz filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.wasm filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.xz filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.zip filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*.zst filter=lfs diff=lfs merge=lfs -text
|
||||||
|
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
||||||
|
tokenizer.json filter=lfs diff=lfs merge=lfs -text
|
||||||
89
README.md
Normal file
89
README.md
Normal file
@@ -0,0 +1,89 @@
|
|||||||
|
---
|
||||||
|
base_model:
|
||||||
|
- Qwen/Qwen2.5-32B
|
||||||
|
datasets:
|
||||||
|
- BytedTsinghua-SIA/DAPO-Math-17k
|
||||||
|
language:
|
||||||
|
- en
|
||||||
|
license: apache-2.0
|
||||||
|
library_name: transformers
|
||||||
|
pipeline_tag: text-generation
|
||||||
|
---
|
||||||
|
|
||||||
|
# Note:
|
||||||
|
|
||||||
|
**Important update: we recently discovered that the checkpoint uploaded previously was from an intermediate training step and did not represent a fully converged model. We have since corrected this by replacing it with the proper converged checkpoint. We apologize for the oversight and will ensure the checkpoint remains up to date going forward.**
|
||||||
|
|
||||||
|
# FIPO: Eliciting Deep Reasoning with Future-KL Influenced Policy Optimization
|
||||||
|
|
||||||
|
🏠 [Homepage](https://qwen-pilot.notion.site/fipo) | 📝 [Paper PDF](https://arxiv.org/abs/2603.19835) | 🤗 [Hugging Face](https://huggingface.co/QwenPilot/FIPO_32B) | 🤖 [ModelScope](https://www.modelscope.cn/models/qwenpilot/FIPO_32B) | 🐱 [GitHub](https://github.com/qwenpilot/FIPO)
|
||||||
|
|
||||||
|
**Qwen Pilot, Alibaba Group | Published on March 20, 2026**
|
||||||
|
|
||||||
|
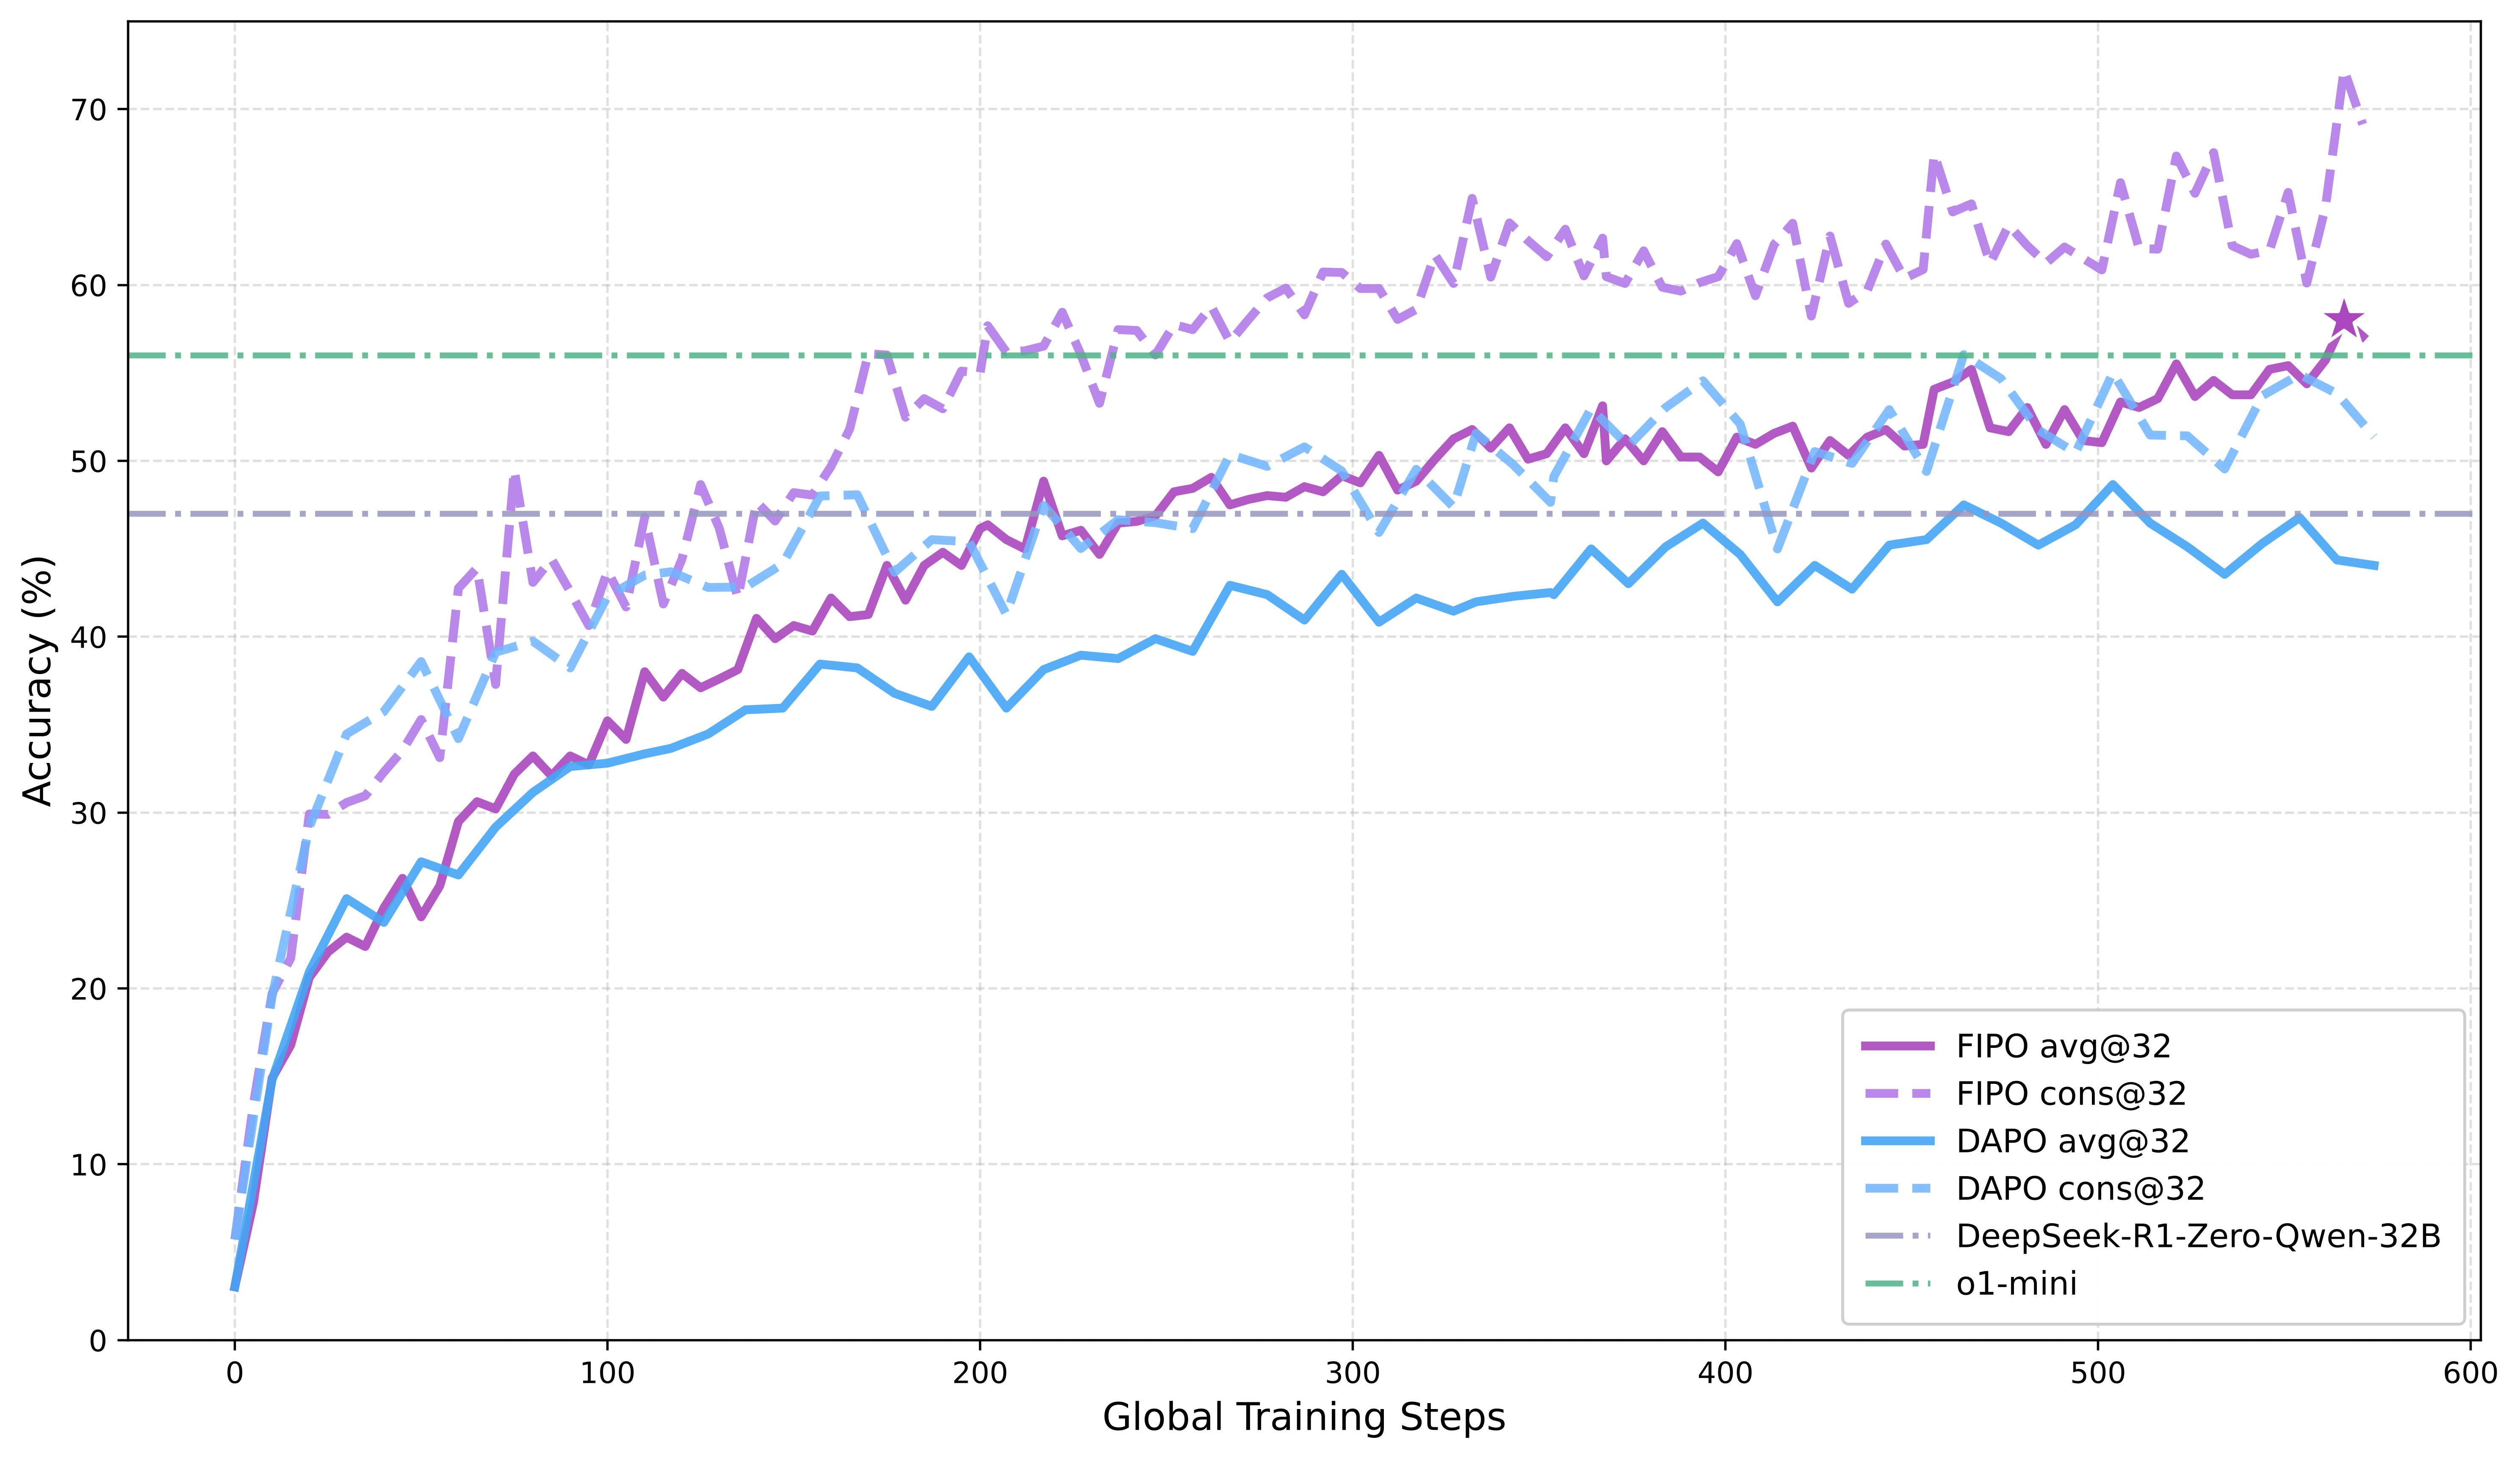
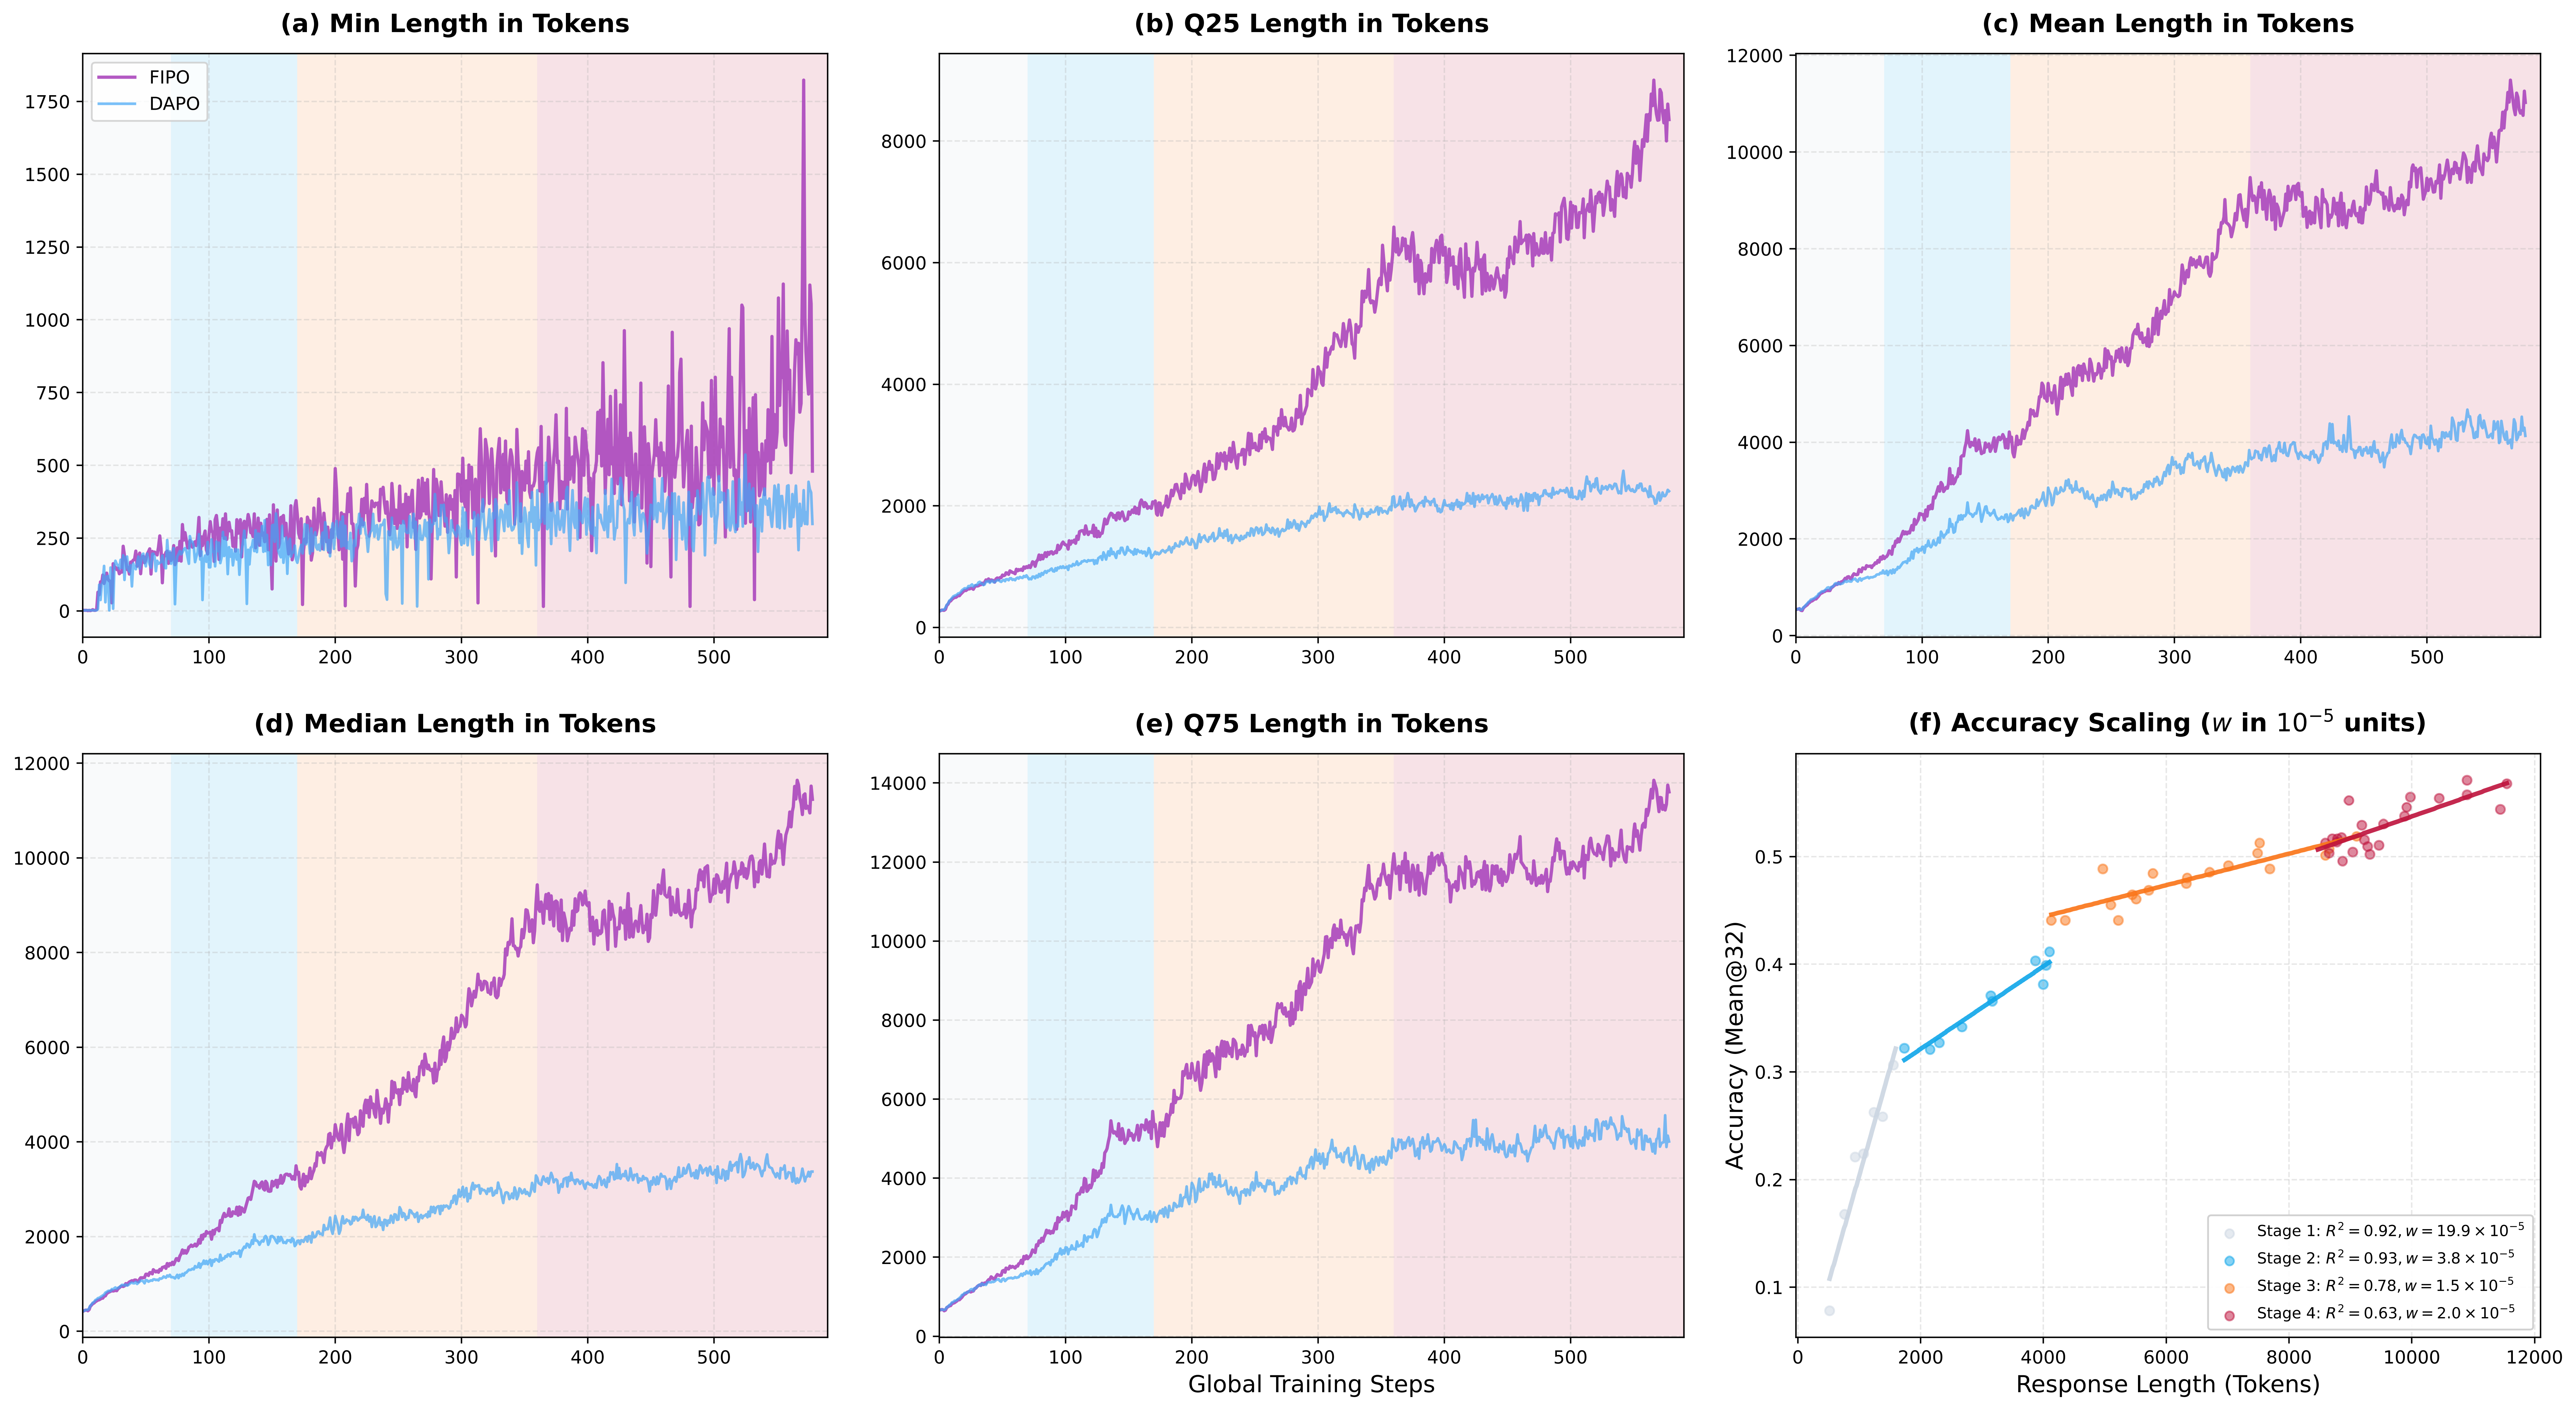
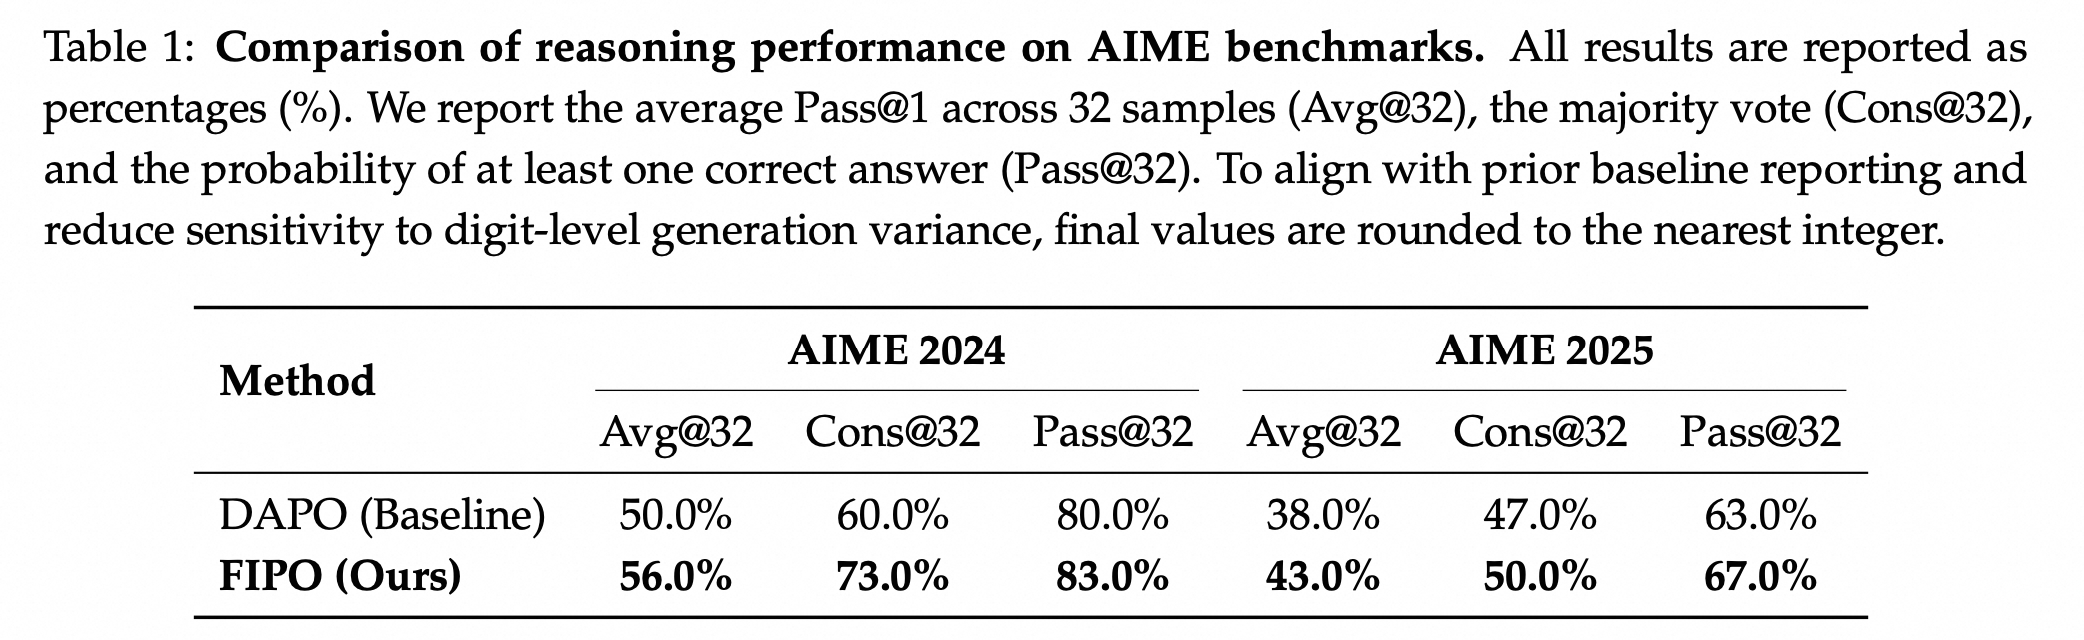
FIPO is a **value-free RL recipe** for eliciting deeper reasoning from a clean base model. The central idea is simple: GRPO-style training works, but its token credit assignment is too coarse. FIPO densifies that signal with a **discounted Future-KL term** that reflects how the rest of the trajectory evolves after each token. Empirically, this granular reinforcement allows the model to **break through the length stagnation** observed in standard baselines. Trained on Qwen2.5-32B-Base, FIPO extends the average chain-of-thought length from **4,000 to over 10,000 tokens**, driving AIME 2024 Pass@1 accuracy from **50.0% to a peak of 58.0% compared with DAPO**.
|
||||||
|
|
||||||
|
## Overview
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
*Figure 1. FIPO vs. baselines on AIME 2024. FIPO shows that pure RL training alone can outperform reproduced pure-RL baselines such as DAPO and DeepSeek-R1-Zero-32B, surpass o1-mini, and produce substantially longer responses on average.*
|
||||||
|
|
||||||
|
**Highlights**
|
||||||
|
|
||||||
|
- **Pure RL only:** FIPO outperforms reproduced DAPO and DeepSeek-R1-Zero-32B, and surpasses o1-mini on AIME 2024.
|
||||||
|
- **Dense advantage formulation:** instead of assigning one uniform outcome-level signal to all tokens, FIPO reweights each token by the discounted signed shift of its future trajectory.
|
||||||
|
- **Deeper reasoning:** on Qwen2.5-32B-Base, FIPO breaks the usual 4k-token plateau and extends average reasoning length to **10,000+** tokens.
|
||||||
|
- **Stronger performance:** AIME 2024 Pass@1 improves from **50.0%** to a peak of **58.0%**.
|
||||||
|
|
||||||
|
## Core Change
|
||||||
|
|
||||||
|
FIPO keeps the standard PPO/DAPO scaffold, but changes how token-level updates are weighted. The local signal is the signed log-probability shift between the current and old policy:
|
||||||
|
|
||||||
|
$$\Delta \log p_t = \log \pi_\theta(y_t \mid x, y_{1:t-1}) - \log \pi_{old}(y_t \mid x, y_{1:t-1})$$
|
||||||
|
|
||||||
|
Positive values mean the token is being reinforced, while negative values mean it is being suppressed. Since reasoning is sequential, FIPO then accumulates this signal over the future trajectory:
|
||||||
|
|
||||||
|
$$FutureKL_t = \sum_{k=t}^{T} M_k \cdot \gamma^{k-t} \cdot \Delta \log p_k$$
|
||||||
|
|
||||||
|
FIPO maps this future signal into a bounded influence weight:
|
||||||
|
|
||||||
|
$$f_t = \text{clip}(\exp(FutureKL_t), 1-\epsilon_{f,low}, 1+\epsilon_{f,high}), \quad \tilde{A}_t = \hat{A}_t \cdot f_t$$
|
||||||
|
|
||||||
|
The final token-level FIPO loss keeps the standard clipped PPO/DAPO form, but replaces the original advantage with the future-aware one:
|
||||||
|
|
||||||
|
$$r_t = \frac{\pi_\theta(y_t \mid x, y_{1:t-1})}{\pi_{old}(y_t \mid x, y_{1:t-1})}$$
|
||||||
|
|
||||||
|
$$L_t^{FIPO} = \min(r_t \tilde{A}_t,\; \text{clip}(r_t, 1-\epsilon, 1+\epsilon)\tilde{A}_t)$$
|
||||||
|
|
||||||
|
## 📊 Results & Figures
|
||||||
|
|
||||||
|
### Training Dynamics
|
||||||
|
|
||||||
|
Under FIPO, the model continues to expand its reasoning budget instead of collapsing into that intermediate plateau. This helps the model use additional length as **genuine reasoning depth**.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
*Figure 2. Dynamics of response length and performance scaling during training. Compared to the DAPO baseline, FIPO significantly increases response length and maintains a strong positive correlation between longer chain-of-thought and higher accuracy.*
|
||||||
|
|
||||||
|
### Main Result
|
||||||
|
|
||||||
|
The FIPO objective yields longer responses and a stronger AIME 2024 peak than the DAPO baseline.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
*Figure 3. Main 32B result. FIPO outperforms reproduced pure-RL baselines on AIME 2024 while also producing substantially longer responses on average.*
|
||||||
|
|
||||||
|
## 🎈 Citation
|
||||||
|
|
||||||
|
```bibtex
|
||||||
|
@article{ma2026fipo,
|
||||||
|
title={FIPO: Eliciting Deep Reasoning with Future-KL Influenced Policy Optimization},
|
||||||
|
author={Ma, Chiyu and Yang, Shuo and Huang, Kexin and Lu, Jinda and Meng, Haoming and Shangshang Wang and Bolin Ding and Soroush Vosoughi and Guoyin Wang and Jingren Zhou},
|
||||||
|
journal={arXiv preprint arXiv:2603.19835},
|
||||||
|
year={2026}
|
||||||
|
}
|
||||||
|
```
|
||||||
|
|
||||||
|
## 🌻 Acknowledgement
|
||||||
|
|
||||||
|
This project builds on top of the [VeRL](https://github.com/volcengine/verl) training framework and follows the practical recipe structure introduced by [DAPO](https://github.com/Bytedance-Research/DAPO).
|
||||||
24
added_tokens.json
Normal file
24
added_tokens.json
Normal file
@@ -0,0 +1,24 @@
|
|||||||
|
{
|
||||||
|
"</tool_call>": 151658,
|
||||||
|
"<tool_call>": 151657,
|
||||||
|
"<|box_end|>": 151649,
|
||||||
|
"<|box_start|>": 151648,
|
||||||
|
"<|endoftext|>": 151643,
|
||||||
|
"<|file_sep|>": 151664,
|
||||||
|
"<|fim_middle|>": 151660,
|
||||||
|
"<|fim_pad|>": 151662,
|
||||||
|
"<|fim_prefix|>": 151659,
|
||||||
|
"<|fim_suffix|>": 151661,
|
||||||
|
"<|im_end|>": 151645,
|
||||||
|
"<|im_start|>": 151644,
|
||||||
|
"<|image_pad|>": 151655,
|
||||||
|
"<|object_ref_end|>": 151647,
|
||||||
|
"<|object_ref_start|>": 151646,
|
||||||
|
"<|quad_end|>": 151651,
|
||||||
|
"<|quad_start|>": 151650,
|
||||||
|
"<|repo_name|>": 151663,
|
||||||
|
"<|video_pad|>": 151656,
|
||||||
|
"<|vision_end|>": 151653,
|
||||||
|
"<|vision_pad|>": 151654,
|
||||||
|
"<|vision_start|>": 151652
|
||||||
|
}
|
||||||
28
config.json
Normal file
28
config.json
Normal file
@@ -0,0 +1,28 @@
|
|||||||
|
{
|
||||||
|
"architectures": [
|
||||||
|
"Qwen2ForCausalLM"
|
||||||
|
],
|
||||||
|
"attention_dropout": 0.0,
|
||||||
|
"eos_token_id": 151643,
|
||||||
|
"hidden_act": "silu",
|
||||||
|
"hidden_size": 5120,
|
||||||
|
"initializer_range": 0.02,
|
||||||
|
"intermediate_size": 27648,
|
||||||
|
"max_position_embeddings": 131072,
|
||||||
|
"max_window_layers": 64,
|
||||||
|
"model_type": "qwen2",
|
||||||
|
"num_attention_heads": 40,
|
||||||
|
"num_hidden_layers": 64,
|
||||||
|
"num_key_value_heads": 8,
|
||||||
|
"pad_token_id": 151643,
|
||||||
|
"rms_norm_eps": 1e-05,
|
||||||
|
"rope_scaling": null,
|
||||||
|
"rope_theta": 1000000.0,
|
||||||
|
"sliding_window": 131072,
|
||||||
|
"tie_word_embeddings": false,
|
||||||
|
"torch_dtype": "bfloat16",
|
||||||
|
"transformers_version": "4.51.2",
|
||||||
|
"use_cache": true,
|
||||||
|
"use_sliding_window": false,
|
||||||
|
"vocab_size": 152064
|
||||||
|
}
|
||||||
1
configuration.json
Normal file
1
configuration.json
Normal file
@@ -0,0 +1 @@
|
|||||||
|
{"framework": "pytorch", "task": "other"}
|
||||||
6
generation_config.json
Normal file
6
generation_config.json
Normal file
@@ -0,0 +1,6 @@
|
|||||||
|
{
|
||||||
|
"bos_token_id": 151643,
|
||||||
|
"eos_token_id": 151643,
|
||||||
|
"max_new_tokens": 2048,
|
||||||
|
"transformers_version": "4.51.2"
|
||||||
|
}
|
||||||
151388
merges.txt
Normal file
151388
merges.txt
Normal file
File diff suppressed because it is too large
Load Diff
3
model-00001-of-00014.safetensors
Normal file
3
model-00001-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:efc57ea4d7ce8e9bb3b62850ee8202b7a9bf640c5ded5740267c8bb10474a63f
|
||||||
|
size 4991381672
|
||||||
3
model-00002-of-00014.safetensors
Normal file
3
model-00002-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:3dfd50d9258716c35ea55fd5ad5e270f49e14d19ddecabc0b22099833dd4a2c4
|
||||||
|
size 4917923224
|
||||||
3
model-00003-of-00014.safetensors
Normal file
3
model-00003-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:7fb09f1385428bbbcda33d55d41002b06d4d190fe7f8d946e8494e81989a2b6b
|
||||||
|
size 4572017744
|
||||||
3
model-00004-of-00014.safetensors
Normal file
3
model-00004-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:d943f94d078ca2023d702d7391b688e5044de82de3b1b34d8cdbab6b40fb9280
|
||||||
|
size 4744886088
|
||||||
3
model-00005-of-00014.safetensors
Normal file
3
model-00005-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:89c86f9c4972d0844ca339b8e362d5b4b22154071a449e2823f4cdd0dd4166da
|
||||||
|
size 4771117824
|
||||||
3
model-00006-of-00014.safetensors
Normal file
3
model-00006-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:28cc5e6c6ce7fb993d55b815026c3f7add9e15cd4d3a7bc33f88ed6323efda8a
|
||||||
|
size 4839341832
|
||||||
3
model-00007-of-00014.safetensors
Normal file
3
model-00007-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:a5298acbe5ba54d4643124e643316937cb1da24b0311e15a9126b7804b789d1d
|
||||||
|
size 4960004200
|
||||||
3
model-00008-of-00014.safetensors
Normal file
3
model-00008-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:ef286120d278f5325a4e86f2abde7cc437d1aeb1be09e1c4b56fefc35fb8b732
|
||||||
|
size 4970426792
|
||||||
3
model-00009-of-00014.safetensors
Normal file
3
model-00009-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:dc41571deb28a5c7db3935bfbd1cedff7c88f92361db23fce3e0fa811f9ebbd1
|
||||||
|
size 4991510416
|
||||||
3
model-00010-of-00014.safetensors
Normal file
3
model-00010-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:ecb2ba8049551c8e78de4381cf72a56e5642900bb1007f8382e57b3fcd0c2363
|
||||||
|
size 4750255088
|
||||||
3
model-00011-of-00014.safetensors
Normal file
3
model-00011-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:3a8d803cf8e6d1bfa00841276abc239faeff5b9107c53ce7068a542cbac933ba
|
||||||
|
size 4729227280
|
||||||
3
model-00012-of-00014.safetensors
Normal file
3
model-00012-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:a1f0be67d21eeaf431366e2784c9019ffea8208b7ea9f5dd8dbacfa08e860e8c
|
||||||
|
size 4844587096
|
||||||
3
model-00013-of-00014.safetensors
Normal file
3
model-00013-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:8b71de7aaf2b3c30aa99de88e5e2631b05b244536c5efecf61c20b3a52c17196
|
||||||
|
size 4781671040
|
||||||
3
model-00014-of-00014.safetensors
Normal file
3
model-00014-of-00014.safetensors
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:f105e23a09c244ba63727dedc392b241b4a81b4d364e16c2333c925c4c948c27
|
||||||
|
size 2663491240
|
||||||
778
model.safetensors.index.json
Normal file
778
model.safetensors.index.json
Normal file
@@ -0,0 +1,778 @@
|
|||||||
|
{
|
||||||
|
"metadata": {
|
||||||
|
"total_size": 65527752704
|
||||||
|
},
|
||||||
|
"weight_map": {
|
||||||
|
"lm_head.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.embed_tokens.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.0.input_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.0.mlp.down_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.0.mlp.gate_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.0.mlp.up_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.0.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.0.self_attn.k_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.0.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.0.self_attn.o_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.0.self_attn.q_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.0.self_attn.q_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.0.self_attn.v_proj.bias": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.0.self_attn.v_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.1.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.1.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.1.mlp.gate_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.1.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.1.post_attention_layernorm.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.1.self_attn.k_proj.bias": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.1.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.1.self_attn.o_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.1.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.1.self_attn.q_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.1.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.1.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.10.input_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.10.mlp.down_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.10.mlp.gate_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.10.mlp.up_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.10.post_attention_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.10.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.10.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.10.self_attn.o_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.10.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.10.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.10.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.10.self_attn.v_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.11.input_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.11.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.11.mlp.gate_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.11.mlp.up_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.11.post_attention_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.11.self_attn.k_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.11.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.11.self_attn.o_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.11.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.11.self_attn.q_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.11.self_attn.v_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.11.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.12.input_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.12.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.12.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.12.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.12.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.12.self_attn.k_proj.bias": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.12.self_attn.k_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.12.self_attn.o_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.12.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.12.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.12.self_attn.v_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.12.self_attn.v_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.13.input_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.13.mlp.down_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.13.mlp.gate_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.13.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.13.post_attention_layernorm.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.13.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.13.self_attn.k_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.13.self_attn.o_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.13.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.13.self_attn.q_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.13.self_attn.v_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.13.self_attn.v_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.14.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.14.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.14.mlp.gate_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.14.mlp.up_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.14.post_attention_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.14.self_attn.k_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.14.self_attn.k_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.14.self_attn.o_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.14.self_attn.q_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.14.self_attn.q_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.14.self_attn.v_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.14.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.15.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.15.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.15.mlp.gate_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.15.mlp.up_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.15.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.15.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.15.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.15.self_attn.o_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.15.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.15.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.15.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.15.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.16.input_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.16.mlp.down_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.16.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.16.mlp.up_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.16.post_attention_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.16.self_attn.k_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.16.self_attn.k_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.16.self_attn.o_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.16.self_attn.q_proj.bias": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.16.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.16.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.16.self_attn.v_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.17.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.17.mlp.down_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.17.mlp.gate_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.17.mlp.up_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.17.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.17.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.17.self_attn.k_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.17.self_attn.o_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.17.self_attn.q_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.17.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.17.self_attn.v_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.17.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.18.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.18.mlp.down_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.18.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.18.mlp.up_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.18.post_attention_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.18.self_attn.k_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.18.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.18.self_attn.o_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.18.self_attn.q_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.18.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.18.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.18.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.19.input_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.19.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.19.mlp.gate_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.19.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.19.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.19.self_attn.k_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.19.self_attn.k_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.19.self_attn.o_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.19.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.19.self_attn.q_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.19.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.19.self_attn.v_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.2.input_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.2.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.2.mlp.gate_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.2.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.2.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.2.self_attn.k_proj.bias": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.2.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.2.self_attn.o_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.2.self_attn.q_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.2.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.2.self_attn.v_proj.bias": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.2.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.20.input_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.20.mlp.down_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.20.mlp.gate_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.20.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.20.post_attention_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.20.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.20.self_attn.k_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.20.self_attn.o_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.20.self_attn.q_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.20.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.20.self_attn.v_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.20.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.21.input_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.21.mlp.down_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.21.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.21.mlp.up_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.21.post_attention_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.21.self_attn.k_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.21.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.21.self_attn.o_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.21.self_attn.q_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.21.self_attn.q_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.21.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.21.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.22.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.22.mlp.down_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.22.mlp.gate_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.22.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.22.post_attention_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.22.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.22.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.22.self_attn.o_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.22.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.22.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.22.self_attn.v_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.22.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.23.input_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.23.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.23.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.23.mlp.up_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.23.post_attention_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.23.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.23.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.23.self_attn.o_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.23.self_attn.q_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.23.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.23.self_attn.v_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.23.self_attn.v_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.24.input_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.24.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.24.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.24.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.24.post_attention_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.24.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.24.self_attn.k_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.24.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.24.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.24.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.24.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.24.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.25.input_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.25.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.25.mlp.gate_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.25.mlp.up_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.25.post_attention_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.25.self_attn.k_proj.bias": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.25.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.25.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.25.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.25.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.25.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.25.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.26.input_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.26.mlp.down_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.26.mlp.gate_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.26.mlp.up_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.26.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.26.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.26.self_attn.k_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.26.self_attn.o_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.26.self_attn.q_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.26.self_attn.q_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.26.self_attn.v_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.26.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.27.input_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.27.mlp.down_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.27.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.27.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.27.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.27.self_attn.k_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.27.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.27.self_attn.o_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.27.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.27.self_attn.q_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.27.self_attn.v_proj.bias": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.27.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.28.input_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.28.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.28.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.28.mlp.up_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.28.post_attention_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.28.self_attn.k_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.28.self_attn.k_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.28.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.28.self_attn.q_proj.bias": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.28.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.28.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.28.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.29.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.29.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.29.mlp.gate_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.29.mlp.up_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.29.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.29.self_attn.k_proj.bias": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.29.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.29.self_attn.o_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.29.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.29.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.29.self_attn.v_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.29.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.3.input_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.3.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.3.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.3.mlp.up_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.3.post_attention_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.3.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.3.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.3.self_attn.o_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.3.self_attn.q_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.3.self_attn.q_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.3.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.3.self_attn.v_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.30.input_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.30.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.30.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.30.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.30.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.30.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.30.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.30.self_attn.o_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.30.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.30.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.30.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.30.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.31.input_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.31.mlp.down_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.31.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.31.mlp.up_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.31.post_attention_layernorm.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.31.self_attn.k_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.31.self_attn.k_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.31.self_attn.o_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.31.self_attn.q_proj.bias": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.31.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.31.self_attn.v_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.31.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.32.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.32.mlp.down_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.32.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.32.mlp.up_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.32.post_attention_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.32.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.32.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.32.self_attn.o_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.32.self_attn.q_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.32.self_attn.q_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.32.self_attn.v_proj.bias": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.32.self_attn.v_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.33.input_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.33.mlp.down_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.33.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.33.mlp.up_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.33.post_attention_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.33.self_attn.k_proj.bias": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.33.self_attn.k_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.33.self_attn.o_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.33.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.33.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.33.self_attn.v_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.33.self_attn.v_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.34.input_layernorm.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.34.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.34.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.34.mlp.up_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.34.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.34.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.34.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.34.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.34.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.34.self_attn.q_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.34.self_attn.v_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.34.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.35.input_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.35.mlp.down_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.35.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.35.mlp.up_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.35.post_attention_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.35.self_attn.k_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.35.self_attn.k_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.35.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.35.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.35.self_attn.q_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.35.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.35.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.36.input_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.36.mlp.down_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.36.mlp.gate_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.36.mlp.up_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.36.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.36.self_attn.k_proj.bias": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.36.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.36.self_attn.o_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.36.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.36.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.36.self_attn.v_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.36.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.37.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.37.mlp.down_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.37.mlp.gate_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.37.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.37.post_attention_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.37.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.37.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.37.self_attn.o_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.37.self_attn.q_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.37.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.37.self_attn.v_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.37.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.38.input_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.38.mlp.down_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.38.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.38.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.38.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.38.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.38.self_attn.k_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.38.self_attn.o_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.38.self_attn.q_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.38.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.38.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.38.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.39.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.39.mlp.down_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.39.mlp.gate_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.39.mlp.up_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.39.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.39.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.39.self_attn.k_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.39.self_attn.o_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.39.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.39.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.39.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.39.self_attn.v_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.4.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.4.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.4.mlp.gate_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.4.mlp.up_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.4.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.4.self_attn.k_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.4.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.4.self_attn.o_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.4.self_attn.q_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.4.self_attn.q_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.4.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.4.self_attn.v_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.40.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.40.mlp.down_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.40.mlp.gate_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.40.mlp.up_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.40.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.40.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.40.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.40.self_attn.o_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.40.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.40.self_attn.q_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.40.self_attn.v_proj.bias": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.40.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.41.input_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.41.mlp.down_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.41.mlp.gate_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.41.mlp.up_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.41.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.41.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.41.self_attn.k_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.41.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.41.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.41.self_attn.q_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.41.self_attn.v_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.41.self_attn.v_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.42.input_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.42.mlp.down_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.42.mlp.gate_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.42.mlp.up_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.42.post_attention_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.42.self_attn.k_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.42.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.42.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.42.self_attn.q_proj.bias": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.42.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.42.self_attn.v_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.42.self_attn.v_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.43.input_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.43.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.43.mlp.gate_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.43.mlp.up_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.43.post_attention_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.43.self_attn.k_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.43.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.43.self_attn.o_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.43.self_attn.q_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.43.self_attn.q_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.43.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.43.self_attn.v_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.44.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.44.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.44.mlp.gate_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.44.mlp.up_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.44.post_attention_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.44.self_attn.k_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.44.self_attn.k_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.44.self_attn.o_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.44.self_attn.q_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.44.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.44.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.44.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.45.input_layernorm.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.45.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.45.mlp.gate_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.45.mlp.up_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.45.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.45.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.45.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.45.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.45.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.45.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.45.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.45.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.46.input_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.46.mlp.down_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.46.mlp.gate_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.46.mlp.up_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.46.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.46.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.46.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.46.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.46.self_attn.q_proj.bias": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.46.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.46.self_attn.v_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.46.self_attn.v_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.47.input_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.47.mlp.down_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.47.mlp.gate_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.47.mlp.up_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.47.post_attention_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.47.self_attn.k_proj.bias": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.47.self_attn.k_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.47.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.47.self_attn.q_proj.bias": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.47.self_attn.q_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.47.self_attn.v_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.47.self_attn.v_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.48.input_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.48.mlp.down_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.48.mlp.gate_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.48.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.48.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.48.self_attn.k_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.48.self_attn.k_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.48.self_attn.o_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.48.self_attn.q_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.48.self_attn.q_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.48.self_attn.v_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.48.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.49.input_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.49.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.49.mlp.gate_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.49.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.49.post_attention_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.49.self_attn.k_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.49.self_attn.k_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.49.self_attn.o_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.49.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.49.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.49.self_attn.v_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.49.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.5.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.5.mlp.down_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.5.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.5.mlp.up_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.5.post_attention_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.5.self_attn.k_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.5.self_attn.k_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.5.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.5.self_attn.q_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.5.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.5.self_attn.v_proj.bias": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.5.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.50.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.50.mlp.down_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.50.mlp.gate_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.50.mlp.up_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.50.post_attention_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.50.self_attn.k_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.50.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.50.self_attn.o_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.50.self_attn.q_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.50.self_attn.q_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.50.self_attn.v_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.50.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.51.input_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.51.mlp.down_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.51.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.51.mlp.up_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.51.post_attention_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.51.self_attn.k_proj.bias": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.51.self_attn.k_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.51.self_attn.o_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.51.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.51.self_attn.q_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.51.self_attn.v_proj.bias": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.51.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.52.input_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.52.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.52.mlp.gate_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.52.mlp.up_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.52.post_attention_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.52.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.52.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.52.self_attn.o_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.52.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.52.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.52.self_attn.v_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.52.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.53.input_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.53.mlp.down_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.53.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.53.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.53.post_attention_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.53.self_attn.k_proj.bias": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.53.self_attn.k_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.53.self_attn.o_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.53.self_attn.q_proj.bias": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.53.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.53.self_attn.v_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.53.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.54.input_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.54.mlp.down_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.54.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.54.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.54.post_attention_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.54.self_attn.k_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.54.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.54.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.54.self_attn.q_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.54.self_attn.q_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.54.self_attn.v_proj.bias": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.54.self_attn.v_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.55.input_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.55.mlp.down_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.55.mlp.gate_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.55.mlp.up_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.55.post_attention_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.55.self_attn.k_proj.bias": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.55.self_attn.k_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.55.self_attn.o_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.55.self_attn.q_proj.bias": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.55.self_attn.q_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.55.self_attn.v_proj.bias": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.55.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.56.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.56.mlp.down_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.56.mlp.gate_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.56.mlp.up_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.56.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.56.self_attn.k_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.56.self_attn.k_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.56.self_attn.o_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.56.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.56.self_attn.q_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.56.self_attn.v_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.56.self_attn.v_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.57.input_layernorm.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.57.mlp.down_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.57.mlp.gate_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.57.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.57.post_attention_layernorm.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.57.self_attn.k_proj.bias": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.57.self_attn.k_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.57.self_attn.o_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.57.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.57.self_attn.q_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.57.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.57.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.58.input_layernorm.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.58.mlp.down_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.58.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.58.mlp.up_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.58.post_attention_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.58.self_attn.k_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.58.self_attn.k_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.58.self_attn.o_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.58.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.58.self_attn.q_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.58.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.58.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.59.input_layernorm.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.59.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.59.mlp.gate_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.59.mlp.up_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.59.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.59.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.59.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.59.self_attn.o_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.59.self_attn.q_proj.bias": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.59.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.59.self_attn.v_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.59.self_attn.v_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.6.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.6.mlp.down_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.6.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.6.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.6.post_attention_layernorm.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.6.self_attn.k_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.6.self_attn.k_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.6.self_attn.o_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.6.self_attn.q_proj.bias": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.6.self_attn.q_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.6.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.6.self_attn.v_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.60.input_layernorm.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.60.mlp.down_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.60.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.60.mlp.up_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.60.post_attention_layernorm.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.60.self_attn.k_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.60.self_attn.k_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.60.self_attn.o_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.60.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.60.self_attn.q_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.60.self_attn.v_proj.bias": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.60.self_attn.v_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.61.input_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.61.mlp.down_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.61.mlp.gate_proj.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.61.mlp.up_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.61.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.61.self_attn.k_proj.bias": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.61.self_attn.k_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.61.self_attn.o_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.61.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.61.self_attn.q_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.61.self_attn.v_proj.bias": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.61.self_attn.v_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.62.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.62.mlp.down_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.62.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.62.mlp.up_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.62.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.62.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.62.self_attn.k_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.62.self_attn.o_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.62.self_attn.q_proj.bias": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.62.self_attn.q_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.62.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.62.self_attn.v_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.63.input_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.63.mlp.down_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.63.mlp.gate_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.63.mlp.up_proj.weight": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.63.post_attention_layernorm.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.63.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.63.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.63.self_attn.o_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.63.self_attn.q_proj.bias": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.63.self_attn.q_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.63.self_attn.v_proj.bias": "model-00011-of-00014.safetensors",
|
||||||
|
"model.layers.63.self_attn.v_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.7.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.7.mlp.down_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.7.mlp.gate_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.7.mlp.up_proj.weight": "model-00012-of-00014.safetensors",
|
||||||
|
"model.layers.7.post_attention_layernorm.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.7.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.7.self_attn.k_proj.weight": "model-00001-of-00014.safetensors",
|
||||||
|
"model.layers.7.self_attn.o_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.7.self_attn.q_proj.bias": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.7.self_attn.q_proj.weight": "model-00009-of-00014.safetensors",
|
||||||
|
"model.layers.7.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.7.self_attn.v_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.8.input_layernorm.weight": "model-00008-of-00014.safetensors",
|
||||||
|
"model.layers.8.mlp.down_proj.weight": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.8.mlp.gate_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.8.mlp.up_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.8.post_attention_layernorm.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.8.self_attn.k_proj.bias": "model-00005-of-00014.safetensors",
|
||||||
|
"model.layers.8.self_attn.k_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.8.self_attn.o_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.8.self_attn.q_proj.bias": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.8.self_attn.q_proj.weight": "model-00003-of-00014.safetensors",
|
||||||
|
"model.layers.8.self_attn.v_proj.bias": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.8.self_attn.v_proj.weight": "model-00013-of-00014.safetensors",
|
||||||
|
"model.layers.9.input_layernorm.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.9.mlp.down_proj.weight": "model-00006-of-00014.safetensors",
|
||||||
|
"model.layers.9.mlp.gate_proj.weight": "model-00014-of-00014.safetensors",
|
||||||
|
"model.layers.9.mlp.up_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.9.post_attention_layernorm.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.layers.9.self_attn.k_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.9.self_attn.k_proj.weight": "model-00002-of-00014.safetensors",
|
||||||
|
"model.layers.9.self_attn.o_proj.weight": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.9.self_attn.q_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.9.self_attn.q_proj.weight": "model-00004-of-00014.safetensors",
|
||||||
|
"model.layers.9.self_attn.v_proj.bias": "model-00007-of-00014.safetensors",
|
||||||
|
"model.layers.9.self_attn.v_proj.weight": "model-00010-of-00014.safetensors",
|
||||||
|
"model.norm.weight": "model-00010-of-00014.safetensors"
|
||||||
|
}
|
||||||
|
}
|
||||||
31
special_tokens_map.json
Normal file
31
special_tokens_map.json
Normal file
@@ -0,0 +1,31 @@
|
|||||||
|
{
|
||||||
|
"additional_special_tokens": [
|
||||||
|
"<|im_start|>",
|
||||||
|
"<|im_end|>",
|
||||||
|
"<|object_ref_start|>",
|
||||||
|
"<|object_ref_end|>",
|
||||||
|
"<|box_start|>",
|
||||||
|
"<|box_end|>",
|
||||||
|
"<|quad_start|>",
|
||||||
|
"<|quad_end|>",
|
||||||
|
"<|vision_start|>",
|
||||||
|
"<|vision_end|>",
|
||||||
|
"<|vision_pad|>",
|
||||||
|
"<|image_pad|>",
|
||||||
|
"<|video_pad|>"
|
||||||
|
],
|
||||||
|
"eos_token": {
|
||||||
|
"content": "<|endoftext|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false
|
||||||
|
},
|
||||||
|
"pad_token": {
|
||||||
|
"content": "<|endoftext|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false
|
||||||
|
}
|
||||||
|
}
|
||||||
3
tokenizer.json
Normal file
3
tokenizer.json
Normal file
@@ -0,0 +1,3 @@
|
|||||||
|
version https://git-lfs.github.com/spec/v1
|
||||||
|
oid sha256:9c5ae00e602b8860cbd784ba82a8aa14e8feecec692e7076590d014d7b7fdafa
|
||||||
|
size 11421896
|
||||||
208
tokenizer_config.json
Normal file
208
tokenizer_config.json
Normal file
@@ -0,0 +1,208 @@
|
|||||||
|
{
|
||||||
|
"add_bos_token": false,
|
||||||
|
"add_prefix_space": false,
|
||||||
|
"added_tokens_decoder": {
|
||||||
|
"151643": {
|
||||||
|
"content": "<|endoftext|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151644": {
|
||||||
|
"content": "<|im_start|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151645": {
|
||||||
|
"content": "<|im_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151646": {
|
||||||
|
"content": "<|object_ref_start|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151647": {
|
||||||
|
"content": "<|object_ref_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151648": {
|
||||||
|
"content": "<|box_start|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151649": {
|
||||||
|
"content": "<|box_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151650": {
|
||||||
|
"content": "<|quad_start|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151651": {
|
||||||
|
"content": "<|quad_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151652": {
|
||||||
|
"content": "<|vision_start|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151653": {
|
||||||
|
"content": "<|vision_end|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151654": {
|
||||||
|
"content": "<|vision_pad|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151655": {
|
||||||
|
"content": "<|image_pad|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151656": {
|
||||||
|
"content": "<|video_pad|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": true
|
||||||
|
},
|
||||||
|
"151657": {
|
||||||
|
"content": "<tool_call>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151658": {
|
||||||
|
"content": "</tool_call>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151659": {
|
||||||
|
"content": "<|fim_prefix|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151660": {
|
||||||
|
"content": "<|fim_middle|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151661": {
|
||||||
|
"content": "<|fim_suffix|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151662": {
|
||||||
|
"content": "<|fim_pad|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151663": {
|
||||||
|
"content": "<|repo_name|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
},
|
||||||
|
"151664": {
|
||||||
|
"content": "<|file_sep|>",
|
||||||
|
"lstrip": false,
|
||||||
|
"normalized": false,
|
||||||
|
"rstrip": false,
|
||||||
|
"single_word": false,
|
||||||
|
"special": false
|
||||||
|
}
|
||||||
|
},
|
||||||
|
"additional_special_tokens": [
|
||||||
|
"<|im_start|>",
|
||||||
|
"<|im_end|>",
|
||||||
|
"<|object_ref_start|>",
|
||||||
|
"<|object_ref_end|>",
|
||||||
|
"<|box_start|>",
|
||||||
|
"<|box_end|>",
|
||||||
|
"<|quad_start|>",
|
||||||
|
"<|quad_end|>",
|
||||||
|
"<|vision_start|>",
|
||||||
|
"<|vision_end|>",
|
||||||
|
"<|vision_pad|>",
|
||||||
|
"<|image_pad|>",
|
||||||
|
"<|video_pad|>"
|
||||||
|
],
|
||||||
|
"bos_token": null,
|
||||||
|
"chat_template": "{%- if tools %}\n {{- '<|im_start|>system\\n' }}\n {%- if messages[0]['role'] == 'system' %}\n {{- messages[0]['content'] }}\n {%- else %}\n {{- 'You are a helpful assistant.' }}\n {%- endif %}\n {{- \"\\n\\n# Tools\\n\\nYou may call one or more functions to assist with the user query.\\n\\nYou are provided with function signatures within <tools></tools> XML tags:\\n<tools>\" }}\n {%- for tool in tools %}\n {{- \"\\n\" }}\n {{- tool | tojson }}\n {%- endfor %}\n {{- \"\\n</tools>\\n\\nFor each function call, return a json object with function name and arguments within <tool_call></tool_call> XML tags:\\n<tool_call>\\n{\\\"name\\\": <function-name>, \\\"arguments\\\": <args-json-object>}\\n</tool_call><|im_end|>\\n\" }}\n{%- else %}\n {%- if messages[0]['role'] == 'system' %}\n {{- '<|im_start|>system\\n' + messages[0]['content'] + '<|im_end|>\\n' }}\n {%- else %}\n {{- '<|im_start|>system\\nYou are a helpful assistant.<|im_end|>\\n' }}\n {%- endif %}\n{%- endif %}\n{%- for message in messages %}\n {%- if (message.role == \"user\") or (message.role == \"system\" and not loop.first) or (message.role == \"assistant\" and not message.tool_calls) %}\n {{- '<|im_start|>' + message.role + '\\n' + message.content + '<|im_end|>' + '\\n' }}\n {%- elif message.role == \"assistant\" %}\n {{- '<|im_start|>' + message.role }}\n {%- if message.content %}\n {{- '\\n' + message.content }}\n {%- endif %}\n {%- for tool_call in message.tool_calls %}\n {%- if tool_call.function is defined %}\n {%- set tool_call = tool_call.function %}\n {%- endif %}\n {{- '\\n<tool_call>\\n{\"name\": \"' }}\n {{- tool_call.name }}\n {{- '\", \"arguments\": ' }}\n {{- tool_call.arguments | tojson }}\n {{- '}\\n</tool_call>' }}\n {%- endfor %}\n {{- '<|im_end|>\\n' }}\n {%- elif message.role == \"tool\" %}\n {%- if (loop.index0 == 0) or (messages[loop.index0 - 1].role != \"tool\") %}\n {{- '<|im_start|>user' }}\n {%- endif %}\n {{- '\\n<tool_response>\\n' }}\n {{- message.content }}\n {{- '\\n</tool_response>' }}\n {%- if loop.last or (messages[loop.index0 + 1].role != \"tool\") %}\n {{- '<|im_end|>\\n' }}\n {%- endif %}\n {%- endif %}\n{%- endfor %}\n{%- if add_generation_prompt %}\n {{- '<|im_start|>assistant\\n' }}\n{%- endif %}\n",
|
||||||
|
"clean_up_tokenization_spaces": false,
|
||||||
|
"eos_token": "<|endoftext|>",
|
||||||
|
"errors": "replace",
|
||||||
|
"extra_special_tokens": {},
|
||||||
|
"model_max_length": 131072,
|
||||||
|
"pad_token": "<|endoftext|>",
|
||||||
|
"split_special_tokens": false,
|
||||||
|
"tokenizer_class": "Qwen2Tokenizer",
|
||||||
|
"unk_token": null
|
||||||
|
}
|
||||||
1
vocab.json
Normal file
1
vocab.json
Normal file
File diff suppressed because one or more lines are too long
Reference in New Issue
Block a user