初始化项目,由ModelHub XC社区提供模型
Model: AnkitAI/Parable-Granite-4.1-8B-Claude-Fable-5
Source: Original Platform
This commit is contained in:
 ModelHub XC
35
.gitattributes
vendored
Normal file
35
.gitattributes
vendored
Normal file
@@ -0,0 +1,35 @@
|
||||
*.7z filter=lfs diff=lfs merge=lfs -text
|
||||
*.arrow filter=lfs diff=lfs merge=lfs -text
|
||||
*.bin filter=lfs diff=lfs merge=lfs -text
|
||||
*.bz2 filter=lfs diff=lfs merge=lfs -text
|
||||
*.ckpt filter=lfs diff=lfs merge=lfs -text
|
||||
*.ftz filter=lfs diff=lfs merge=lfs -text
|
||||
*.gz filter=lfs diff=lfs merge=lfs -text
|
||||
*.h5 filter=lfs diff=lfs merge=lfs -text
|
||||
*.joblib filter=lfs diff=lfs merge=lfs -text
|
||||
*.lfs.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.mlmodel filter=lfs diff=lfs merge=lfs -text
|
||||
*.model filter=lfs diff=lfs merge=lfs -text
|
||||
*.msgpack filter=lfs diff=lfs merge=lfs -text
|
||||
*.npy filter=lfs diff=lfs merge=lfs -text
|
||||
*.npz filter=lfs diff=lfs merge=lfs -text
|
||||
*.onnx filter=lfs diff=lfs merge=lfs -text
|
||||
*.ot filter=lfs diff=lfs merge=lfs -text
|
||||
*.parquet filter=lfs diff=lfs merge=lfs -text
|
||||
*.pb filter=lfs diff=lfs merge=lfs -text
|
||||
*.pickle filter=lfs diff=lfs merge=lfs -text
|
||||
*.pkl filter=lfs diff=lfs merge=lfs -text
|
||||
*.pt filter=lfs diff=lfs merge=lfs -text
|
||||
*.pth filter=lfs diff=lfs merge=lfs -text
|
||||
*.rar filter=lfs diff=lfs merge=lfs -text
|
||||
*.safetensors filter=lfs diff=lfs merge=lfs -text
|
||||
saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
||||
*.tar.* filter=lfs diff=lfs merge=lfs -text
|
||||
*.tar filter=lfs diff=lfs merge=lfs -text
|
||||
*.tflite filter=lfs diff=lfs merge=lfs -text
|
||||
*.tgz filter=lfs diff=lfs merge=lfs -text
|
||||
*.wasm filter=lfs diff=lfs merge=lfs -text
|
||||
*.xz filter=lfs diff=lfs merge=lfs -text
|
||||
*.zip filter=lfs diff=lfs merge=lfs -text
|
||||
*.zst filter=lfs diff=lfs merge=lfs -text
|
||||
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
||||
147
README.md
Normal file
147
README.md
Normal file
@@ -0,0 +1,147 @@
|
||||
---
|
||||
base_model: ibm-granite/granite-4.1-8b
|
||||
base_model_relation: finetune
|
||||
datasets:
|
||||
- Glint-Research/Fable-5-traces
|
||||
- Roman1111111/gpt5.5-terminal
|
||||
license: apache-2.0
|
||||
language:
|
||||
- en
|
||||
pipeline_tag: text-generation
|
||||
library_name: transformers
|
||||
tags:
|
||||
- safetensors
|
||||
- qlora
|
||||
- agentic
|
||||
- coding
|
||||
- reasoning
|
||||
- thinking
|
||||
- claude
|
||||
- granite
|
||||
---
|
||||
|
||||
# Parable-Granite-4.1-8B-Claude-Fable-5
|
||||
|
||||
<picture>
|
||||
<source media="(prefers-color-scheme: dark)" srcset="https://raw.githubusercontent.com/ankit-aglawe/parable-assets/main/parable_header_dark.png">
|
||||
<img alt="Parable" src="https://raw.githubusercontent.com/ankit-aglawe/parable-assets/main/parable_header.png">
|
||||
</picture>
|
||||
|
||||
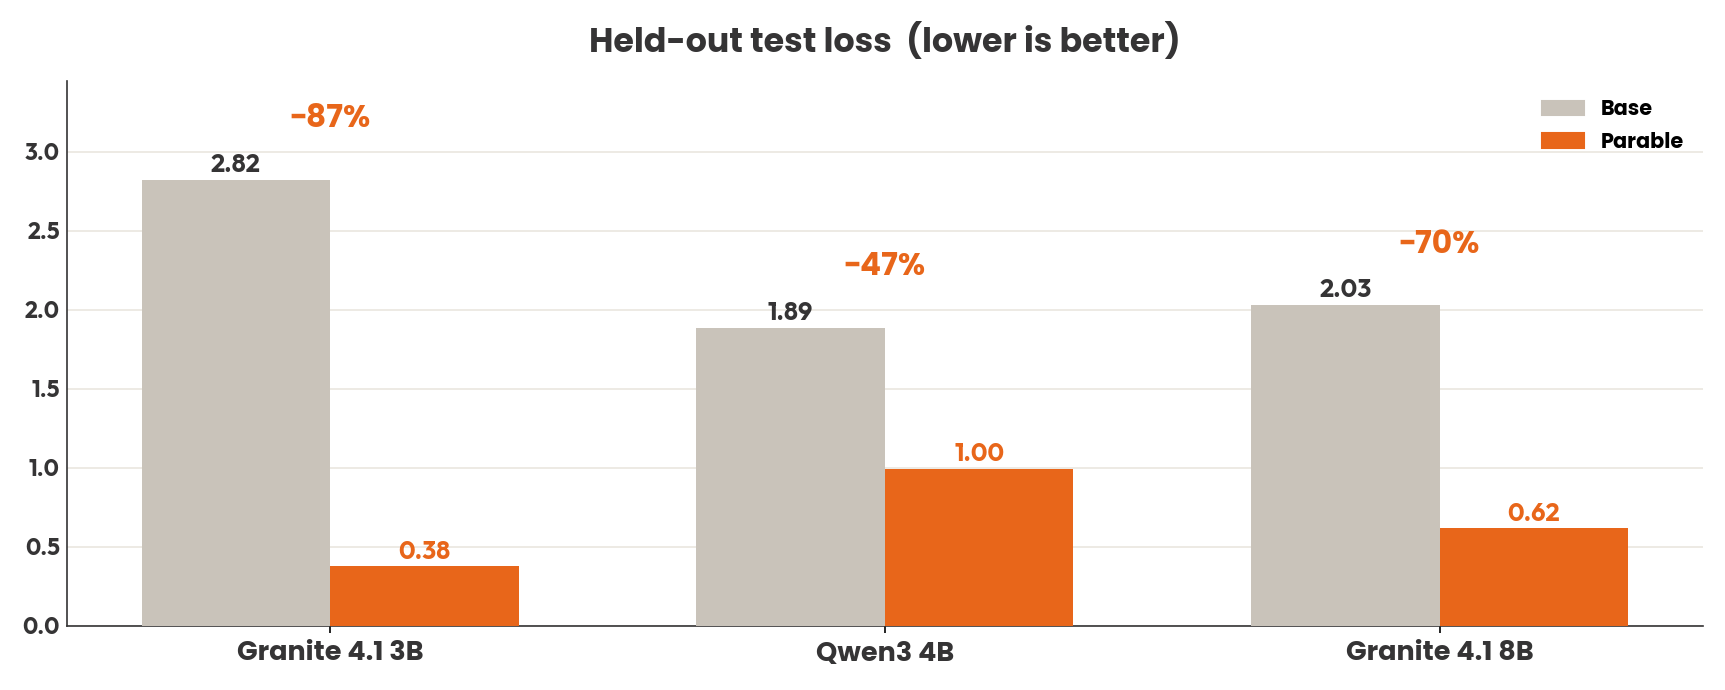
**Granite 4.1 8B trained on real Claude Fable 5 and GPT-5.5 agent traces: 70% lower held-out test loss than its base, and past the 0.71 mark the 9B-class incumbent reports on this data family.**
|
||||
|
||||
Parable-Granite-4.1-8B is an [ibm-granite/granite-4.1-8b](https://huggingface.co/ibm-granite/granite-4.1-8b) fine-tune trained on real multi-step agent sessions: planning, tool use, and `<think>` reasoning captured from actual Claude Fable 5 and GPT-5.5 agent work, not synthetic Q&A. Largest release in the Parable series, alongside [Parable-Qwen3-4B](https://huggingface.co/AnkitAI/Parable-Qwen3-4B-Claude-Fable-5-GGUF).
|
||||
|
||||
## Usage
|
||||
|
||||
```python
|
||||
from transformers import AutoModelForCausalLM, AutoTokenizer
|
||||
|
||||
model = AutoModelForCausalLM.from_pretrained(
|
||||
"AnkitAI/Parable-Granite-4.1-8B-Claude-Fable-5",
|
||||
torch_dtype="auto", device_map="auto")
|
||||
tok = AutoTokenizer.from_pretrained("AnkitAI/Parable-Granite-4.1-8B-Claude-Fable-5")
|
||||
|
||||
msgs = [{"role": "user", "content": "Write a Python function that retries an HTTP request with exponential backoff."}]
|
||||
ids = tok.apply_chat_template(msgs, add_generation_prompt=True, return_tensors="pt").to(model.device)
|
||||
out = model.generate(ids, max_new_tokens=3000, temperature=0.7, top_p=0.95, do_sample=True)
|
||||
text = tok.decode(out[0][ids.shape[1]:], skip_special_tokens=True)
|
||||
answer = text.split("</think>")[-1].strip() # response opens with a <think> block
|
||||
print(answer)
|
||||
```
|
||||
|
||||
GGUF quants for llama.cpp / Ollama / LM Studio: [Parable-Granite-4.1-8B-Claude-Fable-5-GGUF](https://huggingface.co/AnkitAI/Parable-Granite-4.1-8B-Claude-Fable-5-GGUF).
|
||||
|
||||
**Sampling:** temperature 0.7, top_p 0.95, generous max_new_tokens (at least 2500).
|
||||
|
||||
## Training data
|
||||
|
||||
- [Glint-Research/Fable-5-traces](https://huggingface.co/datasets/Glint-Research/Fable-5-traces): 4.4k real Claude Fable 5 coding-agent session traces with `<think>` reasoning and tool calls (AGPL-3.0)
|
||||
- [Roman1111111/gpt5.5-terminal](https://huggingface.co/datasets/Roman1111111/gpt5.5-terminal): terminal-agent task solutions (MIT)
|
||||
|
||||
Every example passed a quality gate (schema validation, secrets scrub, length filtering) before training. QLoRA fine-tune (NF4, sequence length 1024) trained on a single 16 GB GPU, quantized with [llama.cpp](https://github.com/ggml-org/llama.cpp).
|
||||
|
||||
## Evaluation
|
||||
|
||||
|
||||
|
||||
Held-out test split, identical evaluation code and context length for base and fine-tune:
|
||||
|
||||
| Metric | Base Granite-4.1-8B | Parable | Δ |
|
||||
|---|---|---|---|
|
||||
| Test loss | 2.030 | **0.617** | **−70%** |
|
||||
|
||||
**Qualitative review** (34 coding/terminal/debugging prompts, strictly graded by mentally executing every answer): **20/34 fully correct, 32/34 correct or partially correct.** We publish these numbers because strict qualitative grading is rare in this niche; judge accordingly.
|
||||
|
||||
For reference, the strongest published fine-tune on this data family (a 9B) reports 0.71 validation loss. Cross-repo numbers are indicative only: splits, tokenizers, and context lengths differ (ours is measured at 1,024 tokens).
|
||||
|
||||
### Function calling (BFCL V3, AST subset)
|
||||
|
||||
Measured 2026-07-29: bfcl-eval at gorilla main, prompting mode, Q4_K_M
|
||||
GGUFs served by llama.cpp on a T4, base and Parable under the identical
|
||||
harness. Categories: simple_python / multiple / parallel /
|
||||
parallel_multiple (400/200/200/200 items). Raw generations and score
|
||||
files: [parable-v2-artifacts](https://huggingface.co/AnkitAI/parable-v2-artifacts)
|
||||
under `verify/bfcl/`.
|
||||
|
||||
**DNF.** The run hit its 3-hour GPU budget: this chat variant's think
|
||||
blocks push most responses to the 4,096-token per-request cap, about 35
|
||||
GPU-hours of decode for the full suite at T4 speed, so it cannot
|
||||
complete under the same budget every other row got. We report that
|
||||
rather than tightening the token cap for one model. For function-calling harnesses, use the base model; the 3B sibling's
|
||||
card shows the measured pattern on these categories.
|
||||
|
||||
## Limitations
|
||||
|
||||
- Trained for agent work: on ops-style prompts it sometimes (2/34 in our eval) responds with structured tool-call JSON rather than prose. Useful inside agent harnesses; in plain chat, re-prompt or lower the temperature.
|
||||
- Fine-tuned at 1,024-token sequences; the base model's native 128K-token context remains fully available, so long sessions work, with the fine-tuned behavior strongest in the opening turns.
|
||||
|
||||
As a fine-tune it inherits Granite-4.1-8B's base behaviors and knowledge cutoff. As with any local model, treat generated commands and code as drafts to review.
|
||||
|
||||
## Provenance & licensing
|
||||
|
||||
Model weights: **Apache-2.0** (inherited from Granite-4.1-8B). Training data licenses: Fable-5-traces **AGPL-3.0**, gpt5.5-terminal **MIT**. Because those traces originate from third-party assistants, the providers' terms may apply to downstream training and distillation. If you plan to build on this model commercially, confirm your use aligns with those terms.
|
||||
|
||||
## Get Parable
|
||||
|
||||
| Platform | Command / Link |
|
||||
|---|---|
|
||||
| Ollama | `ollama run parable/granite4.1-fable:8b` |
|
||||
| Ollama (family flagship, best per size) | `ollama run parable/fable` |
|
||||
| Hugging Face | [GGUF quants, full weights, eval reports](https://huggingface.co/collections/AnkitAI/parable-6a4fac60f4b35afca3019621) |
|
||||
| LM Studio | `lms get parable/granite4.1-fable` ([parable on LM Studio Hub](https://lmstudio.ai/parable)) |
|
||||
|
||||
## Support the Project
|
||||
|
||||
If this model is useful in your work, you can support independent research:
|
||||
|
||||
<p align="left">
|
||||
<a href="https://www.buymeacoffee.com/AnkitAI" target="_blank"><img src="https://cdn.buymeacoffee.com/buttons/v2/default-yellow.png" alt="Buy Me a Coffee" height="60" width="217" /></a>
|
||||
</p>
|
||||
|
||||
## Citation
|
||||
|
||||
The recipe, evaluation methodology and failure analysis behind this model are
|
||||
documented in the tech report:
|
||||
|
||||
> Aglawe, A. (2026). *Agent-Trace Fine-Tuning of Small Language Models under
|
||||
> Constrained Compute.* Zenodo. [doi:10.5281/zenodo.21676407](https://doi.org/10.5281/zenodo.21676407)
|
||||
|
||||
```bibtex
|
||||
@misc{aglawe2026agenttrace,
|
||||
author = {Aglawe, Ankit},
|
||||
title = {Agent-Trace Fine-Tuning of Small Language Models under Constrained Compute},
|
||||
year = {2026},
|
||||
publisher = {Zenodo},
|
||||
doi = {10.5281/zenodo.21676407},
|
||||
url = {https://doi.org/10.5281/zenodo.21676407}
|
||||
}
|
||||
```
|
||||
|
||||
## Acknowledgements
|
||||
|
||||
- [Glint-Research](https://huggingface.co/Glint-Research) and [Roman1111111](https://huggingface.co/Roman1111111) for the open trace datasets
|
||||
- [IBM Granite](https://huggingface.co/ibm-granite) for the base model
|
||||
- [empero-ai](https://huggingface.co/empero-ai), whose Qwable recipe the Parable series follows
|
||||
- [llama.cpp](https://github.com/ggml-org/llama.cpp)
|
||||
|
||||
More on the Parable models: [ankitaglawe.com/parable](https://ankitaglawe.com/parable)
|
||||
102
banner.svg
Normal file
102
banner.svg
Normal file

File diff suppressed because one or more lines are too long
|
After Width: | Height: | Size: 721 KiB |
32
config.json
Normal file
32
config.json
Normal file
@@ -0,0 +1,32 @@
|
||||
{
|
||||
"architectures": [
|
||||
"GraniteForCausalLM"
|
||||
],
|
||||
"attention_bias": false,
|
||||
"attention_dropout": 0.0,
|
||||
"attention_multiplier": 0.0078125,
|
||||
"bos_token_id": 100257,
|
||||
"embedding_multiplier": 12.0,
|
||||
"eos_token_id": 100257,
|
||||
"hidden_act": "silu",
|
||||
"hidden_size": 4096,
|
||||
"initializer_range": 0.1,
|
||||
"intermediate_size": 12800,
|
||||
"logits_scaling": 16.0,
|
||||
"max_position_embeddings": 131072,
|
||||
"mlp_bias": false,
|
||||
"model_type": "granite",
|
||||
"num_attention_heads": 32,
|
||||
"num_hidden_layers": 40,
|
||||
"num_key_value_heads": 8,
|
||||
"pad_token_id": 100256,
|
||||
"residual_multiplier": 0.22,
|
||||
"rms_norm_eps": 1e-05,
|
||||
"rope_scaling": null,
|
||||
"rope_theta": 10000000,
|
||||
"tie_word_embeddings": true,
|
||||
"torch_dtype": "bfloat16",
|
||||
"transformers_version": "4.51.3",
|
||||
"use_cache": true,
|
||||
"vocab_size": 100352
|
||||
}
|
||||
7
generation_config.json
Normal file
7
generation_config.json
Normal file
@@ -0,0 +1,7 @@
|
||||
{
|
||||
"_from_model_config": true,
|
||||
"bos_token_id": 100257,
|
||||
"eos_token_id": 100257,
|
||||
"pad_token_id": 100256,
|
||||
"transformers_version": "4.51.3"
|
||||
}
|
||||
100001
merges.txt
Normal file
100001
merges.txt
Normal file
File diff suppressed because it is too large
Load Diff
3
model-00001-of-00004.safetensors
Normal file
3
model-00001-of-00004.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:bc3c3d50e8a5d6bdf88a4b1b7e489828401850052a9ced87f963084867f447a5
|
||||
size 4995591048
|
||||
3
model-00002-of-00004.safetensors
Normal file
3
model-00002-of-00004.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:791cb5d32785c31275d9780a9dc4202fb4e20332b3279a547416766318b8df6a
|
||||
size 4991447808
|
||||
3
model-00003-of-00004.safetensors
Normal file
3
model-00003-of-00004.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:98059a14b57532447fffcac86fee552f55eb72f9faf795514be5f98e10cc5259
|
||||
size 4970460032
|
||||
3
model-00004-of-00004.safetensors
Normal file
3
model-00004-of-00004.safetensors
Normal file
@@ -0,0 +1,3 @@
|
||||
version https://git-lfs.github.com/spec/v1
|
||||
oid sha256:8c30c10beac2e385619ff897e0290aedf48766f2477742b62495496f1ea811d4
|
||||
size 1803645576
|
||||
369
model.safetensors.index.json
Normal file
369
model.safetensors.index.json
Normal file
@@ -0,0 +1,369 @@
|
||||
{
|
||||
"metadata": {
|
||||
"total_size": 16761102336
|
||||
},
|
||||
"weight_map": {
|
||||
"model.embed_tokens.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.0.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.0.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.0.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.0.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.0.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.0.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.0.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.0.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.0.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.1.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.1.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.1.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.1.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.1.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.1.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.1.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.1.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.1.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.10.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.10.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.10.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.10.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.10.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.10.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.10.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.10.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.10.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.11.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.11.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.11.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.11.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.11.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.11.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.11.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.11.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.11.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.12.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.12.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.12.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.12.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.12.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.12.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.12.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.12.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.12.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.13.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.13.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.13.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.13.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.13.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.13.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.13.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.13.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.13.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.14.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.14.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.14.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.14.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.14.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.14.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.14.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.14.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.14.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.15.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.15.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.15.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.15.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.15.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.15.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.15.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.15.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.15.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.16.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.16.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.16.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.16.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.16.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.16.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.16.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.16.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.16.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.17.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.17.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.17.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.17.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.17.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.17.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.17.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.17.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.17.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.18.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.18.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.18.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.18.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.18.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.18.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.18.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.18.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.18.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.19.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.19.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.19.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.19.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.19.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.19.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.19.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.19.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.19.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.2.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.2.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.2.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.2.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.2.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.2.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.2.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.2.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.2.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.20.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.20.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.20.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.20.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.20.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.20.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.20.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.20.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.20.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.21.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.21.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.21.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.21.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.21.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.21.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.21.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.21.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.21.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.22.input_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.22.mlp.down_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.22.mlp.gate_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.22.mlp.up_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.22.post_attention_layernorm.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.22.self_attn.k_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.22.self_attn.o_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.22.self_attn.q_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.22.self_attn.v_proj.weight": "model-00002-of-00004.safetensors",
|
||||
"model.layers.23.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.23.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.23.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.23.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.23.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.23.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.23.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.23.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.23.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.24.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.24.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.24.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.24.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.24.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.24.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.24.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.24.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.24.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.25.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.25.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.25.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.25.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.25.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.25.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.25.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.25.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.25.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.26.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.26.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.26.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.26.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.26.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.26.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.26.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.26.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.26.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.27.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.27.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.27.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.27.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.27.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.27.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.27.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.27.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.27.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.28.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.28.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.28.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.28.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.28.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.28.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.28.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.28.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.28.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.29.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.29.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.29.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.29.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.29.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.29.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.29.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.29.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.29.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.3.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.3.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.3.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.3.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.3.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.3.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.3.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.3.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.3.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.30.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.30.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.30.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.30.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.30.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.30.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.30.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.30.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.30.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.31.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.31.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.31.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.31.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.31.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.31.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.31.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.31.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.31.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.32.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.32.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.32.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.32.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.32.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.32.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.32.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.32.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.32.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.33.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.33.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.33.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.33.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.33.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.33.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.33.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.33.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.33.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.34.input_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.34.mlp.down_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.34.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.34.mlp.up_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.34.post_attention_layernorm.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.34.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.34.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.34.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.34.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.35.input_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.35.mlp.down_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.35.mlp.gate_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.35.mlp.up_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.35.post_attention_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.35.self_attn.k_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.35.self_attn.o_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.35.self_attn.q_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.35.self_attn.v_proj.weight": "model-00003-of-00004.safetensors",
|
||||
"model.layers.36.input_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.36.mlp.down_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.36.mlp.gate_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.36.mlp.up_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.36.post_attention_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.36.self_attn.k_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.36.self_attn.o_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.36.self_attn.q_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.36.self_attn.v_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.37.input_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.37.mlp.down_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.37.mlp.gate_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.37.mlp.up_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.37.post_attention_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.37.self_attn.k_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.37.self_attn.o_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.37.self_attn.q_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.37.self_attn.v_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.38.input_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.38.mlp.down_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.38.mlp.gate_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.38.mlp.up_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.38.post_attention_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.38.self_attn.k_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.38.self_attn.o_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.38.self_attn.q_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.38.self_attn.v_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.39.input_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.39.mlp.down_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.39.mlp.gate_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.39.mlp.up_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.39.post_attention_layernorm.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.39.self_attn.k_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.39.self_attn.o_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.39.self_attn.q_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.39.self_attn.v_proj.weight": "model-00004-of-00004.safetensors",
|
||||
"model.layers.4.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.4.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.4.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.4.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.4.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.4.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.4.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.4.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.4.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.5.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.5.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.5.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.5.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.5.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.5.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.5.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.5.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.5.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.6.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.6.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.6.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.6.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.6.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.6.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.6.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.6.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.6.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.7.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.7.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.7.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.7.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.7.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.7.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.7.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.7.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.7.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.8.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.8.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.8.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.8.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.8.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.8.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.8.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.8.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.8.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.9.input_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.9.mlp.down_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.9.mlp.gate_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.9.mlp.up_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.9.post_attention_layernorm.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.9.self_attn.k_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.9.self_attn.o_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.9.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.layers.9.self_attn.v_proj.weight": "model-00001-of-00004.safetensors",
|
||||
"model.norm.weight": "model-00004-of-00004.safetensors"
|
||||
}
|
||||
}
|
||||
30
special_tokens_map.json
Normal file
30
special_tokens_map.json
Normal file
@@ -0,0 +1,30 @@
|
||||
{
|
||||
"bos_token": {
|
||||
"content": "<|end_of_text|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
},
|
||||
"eos_token": {
|
||||
"content": "<|end_of_text|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
},
|
||||
"pad_token": {
|
||||
"content": "<|pad|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
},
|
||||
"unk_token": {
|
||||
"content": "<|unk|>",
|
||||
"lstrip": false,
|
||||
"normalized": false,
|
||||
"rstrip": false,
|
||||
"single_word": false
|
||||
}
|
||||
}
|
||||
501264
tokenizer.json
Normal file
501264
tokenizer.json
Normal file
File diff suppressed because it is too large
Load Diff
784
tokenizer_config.json
Normal file
784
tokenizer_config.json
Normal file
File diff suppressed because one or more lines are too long
1
vocab.json
Normal file
1
vocab.json
Normal file
File diff suppressed because one or more lines are too long
Reference in New Issue
Block a user